GroundingPI 重現實測(初步結果):已完成 25 項,23 項與論文差距在 1 分以內
本站以官方權重、官方評測程式與官方計分方式單次執行 GroundingPI,目前完成 34 項中的 25 項。已完成項目的簡單平均為本站實測 72.50、論文自報 72.56,與論文一致;另有 9 項大型資料集仍在第二批執行中。
- 本站上線
- 2026/10/15 下午12:48
- 首次報導
- 2026/10/15 下午12:47
GroundingPI 是一個約 4B 參數(B 為十億)的視覺定位模型,主打依文字描述在圖片上畫框、點出位置,並涵蓋介面、文件與文字辨識等場景。本站依官方發布的評測套件做重現實測,目前完成 25 項、尚有 9 項在執行中,以下內容屬初步結果。分析一律把「本站實測」與「論文自報」分開呈現,並逐項比較。
重點
- 初步結果:評測項目總數 34 項,本站已完成 25 項,LVIS、RefCOCO 系列與視覺提示 COCO/LVIS 仍在第二批執行中。
- 已完成項目簡單平均:本站實測 72.50、論文自報 72.56,差距 -0.06,與論文一致。
- 25 項中有 23 項差距在 1 分以內,25 項全部在 3 分以內;本站高於論文超過 1 分與低於論文超過 1 分的各有 1 項,都在空間與機器人指向類別。
- 介面元素定位的 ScreenSpot-V2 本站實測 95.99;空拍小物件 VisDrone 偵測為 40.52、HierText 文字辨識為 41.67,屬於分數偏低的場景。
- 論文摘要的 73.68 是 11 項能力分數的平均,計算方式未完整公開,本站不以自身數字驗證或推翻,只做逐項比較。
- 本站首頁截圖示範中,「搜尋按鈕」框到旁邊的輸入框,其餘題目皆框對,中文提問也能正確定位。
GroundingPI 是什麼
GroundingPI 由 MoonViT-V2 視覺編碼器加上 Qwen3-4B 語言模型組成,模型卡標示約 4B 參數,輸出的框與點座標落在 0~999 的格點上,使用時需再換算回實際像素。本站測試的是 Hugging Face 上的官方權重 GroundingPI/GroundingPI,格式為 BF16(16 位元浮點格式,未經量化壓縮)。論文把評測分為 11 個能力類別,並與 44 個比較基準對照;本站只測 GroundingPI 本身,未重跑其他模型。
測試方法
- 測試對象:Hugging Face 上的官方權重 GroundingPI/GroundingPI(BF16,未量化),模型卡標示約 4B 參數(MoonViT-V2 視覺編碼器+Qwen3-4B 語言模型)。
- 評測程式:官方 GitHub(groundingpi/GroundingPI)固定在 2026-10-14 的版本(commit 0909324),用它內建的 34 項評測套件 groundingpi34、官方提示詞與官方計分程式,本站沒有改任何評測設定。
- 評測資料:官方打包的 Grounding-EvalData,下載後用官方工具逐檔核對 SHA-256 並完整解碼圖片與資料表,全部通過。
- 推論:官方指定的 vLLM 0.18.0 容器與官方啟動程式(BF16、eager 模式、溫度 0),兩張 NVIDIA RTX A6000(各 48 GB)各跑一個服務分擔請求。
- 與官方設定唯一的不同:官方服務一次只處理 1 個請求,本站正式測試改為同時處理 96 個以加快速度。開跑前本站用相同的 80 題做過比對:同樣一次處理 1 個請求重跑一次,就有 17 題的座標差 1 格(0~999 的格點);改成同時處理 16 個,有 15 題不同,差異同屬 1 格等級,兩種情況的分數完全相同。這是 GPU 運算本身的細微不確定性,也是論文取十次平均的原因。
- 本站只跑一次;論文的數字是十次平均(五個隨機種子各兩次)。
- 分數是官方計分程式的輸出,換算為 0~100。框類用 F1mIoU(預測框與正確框重疊程度在多個門檻下的 F1 平均,越高代表框得越準),指向用 F1@Point(點有沒有落在物件範圍內),介面與空間類用正確率。
結果總覽
| 能力 | 在測什麼 | 完成 | 本站平均 | 論文平均(同樣項目) | 差距 |
|---|---|---|---|---|---|
| 一般與長尾物件偵測 | 框出圖中所有指定類別的物件 | 1/2 | 63.00 | 62.98 | +0.02 |
| 密集與小物件偵測 | 物件又多又小的畫面 | 2/2 | 57.79 | 57.48 | +0.30 |
| 指代定位(框) | 依一句描述框出指定的那一個物件 | 2/6 | 87.10 | 87.09 | +0.01 |
| 物件指向(點) | 用一個點指出物件 | 5/7 | 82.36 | 82.52 | -0.15 |
| 空間與機器人指向 | 依空間關係指出位置,例如「把杯子放在盤子左邊」 | 4/4 | 74.86 | 75.02 | -0.16 |
| 介面元素定位 | 在螢幕截圖上找出要點的按鈕或欄位 | 3/3 | 78.70 | 78.92 | -0.22 |
| 文字辨識(OCR) | 找出圖中文字的位置並讀出內容 | 4/4 | 54.80 | 54.79 | +0.01 |
| 文件版面 | 框出文件中的標題、表格、圖片等區塊 | 2/2 | 79.90 | 79.95 | -0.05 |
| 視覺提示 | 給幾個範例框,找出圖中所有同類物件 | 2/4 | 66.66 | 66.71 | -0.05 |
本站使用官方 GitHub 固定在 2026-10-14 的版本(commit 0909324),以內建的 34 項評測套件 groundingpi34、官方提示詞與官方計分程式執行,評測設定未做任何修改;資料用官方工具逐檔核對 SHA-256(檔案雜湊校驗,用來確認檔案未損毀或被改動)並完整解碼,全部通過。已完成 25 項的簡單平均為本站實測 72.50、論文自報 72.56,差距 -0.06,與論文一致;其中 23 項差距在 1 分以內,25 項都在 3 分以內。論文另有 34 項簡單平均 74.61 與摘要平均 73.68 兩個數字,前者需等其餘 9 項完成才能對照,後者計算方式未完整公開,因此本站只做逐項比較。分數方面,框類用 F1mIoU(預測框與正確框在多個重疊門檻下的 F1 平均,越高代表框得越準),指向用 F1@Point(點是否落在物件範圍內),介面與空間類用正確率,皆換算為 0~100。
逐項對照
| 能力 | 評測 | 指標 | 本站實測 | 論文自報 | 差距 |
|---|---|---|---|---|---|
| 一般與長尾物件偵測 | COCO | F1mIoU | 63.00 | 62.98 | +0.02 |
| 一般與長尾物件偵測 | LVIS | — | (第二批執行中) | 56.02 | — |
| 密集與小物件偵測 | Dense200 | F1mIoU | 75.05 | 74.53 | +0.52 |
| 密集與小物件偵測 | VisDrone(空拍) | F1mIoU | 40.52 | 40.44 | +0.08 |
| 指代定位(框) | HumanRef | F1mIoU | 88.66 | 88.56 | +0.10 |
| 指代定位(框) | RefCOCOg 驗證集 | F1mIoU | 85.54 | 85.62 | -0.08 |
| 指代定位(框) | RefCOCOg 測試集 | — | (第二批執行中) | 84.36 | — |
| 指代定位(框) | RefCOCO | — | (第二批執行中) | 85.79 | — |
| 指代定位(框) | RefCOCOg(系列平均用) | — | (第二批執行中) | 81.96 | — |
| 指代定位(框) | RefCOCO+ | — | (第二批執行中) | 84.01 | — |
| 物件指向(點) | HumanRef | F1@Point | 88.63 | 88.79 | -0.16 |
| 物件指向(點) | RefCOCOg 驗證集 | F1@Point | 90.06 | 90.26 | -0.20 |
| 物件指向(點) | RefCOCOg 測試集 | — | (第二批執行中) | 90.06 | — |
| 物件指向(點) | COCO | F1@Point | 84.76 | 84.79 | -0.03 |
| 物件指向(點) | LVIS | — | (第二批執行中) | 79.51 | — |
| 物件指向(點) | Dense200 | F1@Point | 80.83 | 81.27 | -0.44 |
| 物件指向(點) | VisDrone | F1@Point | 67.53 | 67.47 | +0.06 |
| 空間與機器人指向 | RefSpatial 位置 | 正確率 | 75.00 | 76.00 | -1.00 |
| 空間與機器人指向 | RefSpatial 擺放 | 正確率 | 77.00 | 75.00 | +2.00 |
| 空間與機器人指向 | RefSpatial 未見過的情境 | 正確率 | 75.32 | 75.32 | +0.00 |
| 空間與機器人指向 | RoboSpatial | 正確率 | 72.13 | 73.77 | -1.64 |
| 介面元素定位 | ScreenSpot-V2 | 點擊正確率 | 95.99 | 96.15 | -0.16 |
| 介面元素定位 | ScreenSpot-Pro(專業軟體) | 點擊正確率 | 65.46 | 65.78 | -0.32 |
| 介面元素定位 | OSWorld-G | 正確率 | 74.65 | 74.82 | -0.17 |
| 文字辨識(OCR) | HierText | F1mIoU(文字寬鬆比對) | 41.67 | 41.70 | -0.03 |
| 文字辨識(OCR) | ICDAR2015 | F1mIoU(文字寬鬆比對) | 55.69 | 55.68 | +0.01 |
| 文字辨識(OCR) | TotalText(彎曲文字) | F1mIoU(文字寬鬆比對) | 49.33 | 49.32 | +0.01 |
| 文字辨識(OCR) | SROIE(收據) | F1mIoU(文字寬鬆比對) | 72.51 | 72.47 | +0.04 |
| 文件版面 | DocLayNet | F1mIoU | 85.07 | 85.08 | -0.01 |
| 文件版面 | M6Doc | F1mIoU | 74.72 | 74.82 | -0.10 |
| 視覺提示 | FSC147(計數) | F1mIoU | 58.07 | 57.99 | +0.08 |
| 視覺提示 | Dense200 | F1mIoU | 75.25 | 75.43 | -0.18 |
| 視覺提示 | COCO | — | (第二批執行中) | 82.62 | — |
| 視覺提示 | LVIS | — | (第二批執行中) | 78.32 | — |
一般與長尾物件偵測 此類別目前只完成 COCO(常見物件偵測資料集)一項,本站實測 63.00、論文自報 62.98,差距 0.02,與論文一致。另一項 LVIS(涵蓋大量罕見類別的長尾資料集)仍在第二批執行中,完成項目為 1/2,類別層級的結論需等資料補齊。
密集與小物件偵測 Dense200(物件密集場景)本站實測 75.05、論文自報 74.53,差距 0.52;VisDrone(空拍)本站實測 40.52、論文自報 40.44,差距 0.08,兩項都與論文一致。類別平均為本站 57.79、論文 57.48,平均差距 0.30。從分數本身來看,空拍視角下的小物件偵測仍是這個模型相對吃力的場景。
指代定位(框) 指代定位是依一句文字描述框出特定物件,例如「穿紅衣服的人」。HumanRef 本站實測 88.66、論文自報 88.56,差距 0.10;RefCOCOg 驗證集本站實測 85.54、論文自報 85.62,差距 -0.08,皆與論文一致。類別平均本站 87.10、論文 87.09,平均差距 0.01,但目前只完成 2/6 項,RefCOCO 系列其餘項目仍在執行中。
物件指向(點) 此類別要求模型用一個點標出目標,已完成 5/7 項,類別平均本站實測 82.36、論文自報 82.52,平均差距 -0.15。各項差距都在 1 分以內,例如 RefCOCOg 驗證集為 90.06 對 90.26(差距 -0.20)、Dense200 為 80.83 對 81.27(差距 -0.44),皆與論文一致。VisDrone 本站實測 67.53,與框類的 40.52 相比,用點標示空拍物件的成績明顯較高。
空間與機器人指向 此類別 4 項全數完成,類別平均本站實測 74.86、論文自報 75.02,平均差距 -0.16。RefSpatial 未見過的情境為 75.32 對 75.32(差距 0.00),RefSpatial 位置為 75.00 對 76.00(差距 -1.00),兩者與論文一致。RefSpatial 擺放本站實測 77.00、論文自報 75.00(差距 2.00),RoboSpatial 本站實測 72.13、論文自報 73.77(差距 -1.64),是本次唯二差距超過 1 分的項目,一高一低,可能與單次執行的波動有關,需多次重跑才能確認。
介面元素定位 GUI(圖形使用者介面)元素定位是依描述在截圖上找出按鈕、輸入框等元件,3 項全數完成,類別平均本站實測 78.70、論文自報 78.92,平均差距 -0.22。ScreenSpot-V2 為 95.99 對 96.15、ScreenSpot-Pro(專業軟體)為 65.46 對 65.78、OSWorld-G 為 74.65 對 74.82,全部與論文一致。一般介面的分數很高,但換到元件密集的專業軟體畫面,成績明顯下降。
文字辨識(OCR) OCR(光學文字辨識,把圖片中的文字找出並轉成文字)4 項全數完成,類別平均本站實測 54.80、論文自報 54.79,平均差距 0.01。HierText 為 41.67 對 41.70、ICDAR2015 為 55.69 對 55.68、TotalText(彎曲文字)為 49.33 對 49.32、SROIE(收據)為 72.51 對 72.47,皆與論文一致。HierText 有 0.06% 的輸出無法被計分程式解析,比例很低;整體而言收據這類版式固定的文件表現較好,自然場景與彎曲文字則偏弱。
文件版面 文件版面分析是框出標題、段落、表格、圖片等區塊,2 項全數完成。DocLayNet 本站實測 85.07、論文自報 85.08,M6Doc 本站實測 74.72、論文自報 74.82,皆與論文一致。類別平均本站 79.90、論文 79.95,平均差距 -0.05。
視覺提示 視覺提示是先用框或點示範要找的東西,再讓模型找出圖中同類物件,目前完成 2/4 項。FSC147(計數)本站實測 58.07、論文自報 57.99,Dense200 本站實測 75.25、論文自報 75.43,皆與論文一致。類別平均本站 66.66、論文 66.71,平均差距 -0.05;COCO 與 LVIS 兩項仍在第二批執行中。
實際操作:用本站首頁截圖測試
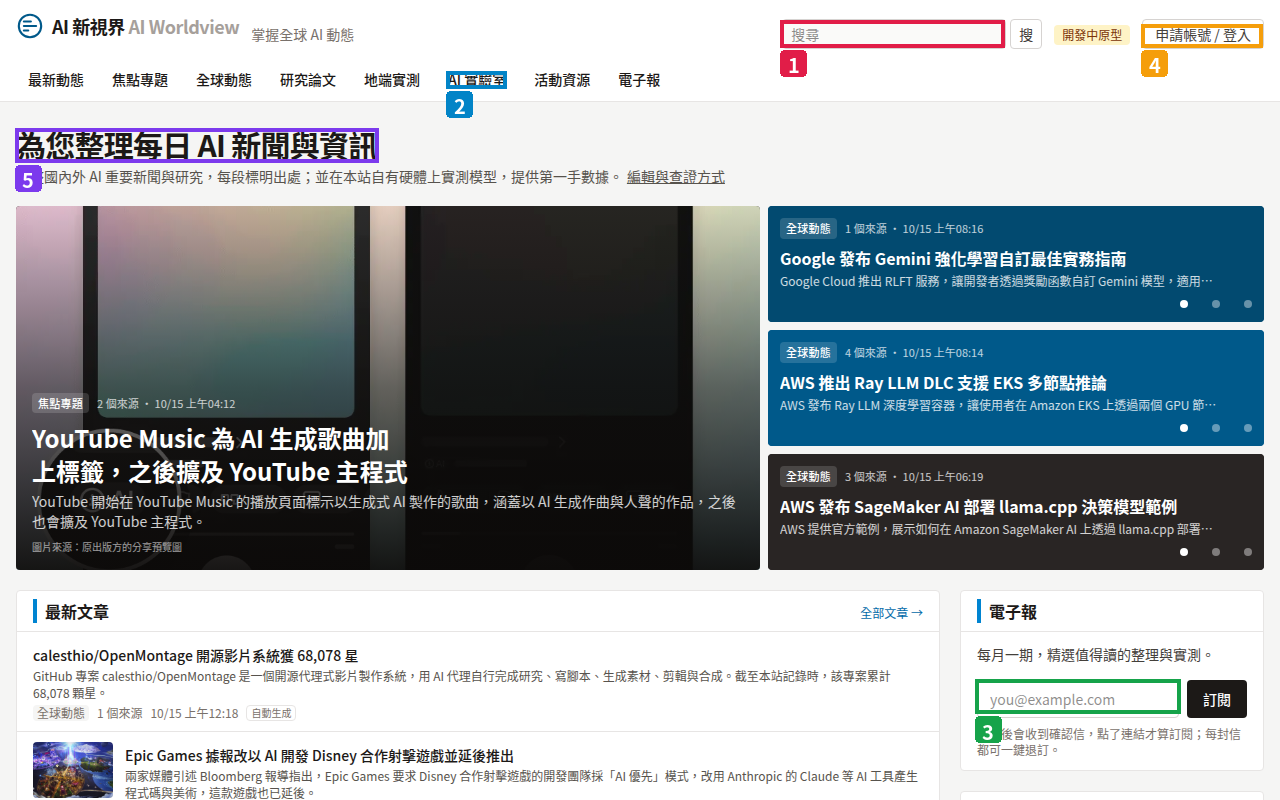
- 1. 「搜尋按鈕」:框住了旁邊的搜尋輸入框,沒有框到右側的「搜」按鈕本身;同一個問題在改版前的首頁截圖上則有框對
- 2. 「導覽列上的「AI 實驗室」連結」:正確,框在「AI 實驗室」連結上(中文提問)
- 3. 「訂閱電子報的 Email 輸入框」:正確,框在電子報的 Email 輸入框上(中文提問)
- 4. 「申請帳號/登入按鈕」:正確,框在「申請帳號/登入」按鈕上
- 5. 「首頁大標題」:正確,框住首頁大標題
本站另以自家首頁截圖做 5 題實際示範,「導覽列上的『AI 實驗室』連結」與「訂閱電子報的 Email 輸入框」都以中文提問並正確框出,「申請帳號/登入按鈕」與「首頁大標題」也都框對。唯一失誤是「搜尋按鈕」:模型框住了旁邊的搜尋輸入框,沒有框到右側的「搜」按鈕本身,而同一個問題在改版前的首頁截圖上是框對的。這顯示相鄰且功能相關的元件容易混淆,介面改版也可能影響結果;示範題數很少,只能當作使用情境的參考,不能代表整體表現。
限制
這是初步結果:34 項中目前完成 25 項,LVIS、RefCOCO 系列與視覺提示 COCO/LVIS 等 9 項大型資料集仍在執行,類別結論可能隨後調整。本站只跑一次,論文是十次平均(五個隨機種子各兩次),因此差距在 1 分以內一律視為與論文一致。與官方設定唯一的不同是本站把同時處理的請求數從 1 個改為 96 個;開跑前用相同 80 題比對,一次處理 1 個請求重跑就有 17 題座標差 1 格(0~999 格點),同時處理 16 個有 15 題不同,兩種情況分數完全相同,屬 GPU 運算本身的細微不確定性。推論採用官方指定的 vLLM(開源模型推論服務框架)0.18.0 容器、BF16、eager 模式、溫度 0(關閉隨機取樣),硬體為兩張 NVIDIA RTX A6000(各 48 GB);測試資料皆為公開評測集,與實際業務畫面仍有落差,本站也未重跑論文的 44 個比較基準。
結論
就已完成項目來看,這個 4B 模型適合用在一般 GUI 元素定位(ScreenSpot-V2 本站實測 95.99)、依文字描述框選或點選物件(指代定位與物件指向類別平均分別為 87.10 與 82.36),以及文件版面分析;空拍小物件偵測、自然場景文字辨識與專業軟體介面則成績偏低,不宜直接期待高準確度。論文成績在本站大致可以重現:25 項中 23 項差距在 1 分以內、全部在 3 分以內,已完成項目簡單平均與論文一致,但摘要的 73.68 無法由本站驗證,其餘 9 項也仍待補齊。導入前建議用自家畫面實測,尤其留意相鄰元件混淆與介面改版的影響,並處理 0~999 格點到實際像素的換算,同時固定模型與推論框架版本,接受座標偶有 1 格差異的運算不確定性。
授權與資料
- 模型:GroundingPI 原創部分採 Apache 2.0;模型中來自 Kimi K3 的部分適用 Kimi K3 License(Copyright (c) 2026 Moonshot AI)。
- 評測資料:官方 Grounding-EvalData 僅供學術評測,各資料集保留原始授權;本站只公開分數,不轉載資料集圖片。示範圖為本站自己的網頁截圖。
- 論文:GroundingPI(arXiv:2609.39601)。本站逐項成績:原始分數 JSON。
測試與撰寫:本站以官方評測程式量測;表格與圖表由程式從評測輸出填入,分析段落由 Claude 依數據撰寫並經程式核對數字,未經人工審閱。發現錯誤請回報。
來源 4 筆
這篇對你有用嗎?
登入會員後可以按反應與留言。登入
留言 0
- 還沒有留言。
留言公開顯示暱稱,不顯示你的真實姓名與信箱。含多個連結或疑似廣告的留言會先經編輯確認;檢舉達 3 次的留言會自動隱藏。隱私政策
發現錯誤?
回報會進入待處理清單;核實後更正,並在文中註記更正紀錄。