代理人記憶怎麼設計?六種做法、兩組資料的實測
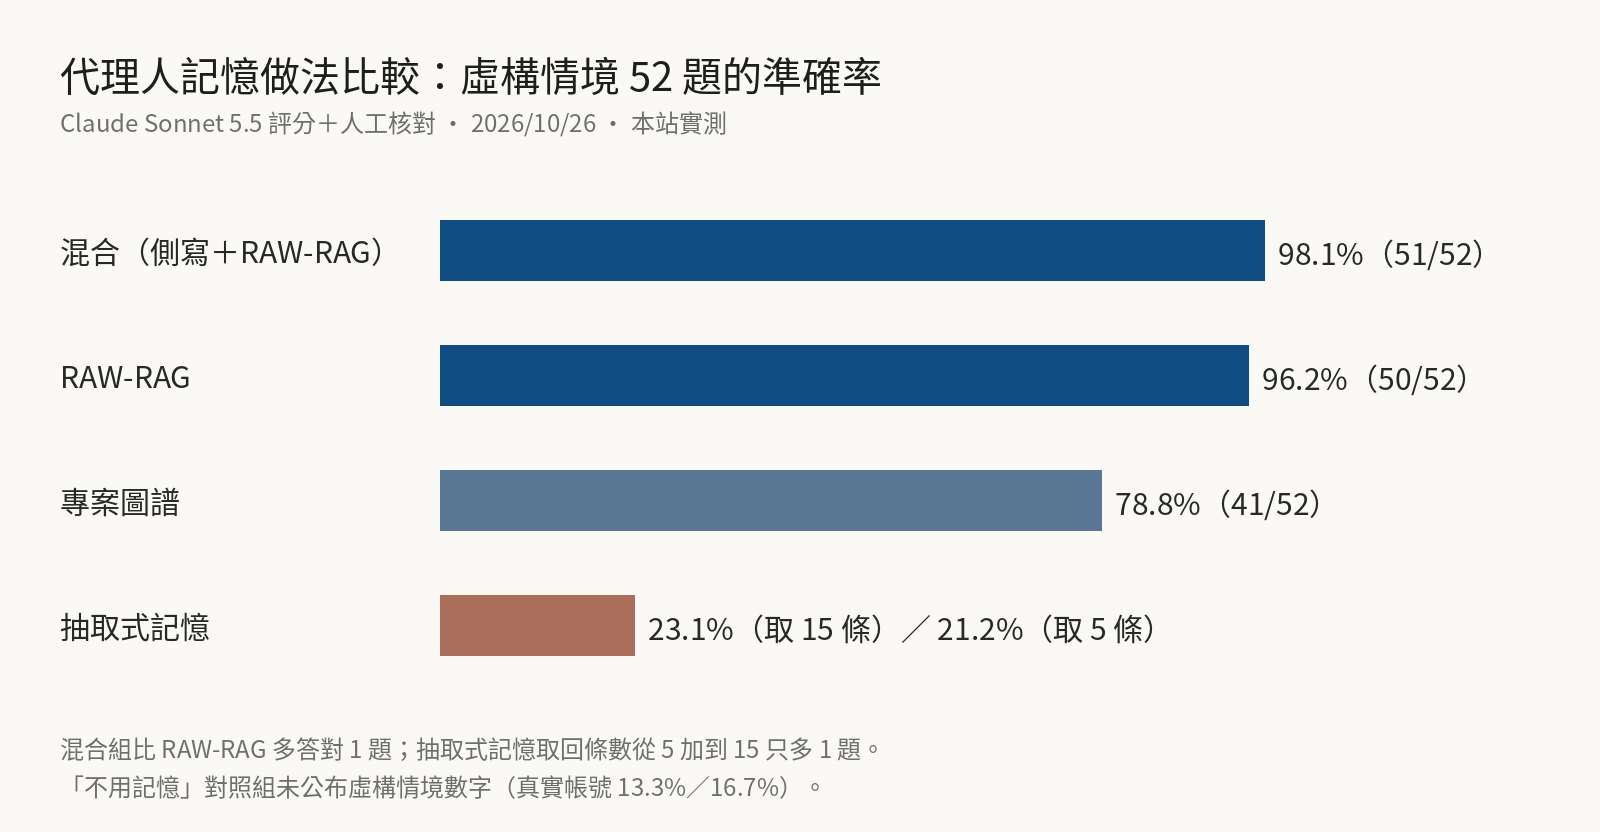
原始對話切塊、向量檢索再重排序的 RAW-RAG 在 52 題情境測驗拿到 96.2%,抽取式記憶只有 21–23%,知識圖譜 78.8%;兩個真實帳號方向相同。
本文重點
- 實測顯示 RAW-RAG 在 52 題測驗準確率達 96.2%。
- 抽取式記憶僅 21–23%,知識圖譜為 78.8%。
- RAW-RAG 每題檢索延遲約 6–9 秒,成本較高。
- 本站上線
- 2026/10/26 下午04:22
結論先講
把原始對話切塊、向量檢索再重排序(RAW-RAG),在我們 52 題的情境測驗拿到 96.2%;先由模型抽取成「記憶條目」的精緻做法只有 21–23%,知識圖譜 78.8%。兩個真實帳號的驗證結果方向相同:RAW-RAG 94% 上下,圖譜 55% 上下。
這次實測的起點,是 2026 年 10 月一篇 RAW-RAG 論文(arXiv 2610.30755)。論文主張:代理人的長期記憶不需要抽取、摘要、圖譜這類複雜架構,保留原始對話、檢索做好就夠了。我們自己的代理人平台正好同時用了兩種「複雜架構」:TencentDB 的分層記憶(抽取記憶條目+使用者側寫)和每個帳號一張專案圖譜。與其爭論,不如在自己的硬體上、用自己的使用情境量一次。
這篇寫給正在設計代理人記憶的人:怎麼測、量到什麼、哪裡會出錯,以及我們接下來打算怎麼改。
怎麼測
測試的對話不是人工寫好的逐字稿,而是讓平台上真的代理人去做事:寫檔案、算報價、改程式,對話和工具紀錄全部留下來,再拿來考記憶。
虛構情境(可公開全部題目與答案)
- 虛構公司「森川自動化」的業務兼專案經理,帶三個客戶:台岳鋼鐵(天車防撞、鋼胚計數)、宏碩光電(面板瑕疵 PoC,後談量產)、北辰食品(包裝線計數)。
- 25 段對話,模擬 2026/8/25 到 10/20 兩個月的工作:報價改版、交期延後兩次、驗收門檻提高、DXF 轉檔工具出錯又修好、週報、追加報價。
- 代理人跑完後的完整歷史約 15.2 萬 token,已超過作答模型 13.1 萬的上下文上限。
- 52 題,分八個應用情境:
| 情境 | 題數 | 在考什麼 | 例題 |
|---|---|---|---|
| 精確數字 | 8 | 一個數字一個字都不能錯 | 天車防撞的合約編號是多少? |
| 決定改過 | 8 | 要答最新的,不是最早的 | 交期最後是哪天?改過幾次? |
| 跨對話彙總 | 7 | 答案散在多段對話 | 我總共出過幾份報價? |
| 使用者偏好 | 5 | 做事時自動套用民國年、未稅加稅、稱職稱 | 幫我寫宏碩量產報價摘要 |
| 做法回顧 | 6 | 上次怎麼解決的 | DXF 讀不進來那次怎麼修的? |
| 找檔案 | 6 | 完整路徑 | 第二版報價存在哪? |
| 相似但不同 | 8 | 同客戶、同型式的兩個案子不能混 | 鋼胚計數用幾支攝影機? |
| 沒發生過 | 4 | 該說「沒有紀錄」就不要編 | 北辰的合約編號是多少? |
真實資料(只公開數字):兩個實際使用中的帳號,A 帳號 15 題、B 帳號 18 題,題目從各自的真實歷史出,每題附原文出處。B 帳號歷史約 18.9 萬 token。
受測的記憶方式(作答模型、題目、提示詞全部相同,只換「記憶」這一段內容):
| 做法 | 送進模型的記憶 | 對應的設計思路 |
|---|---|---|
| 不用記憶 | 無 | 對照組 |
| RAW-RAG | 原始對話(含工具輸入輸出)切 256 token、重疊 32;Qwen3-Embedding-4B 取 128 塊,Qwen3-Reranker-4B 重排取 15 塊,依時間排序 | 照論文參數 |
| 抽取式記憶(取 5 條) | TencentDB 的使用者側寫+檢索最相關 5 條記憶條目 | 我們平台線上的預設 |
| 抽取式記憶(取 15 條) | 同上,改取 15 條 | 排除「只是取太少」 |
| 專案圖譜 | 圖譜搜尋最相關 5 頁,整頁讀入 | 我們平台線上的專案圖譜 |
| 混合 | 使用者側寫(≤ 3000 字)+ RAW-RAG | 兩者互補 |
「整份歷史直接塞進去」本來是第七組,但兩份較長的歷史都超過模型上限,只在 A 帳號(約 4.3 萬 token)跑得動。
作答與評分:作答模型是平台本地部署的 Qwen3.8-Flash-Next(llama.cpp,溫度 0,關閉思考),檢索模型跑在一張 RTX A6000。評分由 Claude Sonnet 5.5 對照標準答案判「對/錯」;「沒發生過」的題只有回答「沒有紀錄」才算對。每組評分後我們再人工核對錯題與抽樣的對題。
結果
保留原文、檢索做好的 RAW-RAG 是準確率最高的單一做法;把它和使用者側寫合併(混合)再多拿回 1 題。
抽取式記憶的問題不在「取太少」:把每次取回的條目從 5 條加到 15 條,只從 21.2% 升到 23.1%。整整兩個月、25 段對話,它只留下 16 條記憶條目,問到的事大多根本沒被記下來。
拆開看,抽取式記憶唯一及格的情境是「使用者偏好」:「報價寫未稅、日期用民國年」這種一句話就能講完的規則,正是它擅長的。專案圖譜在做法回顧、相似但不同表現不錯,但跨對話彙總只有 43%:一頁只講一個實體,要湊齊「所有客戶」「所有報價」就得剛好搜到每一頁。
真實帳號的驗證(題目來自實際工作紀錄,只公開數字):
| 做法 | A 帳號(15 題,歷史約 4.3 萬 token) | B 帳號(18 題,約 18.9 萬 token) |
|---|---|---|
| RAW-RAG | 93.3% | 94.4% |
| 混合 | 93.3% | 94.4% |
| 整份歷史直接塞進去 | 93.3% | 超過模型上限,無法執行 |
| 專案圖譜 | 53.3% | 55.6% |
| 不用記憶 | 13.3% | 16.7% |
抽取式記憶沒有列入真實帳號比較:兩個帳號接上 TencentDB 只有三四天,幾個月的歷史大多不在裡面,比下去不公平。
成本:RAW-RAG 每題平均送進模型約 3,800 token,比抽取式多一倍多,但仍只有整份歷史的 2.5%。代價是延遲:在一張 RTX A6000 上重排 128 塊,每題檢索約 6–9 秒;抽取式與圖譜都在 0.1 秒內。建索引很便宜,18.9 萬 token 的歷史切成 843 塊,向量化 31 秒。
錯在哪裡
三種做法的錯法完全不同:抽取式記憶是「沒記下來」,圖譜是「摘要時丟了細節」,RAW-RAG 是「拿對了資料、讀錯了重點」。
抽取式記憶:大部分的事根本沒記
- 25 段對話只抽出 16 條記憶,而且集中在前半。合約編號、第二次交期延後(11/29 → 12/6)、DXF 工具的兩次修正都不在裡面,問到交期只能答出過時的 11/29。
- 好幾條記的是「計畫」而不是「結果」,例如「下一步需要將報價草稿寫入……」,之後真正寫了什麼、金額多少沒有跟上。
- 16 條裡有 6 條是簡體字,而對話全是繁體。抽取用的模型會把語言一起「改寫」掉。
- 它做得好的是使用者側寫:一份 2,000 多字的工作守則、偏好清單,讓「幫我寫報價摘要」這類題自動套用民國年與未稅加稅。
專案圖譜:摘要會丟掉「路徑」和「理由」
- 問報價檔存在哪,圖譜頁只留了檔名 quote-v1.md,完整路徑在摘要時被省略。
- 交期改過幾次答對了,但第一次延後的原因(天車大修)沒寫進任何一頁。
- 「我手上有哪些客戶」只列了兩個、「已成交的案子」只列了一個:搜尋取 5 頁,剩下的實體就看不到。
RAW-RAG:錯的只有 2 題,都是作答模型的問題
- 「我手上有哪些案子」:三個客戶都對,但把北辰的「包裝線計數」寫成「IP65 照明與支架選型」,那是該案一個待辦事項。混合組也錯在同一個地方。
- 重寫鋼胚報價金額:數字全對,但沒有自動寫民國年日期。混合組因為多了使用者側寫就寫了,這就是混合多拿的那 1 題。
意外的教訓:我們的標準答案錯了 4 題
第一輪評分時,RAW-RAG 有幾題「錯得很有自信」:它說鋼胚報價未稅 731,000,標準答案是 646,000;它說鋼胚案交期 115/12/15,標準答案是「沒有紀錄」。回去翻原始對話,是代理人在寫報價時自己加了一台 85,000 的工業電腦、自己沿用了一個交期,還把客戶說的「量產門檻 98.5%」一併改進 PoC 計畫書。這些都「真的發生過」,只是不在我們寫的劇本裡。
我們依原始紀錄修正了 4 題的標準答案後重新評分,上面的數字都是修正後的。這件事本身就是最好的證據:代理人會自己做假設、自己補細節,這些「沒人說過、但寫進了文件」的事,只有保留原文的記憶能答對。
給設計代理人記憶的人
先存原文、用好的檢索去找,再在前面加一份短的使用者側寫;其他精緻架構都當配角。
1. 原文一定要留。 對話加上工具的輸入輸出都存下來。代理人自己做的假設、寫進檔案的數字,往往只出現在工具紀錄裡;摘要和抽取都會漏。原文也是日後重建任何記憶的唯一來源。
2. 預設檢索用 RAW-RAG。 256 token 切塊、重疊 32,向量檢索取 128 塊、重排序留 15 塊,依時間排回去。地端用兩個 4B 模型、一張 48GB 卡就跑得動。
3. 加一份短的使用者側寫。 偏好和規範是抽取式記憶唯一贏的地方,放在 RAW-RAG 前面的混合組是全場最高分。側寫控制在幾千字內,不要拿來裝事實。
4. 圖譜是給人看的,不是給模型答題的。 它適合看專案全貌、人與案子的關係;問數字、路徑、彙總時,不要讓它單獨回答。
5. 留意延遲。 重排 128 塊每題要 6–9 秒。可以減少候選數,或改成代理人需要回想時才呼叫的工具,而不是每一輪都檢索。
6. 自己測,而且用真代理人跑。 劇本要讓代理人真的做事,標準答案從實際紀錄出,不要從劇本出;請代理人改過的「設定」本身就是最難記的部分。
我們自己的下一步:在平台加上 RAW-RAG 索引、作為預設的記憶檢索;TencentDB 只留使用者側寫;專案圖譜繼續當瀏覽工具。
限制
這是一個小規模、單一情境的實測,結論的方向可信,個位數的差距不要過度解讀。
- 題數少:52 題裡錯 1 題就是 1.9 個百分點,混合與 RAW-RAG 只差 1 題。
- 只用了一個作答模型;評分用 Claude Sonnet 5.5(論文用 GPT-4o-mini)。所有錯題和 12 題抽樣的對題都人工核對過。
- 抽取式記憶用的是我們平台的線上設定,不是調校後的最佳狀態;換抽取模型或抽取頻率,結果可能不同。
- 劇本由代理人實際執行,同一份劇本再跑一次,歷史會不一樣。
- 「整份歷史直接塞進去」只在最短的帳號跑成,長上下文模型的表現不在這次範圍。
參考資料
來源:佐證 0 筆,另有背景參考 3 筆
背景參考正文沒有引用,只是相關背景,不計入佐證數
- arxiv.org · RAW-RAG 論文,arXiv 2610.30755
- huggingface.co · Qwen3-Embedding-4B
- huggingface.co · Qwen3-Reranker-4B
這篇對你有用嗎?
登入會員後可以按反應與留言。登入
留言 0
- 還沒有留言。
留言公開顯示暱稱,不顯示你的真實姓名與信箱。含多個連結或疑似廣告的留言會先經編輯確認;檢舉達 3 次的留言會自動隱藏。隱私政策
發現錯誤?
回報會進入待處理清單;核實後更正,並在文中註記更正紀錄。