gpu-unlock 實測:RTX 3090 BF16 吞吐翻倍,但需手動修正載入順序
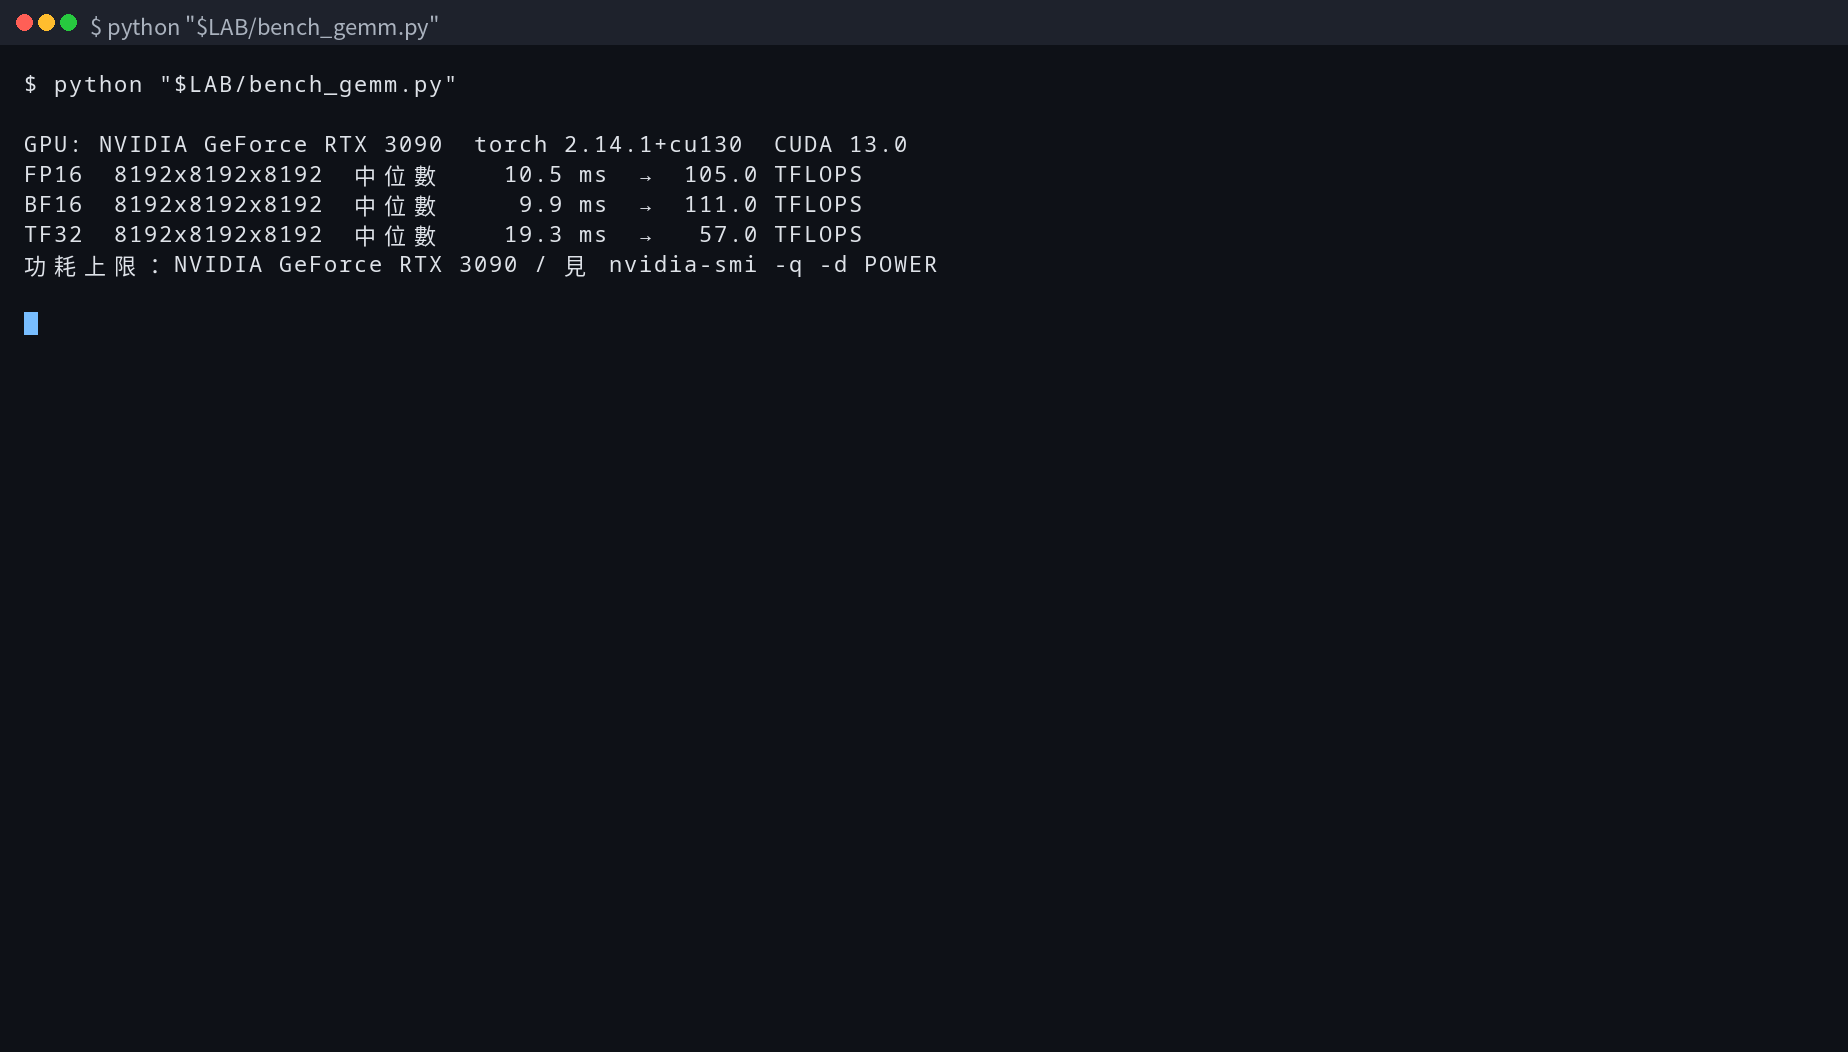
gpu-unlock 讓 RTX 3090 的 BF16 運算速度從 56.1 提升至 111.0 TFLOPS,但 Ubuntu 24.04 預設載入順序會導致失敗,需手動設定 softdep 才能生效。
本文重點
- gpu-unlock 讓 RTX 3090 的 BF16 運算速度從 56.1 提升至 111.0 TFLOPS。
- Ubuntu 24.04 預設載入順序會導致失敗,需手動設定 softdep 才能生效。
- 使用者需具備 Linux 核心模組知識,自行處理模組載入順序問題。
- 本站上線
- 2026/10/26 下午03:01
Zagitta/gpu-unlock 是 GitHub 上的開源專案,本站記錄時 7,109 星;10/24 起 LocalLLaMA 與多家媒體報導,RTX 3090 BF16 吞吐近翻倍。我們在一台 RTX 3090 24 GB 桌機 上,從安裝到跑出結果整段錄下終端機;測的是 2026-10-24 的版本(commit af28cbbfd3d9)。實測影片公開後會嵌在本文最下方。
背景
NVIDIA 在 GeForce 30 系列顯示卡(GA102 至 GA106)上,將 FP16 與 BF16 的指令發出率限制為專業卡的一半。這意味著同樣的硬體,在執行 AI 模型推論或訓練時,理論上的矩陣運算速度被鎖住。
gpu-unlock 是一個 Linux 核心模組,它利用 CMP 解鎖器的技術,在 NVIDIA 驅動程式綁定顯示卡之前,直接寫入速度選擇器(Speed Selectors)來解除這個限制。這種方法不需要修改 VBIOS,也不需要每次 NVIDIA 更新驅動時都重新打補丁,理論上能直接釋放被鎖住的效能。
運作方式與使用方式
安裝過程主要分為三個階段:下載編譯、設定開機參數、以及處理模組載入順序。
首先,透過 git clone 取得專案原始碼,執行 make install 將核心模組安裝到系統中。接著,必須修改 GRUB 設定,在 /etc/default/grub 的 GRUB_CMDLINE_LINUX_DEFAULT 中加入 gpu_unlock.targets=all,並執行 sudo update-grub,確保開機時核心參數正確傳遞。
關鍵步驟在於確保 gpu_unlock 模組比 nvidia 驅動程式更早載入。在我們的 Ubuntu 24.04 環境中,預設的 initramfs 會先載入 nvidia 驅動,導致解鎖失敗。我們透過建立 /etc/modprobe.d/gpu-unlock-order.conf 檔案,加入 softdep nvidia pre: gpu_unlock 指令,並執行 sudo update-initramfs -u -k all 重建 initramfs,強制系統在載入 nvidia 前先載入 gpu-unlock。
與未使用時的差異
| 情境 | 不用它 | 用它 |
|---|---|---|
| RTX 3090 BF16 GEMM 吞吐 | 56.1 TFLOPS | 111.0 TFLOPS |
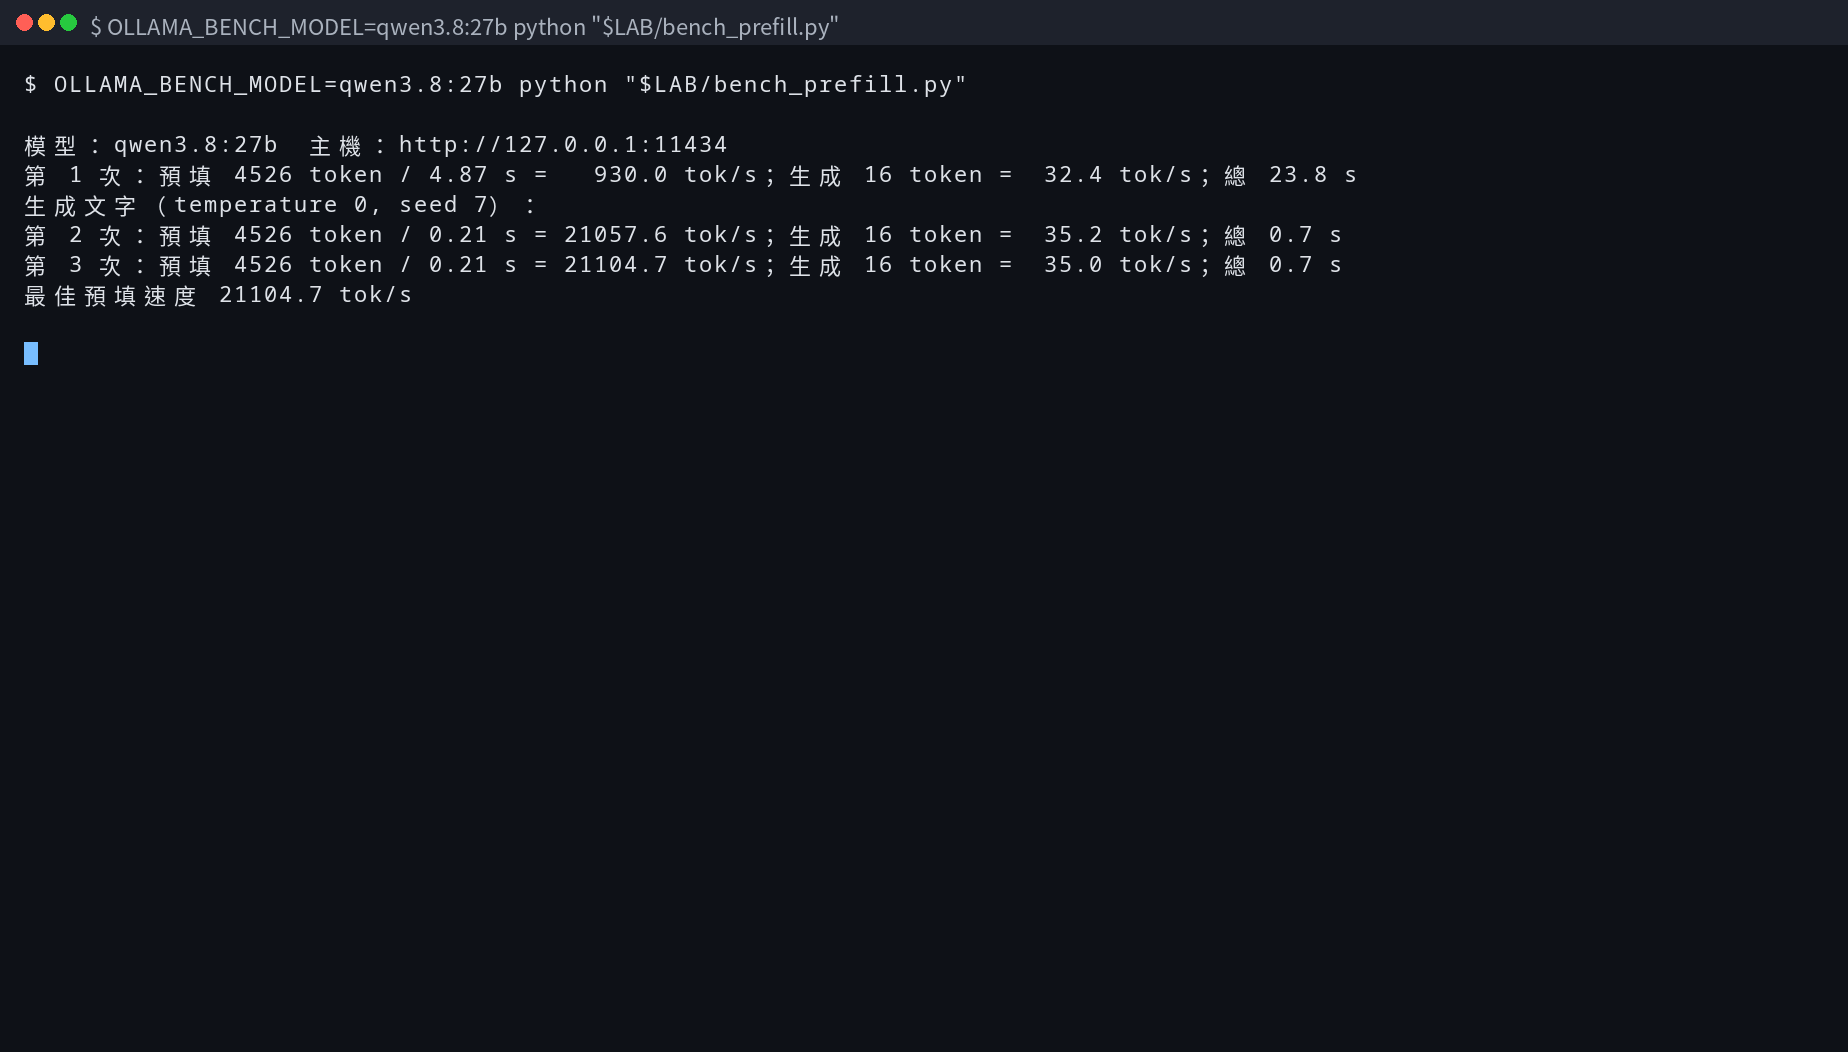
| Ollama 預填速度 (qwen3.8:27b) | 14,810.6 tok/s(換核心後 17,960.9) | 21,104.7 tok/s |
| 驅動更新維護 | 需等待社群更新補丁 | 模組獨立運作,無需重編譯驅動 |
| 安裝複雜度 | 無 | 需手動設定模組載入順序 (softdep) |
安裝與執行過程
| 步驟 | 指令 | 結果 | |
|---|---|---|---|
| 環境檢查與基準測試 | uname -a; nvidia-smi; python bench_gemm.py | 結束碼 0;RTX 3090 驅動 580.173.02;BF16 基準 56.1 TFLOPS | |
| 下載與安裝模組 | git clone ...; make install | 結束碼 0;安裝成功,模組大小 908K | |
| 第一次重開機後檢查 | `dmesg \ | grep gpu_unlock` | 結束碼 0;出現 'gpu_unlock: unlock failed (-16)',因 nvidia 驅動先載入 |
| 修正模組載入順序 | echo 'softdep nvidia pre: gpu_unlock' > /etc/modprobe.d/gpu-unlock-order.conf; update-initramfs -u | 結束碼 0;initramfs 重建成功,加入 softdep 設定 | |
| 第二次重開機後檢查 | `dmesg \ | grep gpu_unlock` | 結束碼 0;出現 'gpu_unlock: unlocked',解鎖成功 |
| 解鎖後效能測試 | python bench_gemm.py; python bench_prefill.py | 結束碼 0;BF16 提升至 111.0 TFLOPS;Ollama 預填速度提升至 21,104.7 tok/s |
結果驗證
在成功修正模組載入順序後,效能提升顯著。GEMM 基準測試顯示,BF16 吞吐從 56.1 TFLOPS 提升至 111.0 TFLOPS。FP16 也從 53.5 TFLOPS 提升至 105.0 TFLOPS。
在實際的 LLM 應用場景中,使用 Ollama 執行 qwen3.8:27b 模型的預填(Prefill)速度,從 14,810.6 tok/s 提升至 21,104.7 tok/s。生成(Decode)速度則從約 19 tok/s 提升至 35 tok/s。
要注意 Ollama 這項的變因不只解鎖:第一次重開機時核心從 7.0.0-30 換成 7.0.0-38,當時解鎖失敗,預填速度已經是 17,960.9 tok/s、生成 25.6 tok/s,所以從 14,810.6 到 17,960.9 這段是換核心與重開機的影響,解鎖本身帶來的是 17,960.9 到 21,104.7 tok/s。GEMM 則乾淨得多:同一次失敗的開機下 FP16 55.8、BF16 53.9 TFLOPS 幾乎沒動,解鎖成功後才翻倍到 105.0 與 111.0;TF32 也從 28.2 升到 57.0 TFLOPS。功耗上限前後都是 350 W,解鎖沒有改功耗。
第一次安裝後並未立即生效,因為 Ubuntu 24.04 的 initramfs 預設行為導致 nvidia 驅動先於 gpu-unlock 載入。只有在使用 softdep 強制調整載入順序後,核心日誌才顯示 'gpu_unlock: unlocked',效能測試數據也才反映解鎖後的狀態。
遇到的問題
1. 第一次重開機後解鎖失敗,錯誤訊息為 'gpu_unlock: unlock failed (-16)',原因是 nvidia 驅動程式先於 gpu-unlock 模組載入。
2. 解決方法:手動建立 /etc/modprobe.d/gpu-unlock-order.conf 檔案,加入 'softdep nvidia pre: gpu_unlock',並重建 initramfs。此步驟不在官方 README 中,需自行判斷與修正。
結論
gpu-unlock 對於擁有 RTX 30 系列顯示卡且需要高效能 AI 推論的使用者來說,是一個極具吸引力的工具,能免費釋放近一倍的矩陣運算效能。然而,其安裝過程並非完全無痛,特別是在較新的 Linux 發行版(如 Ubuntu 24.04)上,使用者必須具備一定的 Linux 核心模組知識,能自行處理模組載入順序問題。對於不願處理 initramfs 或核心參數設定的新手,建議等待更完善的安裝腳本或發行版支援。
來源:佐證 0 筆,另有背景參考 1 筆
背景參考正文沒有引用,只是相關背景,不計入佐證數
- github.com · Zagitta/gpu-unlock(GitHub,commit af28cbbfd3d9)
這篇對你有用嗎?
登入會員後可以按反應與留言。登入
留言 0
- 還沒有留言。
留言公開顯示暱稱,不顯示你的真實姓名與信箱。含多個連結或疑似廣告的留言會先經編輯確認;檢舉達 3 次的留言會自動隱藏。隱私政策
發現錯誤?
回報會進入待處理清單;核實後更正,並在文中註記更正紀錄。