新模型發佈 · 2026/10/09 於 Hugging Face 發布
Youtu-Parsing-Omnitencent
圖文多模態5.3Bother
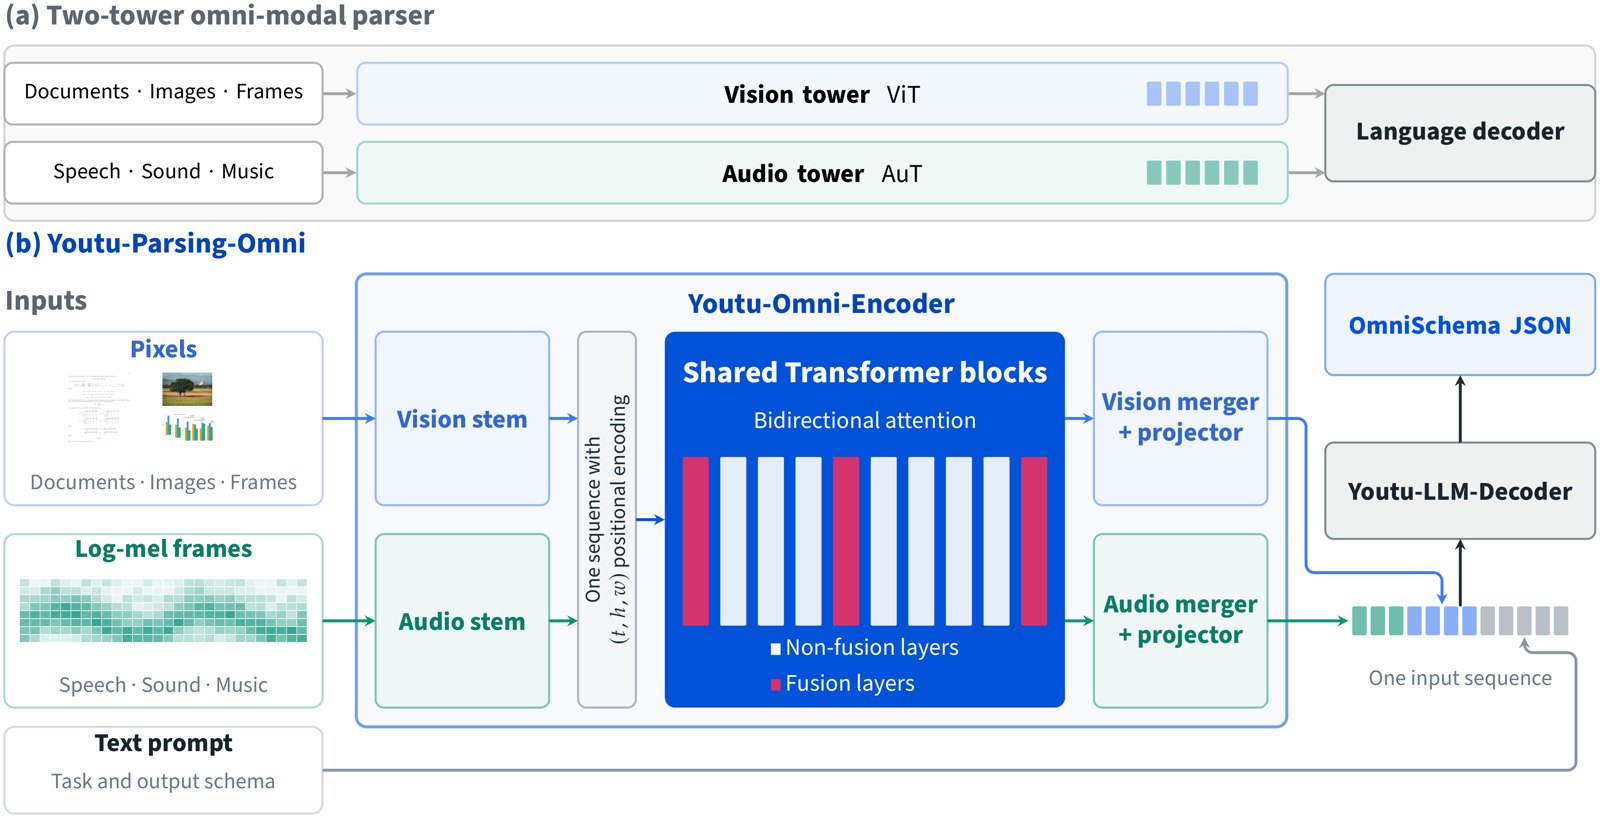
騰訊發布 Youtu-Parsing-Omni,一款 5.3B 參數的全模態解析模型。它整合單一編碼器處理文件、圖片、圖表、幾何圖形、音訊及影片,輸出結構化 JSON。架構上採用 OmniSchema 與 OSAD 訓練法,支援圖片、音訊與影音輸入。授權為其他類型,適合需將多模態內容轉換為結構化資料的工程場景。
重點
- 5.3B 參數,支援文件、圖片、音訊與影片輸入
- OmniDocBench v1.6 總分 96.96,開源模型領先
- 統一 JSON 輸出格式,涵蓋感知與認知任務
- 單一編碼器架構,共享多數感知參數
模型卡自報分數
由發布方在模型卡公布,本站未複測;對照欄是同一張表裡最強的對照模型| 評測 | 分數 | 模型卡上的對照 |
|---|---|---|
| OmniDocBench v1.6 Overall | 96.96 | TeleOCR 96.91 |
| OmniDocBench v1.6 Text Edit | 0.0271 | OvisOCR2 0.0265 |
| OmniDocBench v1.6 Formula CDM | 96.8 | PaddleOCR-VL-1.6 97.53 |
| OmniDocBench v1.6 Table TEDS | 96.79 | TeleOCR 96.82 |
| OmniDocBench v1.6 Table TEDS-S | 98.2 | TeleOCR 98.18 |
| OmniDocBench v1.6 Reading Order Edit | 0.1104 | OvisOCR2 0.1120 |
下載與變體
- tencent/Youtu-Parsing-Omni5.33B 參數 · 117 讚 · 2646 次下載
介紹由 AI 依模型卡整理,資料日期 2026-10-26;發布方說法未經本站驗證。