新模型發佈
Hugging Face 最近 90 天發布的模型,依發布日排。介紹依模型卡整理,分數是模型卡自報、本站未複測;標「本站實測」的有實驗室的量測數據。官方公布分數天梯榜
2026 年 10 月54 個
- 10/24
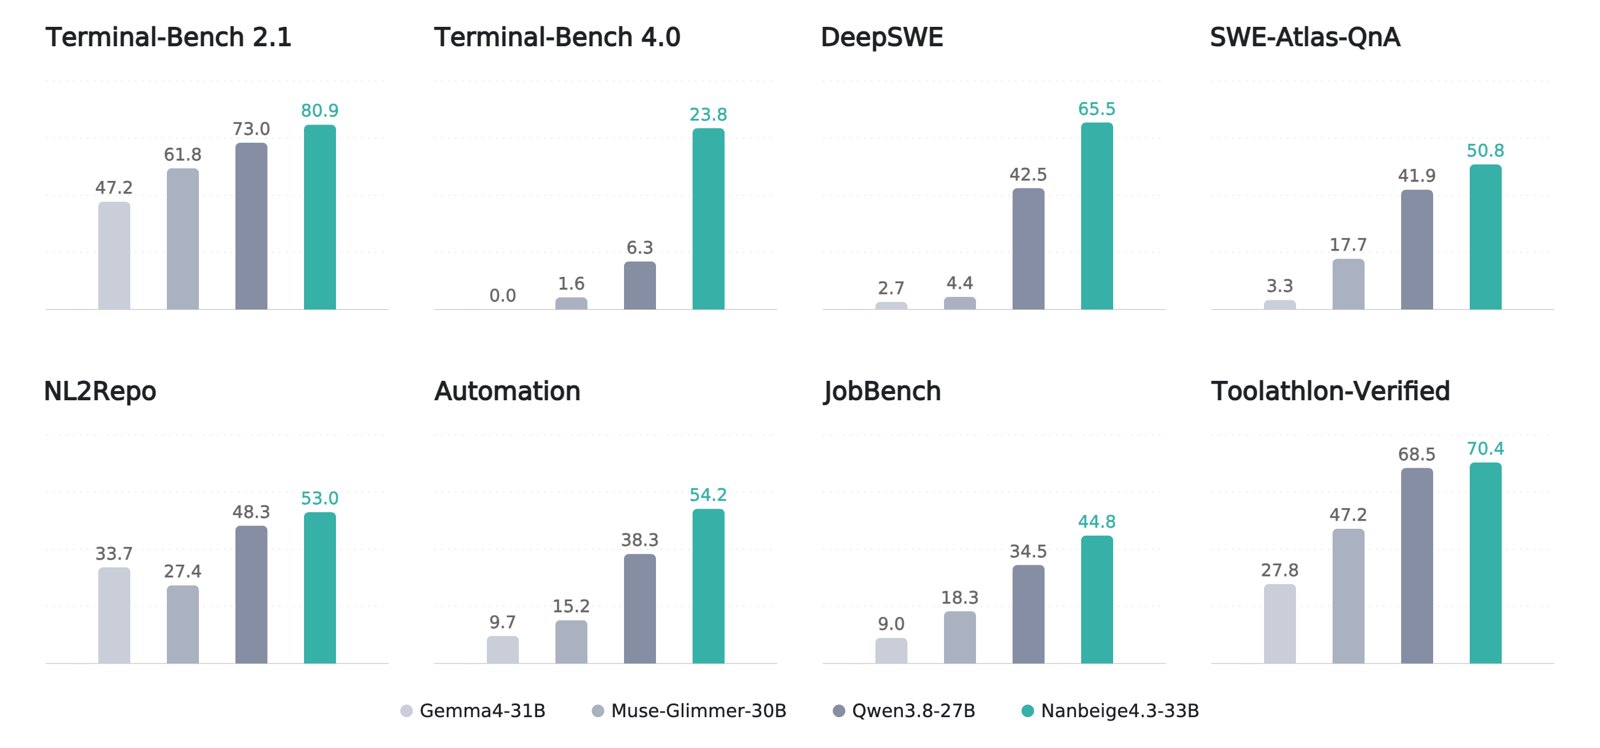
Nanbeige 團隊發布 Nanbeige4.3-33B,一款 33.12B 參數量的文字生成模型,採用 LlamaForCausalLM 架構。作為 Nanbeige4.3 系列的旗艦教師模型,其專為複雜程式碼撰寫與專業協作任務設計,支援高達 512K 的上下文長度。模型授權為 Apache 2.0,可自由商用,適合需要高能力代理(Agent)應用且追求成本效益的開發者,同時作為蒸餾小模型的基礎。
Terminal-Bench 2.1 80.9%Terminal-Bench 4.0 23.8%DeepSWE 65.5%SWE-Bench Pro 60.3%SWE-Atlas-QnA 50.8%NL2Repo 53%模型卡自報
- 10/22
騰訊微信視覺團隊發布 WeVisOne-VL,基於 Qwen3-VL 架構的圖文多模態模型,提供 2.44B 與 4.83B 兩種參數量。該模型透過結構化 next-token prediction 與 9.6M 參數像素解碼器,統一物件層級感知(偵測、定位、計數、OCR)與像素層級感知(分割、抠圖)。採用 Apache 2.0 授權,適合視覺定位、分割及抠圖研究,但不支援影片輸入與自主決策。
- 10/22
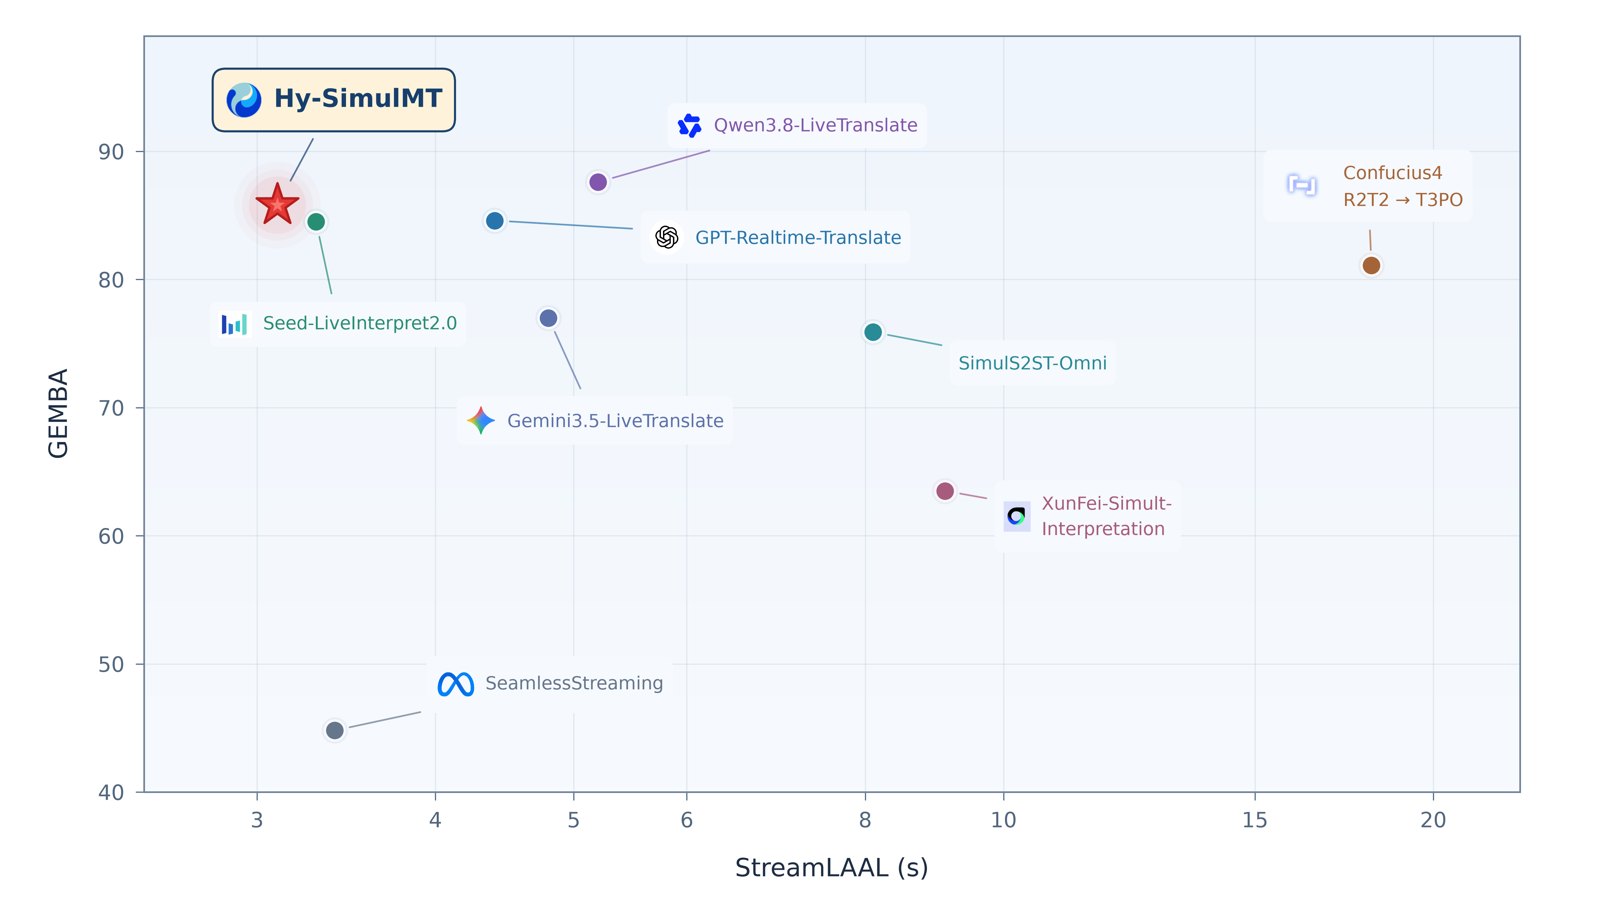
Tencent Hunyuan 發布 Hy-SimulMT-30B-A3B,一款專為即時同步翻譯設計的語音模型。該模型參數量為 30.39B,支援中英文雙向語音對語音翻譯,並具備即時語音複製功能,能在保留說話者音色的同時輸出翻譯文字與語音。其架構針對低延遲優化,在 RealSI 長音訊評測中達到約 3 秒的 StreamLAAL。採用 Apache 2.0 授權,適合會議、演講等需即時跨語言溝通的場景。
FLEURS 90.3CoVoST2 75.5ACL6060 81.2RealSI-Sentence 84.7模型卡自報
- 10/21
Recursive 發布 Flint,一款專為程式代理設計的混合專家(MoE)語言模型。總參數量 39.8B,每 token 僅啟用約 2.5B 參數,採用 49 層架構與 262,144 tokens 上下文。模型經過預訓練、微調與強化學習,支援推理與多輪工具使用,適合程式碼庫調查、Bug 修復與功能實作。權重以 Apache 2.0 授權釋出,可商用。
SWE-bench Verified 74.2%SWE-bench Pro v2 89.7%Terminal-Bench 2.1 54.9%模型卡自報
- 10/21
Hugging Face Bio 發布 Carbon-X,一款專為 DNA 理解與生成設計的 14.8B 參數文字生成模型。該模型基於 Qwen3 架構,採用混合 tokenizer 處理 DNA 序列與自然語言,支援 40,960 tokens 上下文。訓練過程結合 302B tokens 的中間訓練與強化學習,能預測突變效應、識別基因調控區域及解釋推理。授權為 Apache 2.0,權重可於單張 80 GB GPU 以 bfloat16 格式運行,適合生物資訊研究與基因組分析應用。
BioReason Coding 74.9%BioReason Non-SNV 85.1%GenomeQA 63.6%NextBase 39.4%FrontierVEP 70.4%Average 66.7%模型卡自報
- 10/21
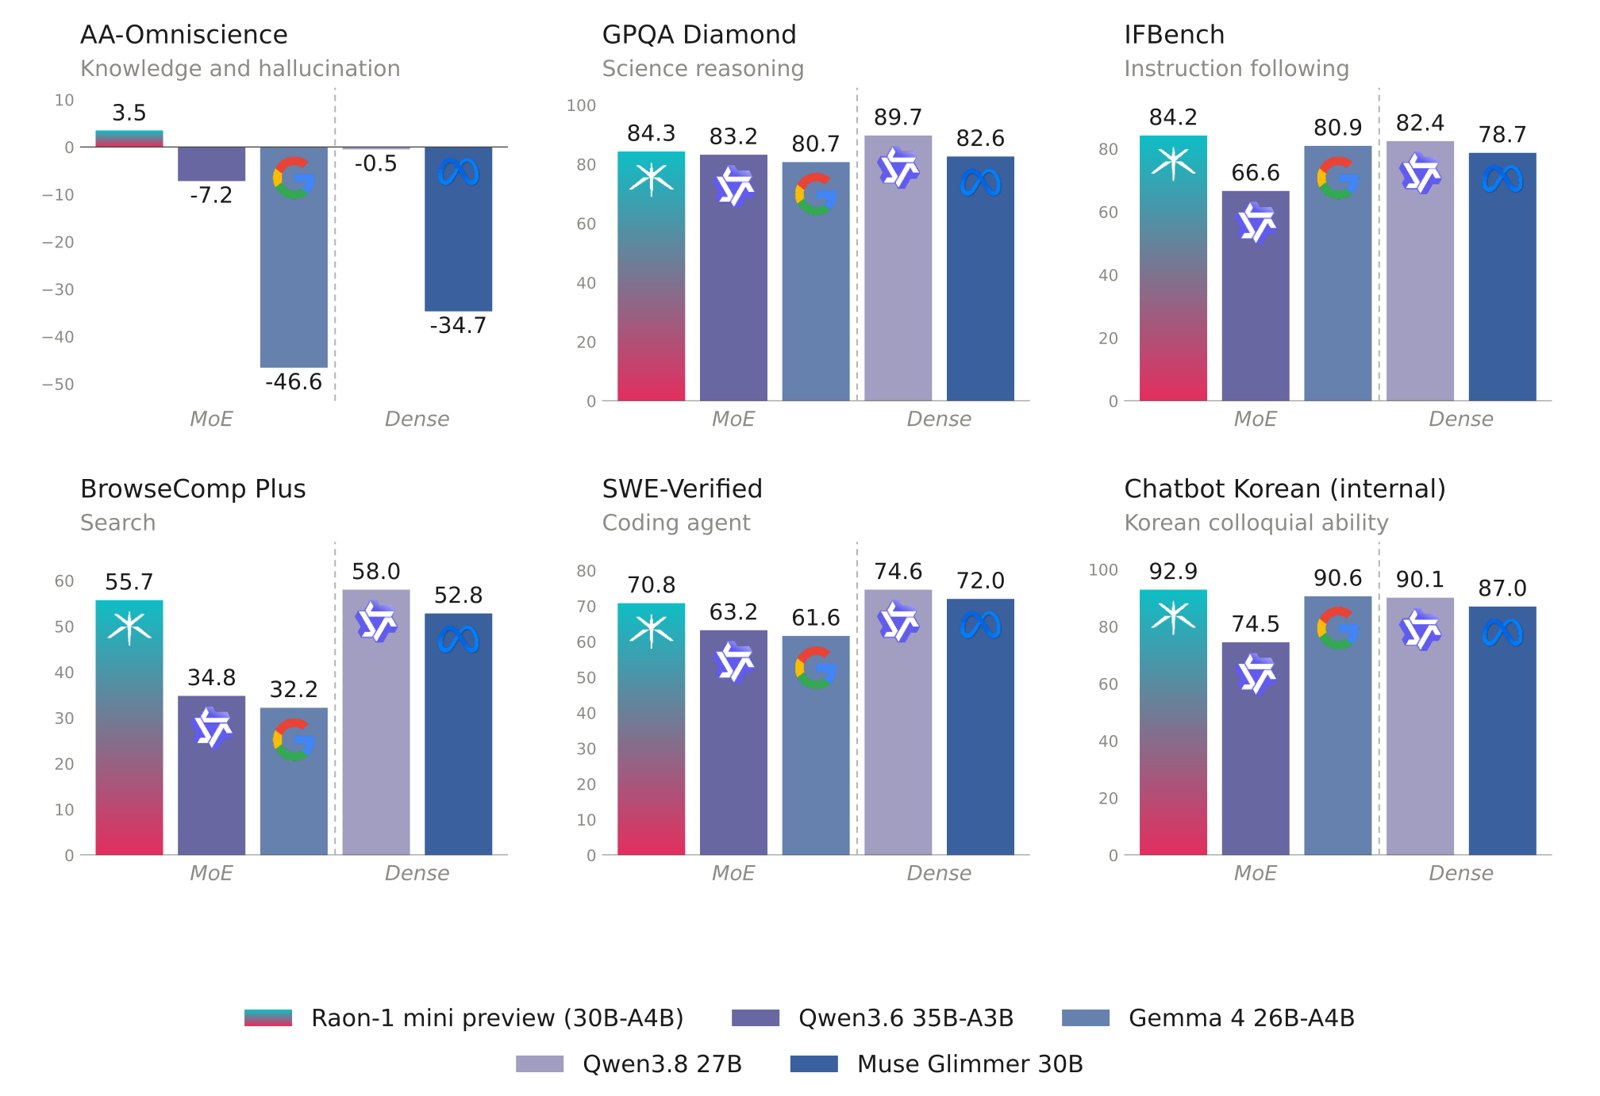
KRAFTON 發布 Raon-1 mini-preview,為 28.78B 參數量的 MoE 文字生成模型,每次推論僅啟用 4.3B 參數。採用混合注意力架構,原生支援 262,144 tokens 上下文長度。授權為 Apache 2.0,可商用。模型專精韓語對話與代理任務,並提供 NVFP4 量化格式,適合在單張 32GB VRAM 顯卡上執行。
MMLU Pro 76.5%AA-Omniscience 3.5模型卡自報
- 10/21
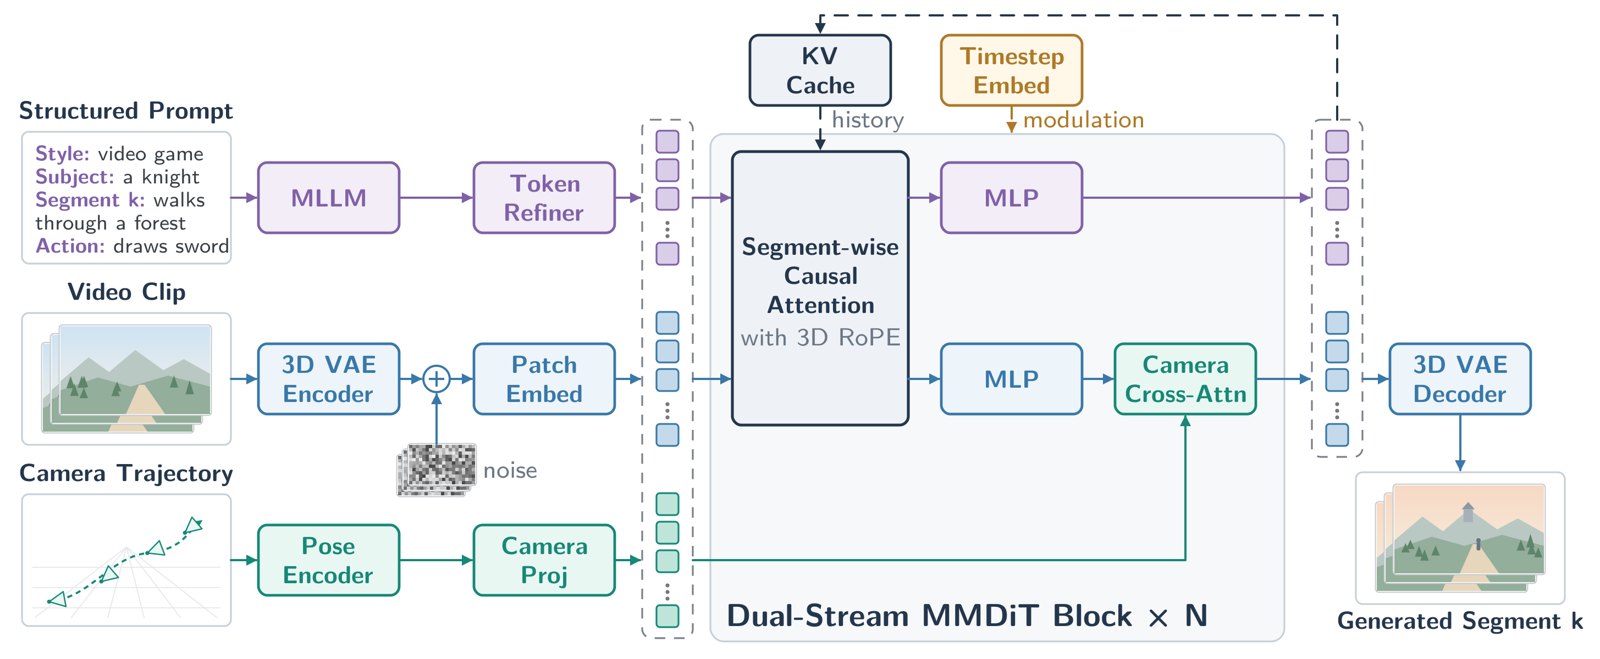
騰訊發布 Hy-Nomas,一款支援自由形式互動的影片世界生成模型。架構結合 54 層雙流 MMDiT、Qwen 文字編碼器與 PixelUMM 解碼器,透過 KV 快取維持上下文連貫性。模型以 8 步去噪生成 720x1280、24 FPS 影片,支援文字指令與鏡頭軌跡控制。採用 Apache 2.0 授權,適合需要連續場景生成與即時互動控制的應用場景。
- 10/21
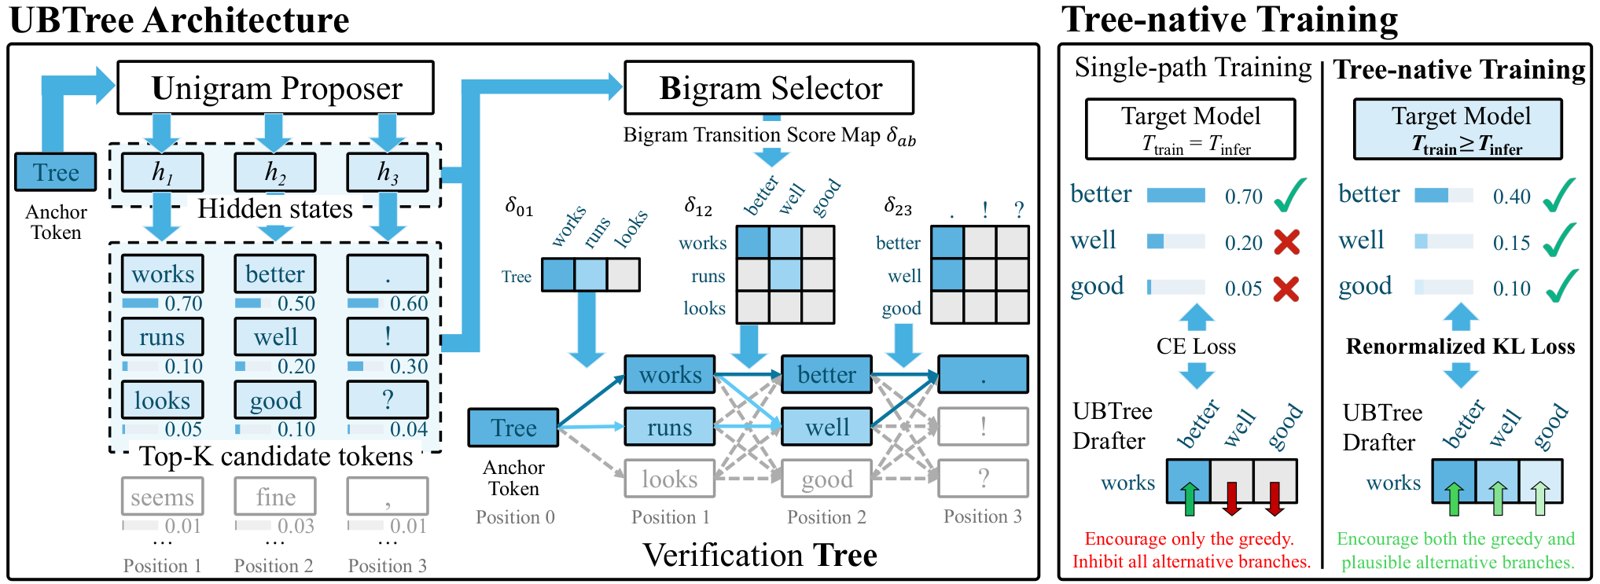
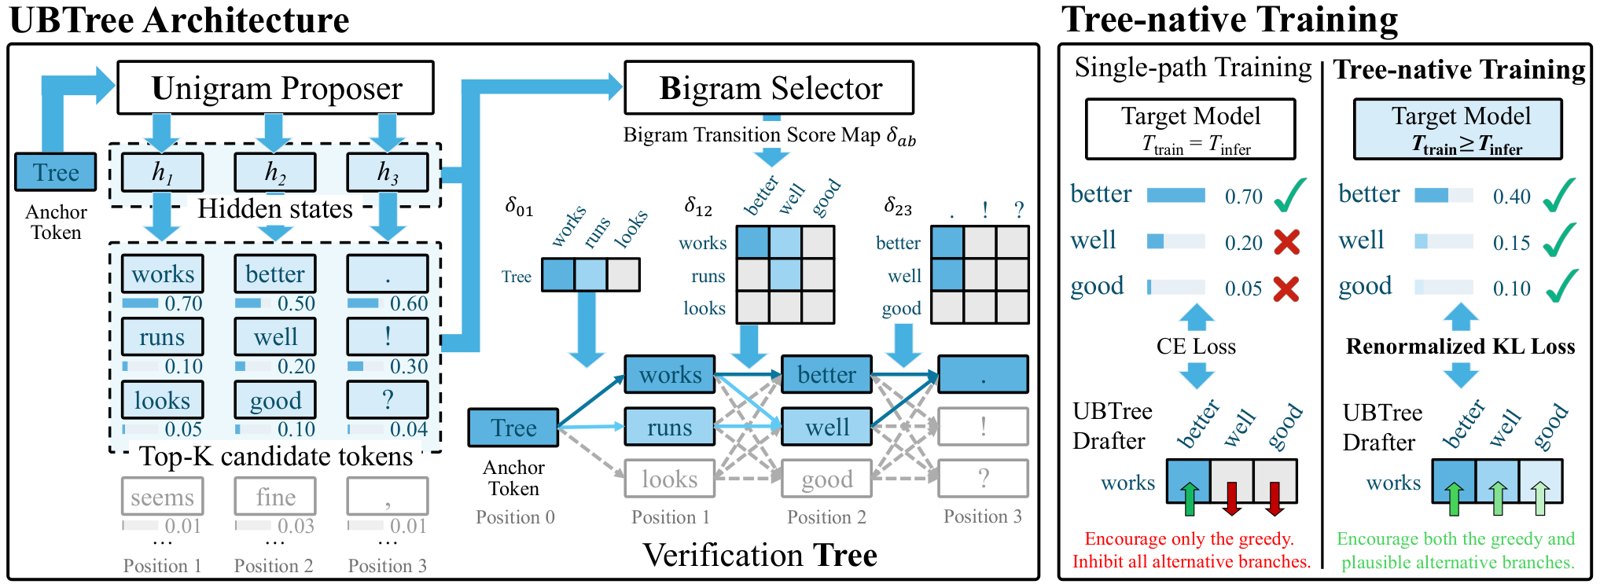
inclusionAI 發布 Ling-3.0-tiny-UBTree,這是一個專為 Ling-3.0-tiny 設計的推論加速草稿模型,非獨立生成模型。其架構結合五層 DFlash 骨幹與學習型 bigram 選擇器,透過平行樹狀草擬機制提升驗證效率。模型參數量約 183M,權重格式為 BF16,採用 MIT 授權。此模型需搭配目標模型使用,旨在透過 speculative decoding 技術,在保持輸出品質前提下顯著提升推論速度。
GSM8K 3.055MATH-500 3.518AIME 2025 3.152HumanEval 3.411MBPP 3.062LiveCodeBench 2.794模型卡自報
- 10/19
XHToken 發布 Spark-X2.6-4B,这是一款 4.11B 參數量的文字生成模型,專為端側部署設計。該模型沿用 Spark-X2.5-4B 架構,透過改進後訓練提升編碼、代理工作流及長上下文能力,並支援 none、low、high 三級可調思考預算以平衡推論成本。其上下文長度可達 1048576 tokens,採用 Apache 2.0 授權,適合開發者構建即時響應的端側 AI 應用,在相似規模開源模型中表現優異。
- 10/19
Gradium 發布 phonon-31m-en,一款專為英文設計的輕量級文字轉語音模型。參數量僅 31M,採用 flow-matching transformer 架構搭配 Mimi codec,能生成 24 kHz 單聲道語音。模型支援串流生成,可在瀏覽器、手機或筆電 CPU 上執行。授權為 Apache 2.0,適合需要本地端部署、低延遲語音合成的應用場景。
Elo 2098Hard set LLM WER 1.5%Seed-TTS LLM WER 0.51%模型卡自報
- 10/19
inclusionAI 發布 Ling-3.0-flash-Sante,这是一款醫療專用文字生成模型,總參數量 127.49B,每 token 啟用 5.1B 參數。採用混合線性 MoE 架構,結合 Kimi Delta Attention 與稀疏 MoE 層,訓練上下文長度達 256K。授權為 MIT,適合醫療推理、深度研究、長文件分析及工具輔助工作流,並保留通用能力。
- 10/17
DeepSeek 發布 DeepSeek-V4.1-Flash-1017,為圖文多模態模型,參數量 763B。此版本為 V4.1-Flash 的小幅更新,強化推理、程式碼、代理任務與視覺能力,並縮短任務執行時間與輸出長度以提升成本效益。模型支援 1M tokens 上下文視窗,採用 MIT 授權,適合需要長上下文處理與多模態理解的開發場景。
HLE w/o tools 42.6%Terminal-Bench 4.0 42.3%DeepSWE v1.1 77%ProgramBench 29.1%NL2Repo-Bench 68.2%Automation-Bench v1.0.6 60.5%模型卡自報
- 10/17
MiniMax 發布 MiniMax-M3.1-Flash,為原生多模態混合專家(MoE)模型,總參數量約 428B,每 token 啟用 23B。支援文字、圖片與影片輸入,上下文長度達 1M tokens。架構採用全模型稀疏注意力(MSA)、量化感知訓練與 DSpark 投機解碼以提升推論效率。授權為其他類型,適合程式開發、代理工作流程、電腦操作及資安任務。
Automation-Bench v1.0.6 62.8BankerToolBench 76.2GDP.pdf AA 20.8Terminal Bench 4.0 38.1LOCA-Bench 256K 60.3Agents’ Last Exam 29.6模型卡自報
- 10/17
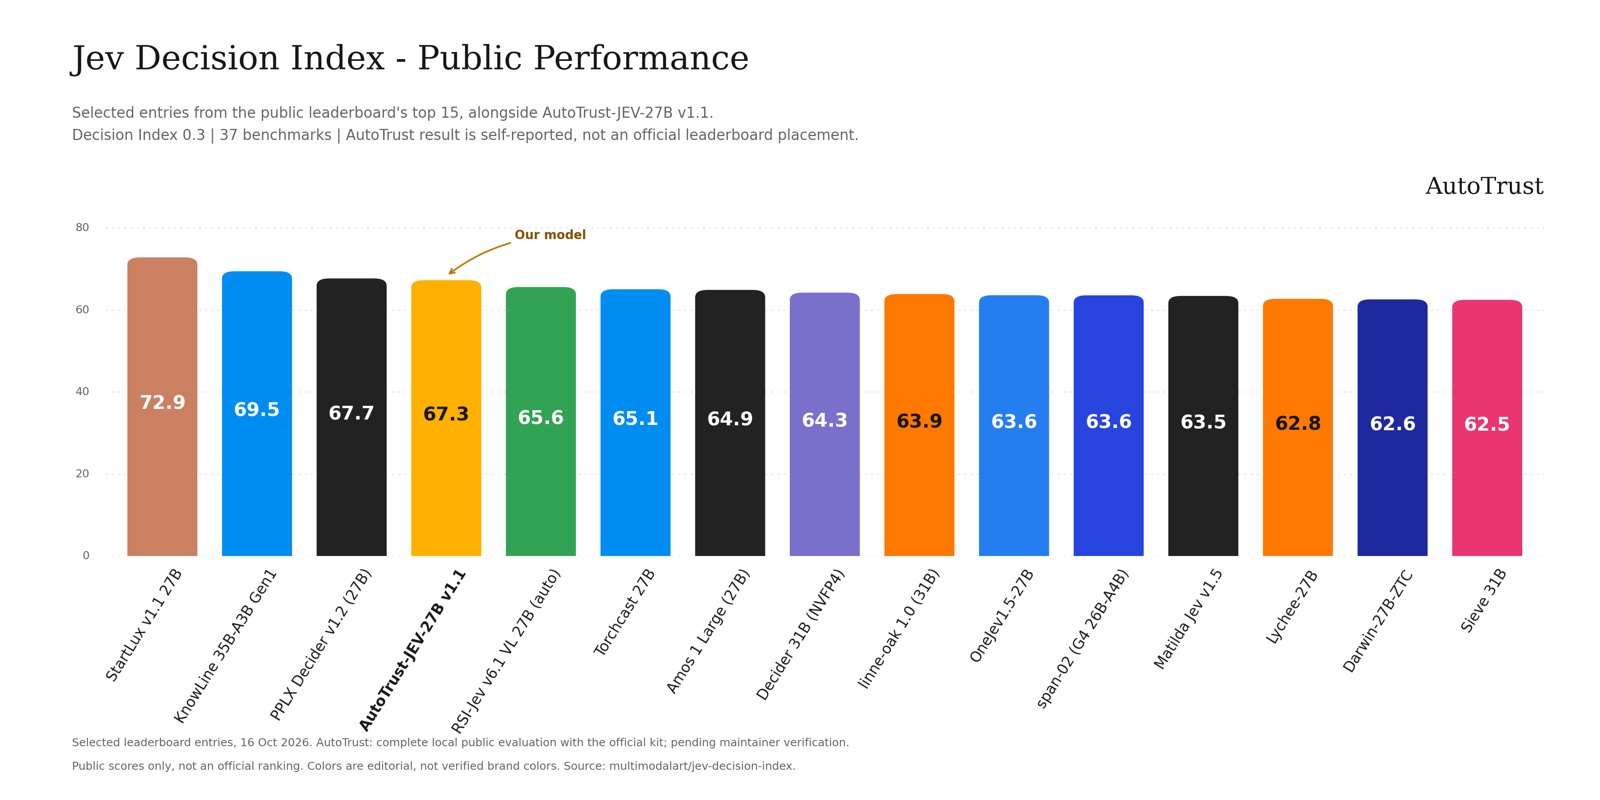
AutoTrust 發布 AutoTrust-JEV-27B-v1.1,是一款基於 Qwen3_5 架構的 27.36B 參數文字決策模型。該模型專為結構化決策設計,透過輸出選項機率進行意圖分類與工具選擇,而非生成自由文本。採用 Apache 2.0 授權,支援 32K 上下文長度。適合需要高準確度意圖識別、API 路由及自動化決策的工程場景,在 BFCL 與 CLINC150 等基準表現突出。
BFCL 97.23%CLINC150+OOS 97.08%BANKING77 93.71%WinoGrande 95.26%HellaSwag 98.22%MMLU-Pro 73.65%模型卡自報
- 10/17
Microsoft 發布 Sentiment-Analysis-7B,這是基於 Mistral-7B-Instruct-v0.2 微調的 7.24B 參數文字生成模型。該模型專為使用者訊息的情緒分類設計,透過強化學習與 LLM 作為裁判,僅使用約 300 筆內部訓練資料進行微調,未預定義標籤。模型輸出首個 token 即為情緒標籤(Negative、Neutral 或 Positive),後續提供簡短解釋。採用 MIT 授權,適合需要快速判斷客服或產品回饋情緒的應用場景。
accuracy 72.8%模型卡自報
- 10/16
NVIDIA 發布 Nemotron-Labs-Dory1.0-4B-BF16,為 4B 參數量的文字生成模型。採用 Loop (latent-recurrent) 架構,結合滑動視窗與全注意力層,透過重複套用共享層區塊來增加每 token 的運算量。支援最高 256K 上下文長度,僅支援英文。授權為 OpenMDW 1.1,允許商用。適合在有限硬體資源下追求高推理效能的應用場景。
SWE-bench Verified 61.8%GPQA Diamond (no tools) 72.41%IFBench 79%AA-LCR 73%SciCode 35.11%Terminal-Bench 2.1 22.2%模型卡自報
- 10/16
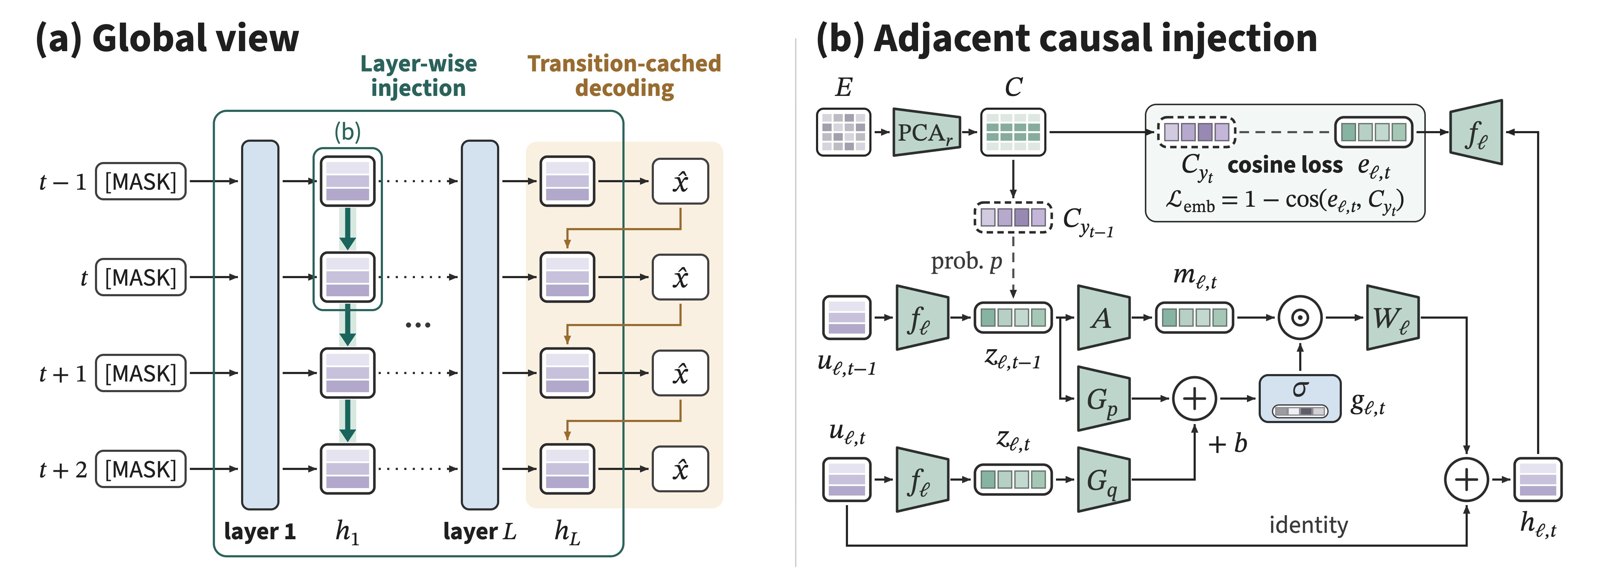
Tencent 發布 DSpine,這是專為推論加速設計的平行草稿模型,搭配 Qwen3-8B 使用。模型參數量約 1.24B,採用深度因果注入架構,讓所有位置在平行生成草稿時能透過網路深度維持因果鏈。授權為 Apache 2.0,適合用於提升 LLM 推論吞吐量的場景。
GSM8K 10.55MATH-500 10.3HumanEval 8.27MBPP 7.66LCB 7.25MT-Bench 5.63模型卡自報
- 10/15
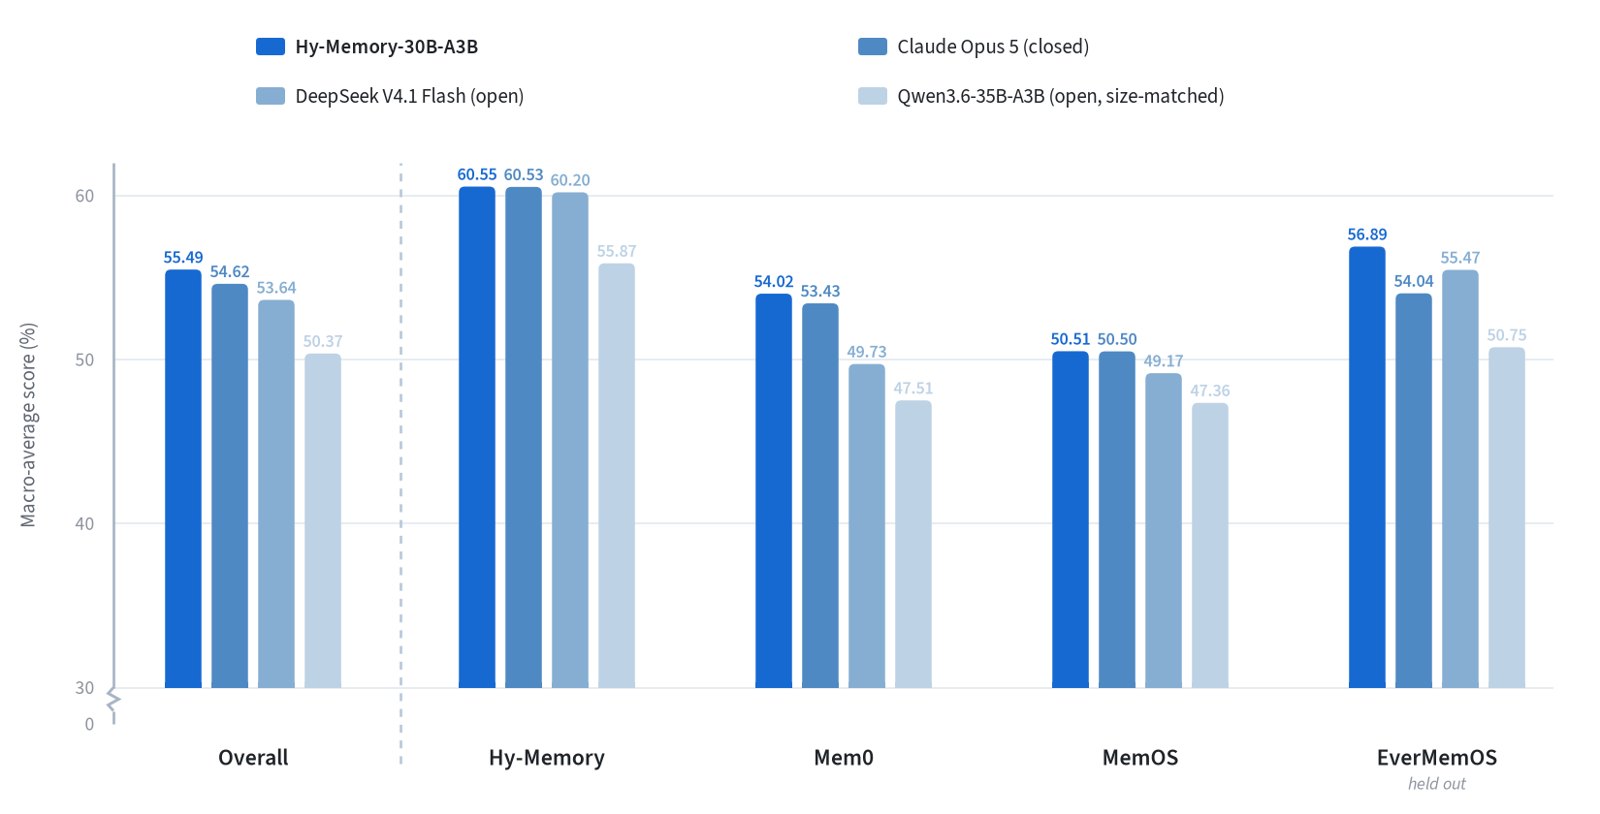
Tencent Hunyuan 發布 Hy-Memory-30B-A3B,这是一款專為外部記憶框架設計的長期記憶寫入模型。該模型總參數量約 30B,採用 MoE 架構,每次推論僅啟用約 3B 參數。訓練分為記憶線上蒸餾與歸因記憶強化學習兩階段,旨在決定資訊保留、表示精度及更新持久記憶庫。模型可直接替換 Mem0、MemOS 及 Hy-Memory 中的通用 LLM,並能遷移至未見過的 EverMemOS 框架。授權為 Apache 2.0,適合需要高效能記憶管理的應用場景。
Mem0 Avg. 54.02Hy-Mem. Avg. 60.55MemOS Avg. 50.51EverMem. Avg. 56.89Overall Avg. 55.49模型卡自報
- 10/15
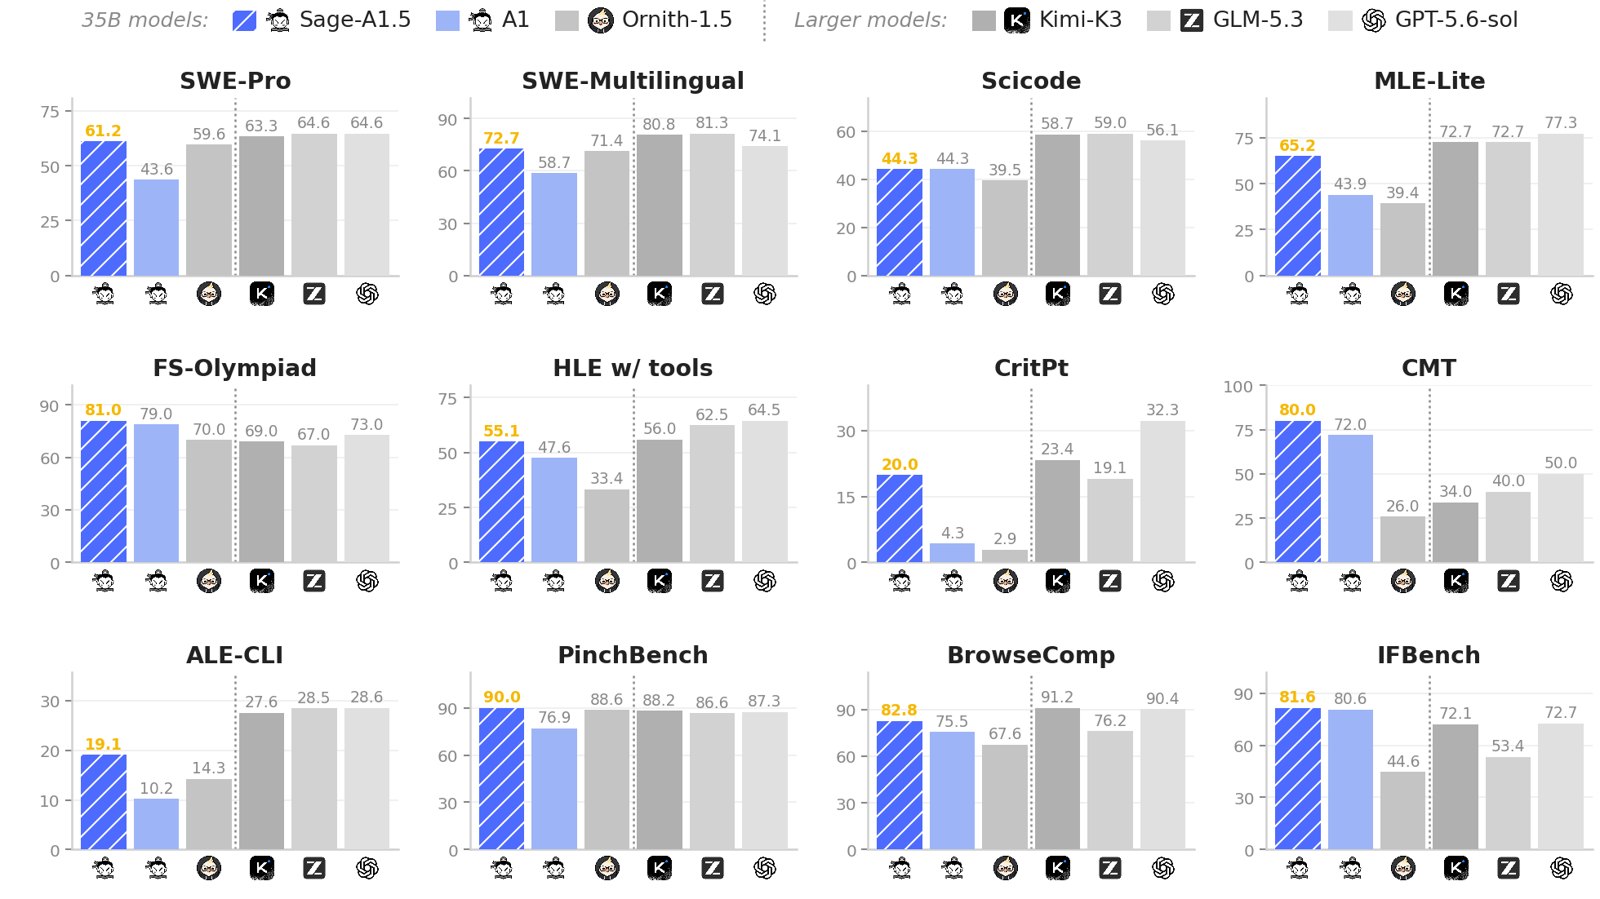
InternScience 發布 Sage-A1.5,一款基於 Qwen3.6 架構的 35B 參數 MoE 文字生成模型。該模型專為長程科學問題解決設計,具備代理編排、自我驗證與開放科學發現能力,支援並行子代理協作與工具整合。上下文長度未在模型卡明確標示,採 Apache 2.0 授權,適合需要高可靠性推理與複雜任務分解的工程與科研場景。
GAIA 95.1%XBench-DS-2510 92%IFBench 81.6%SWE-bench Pro 61.2%SWE-bench Multilingual 72.7%MLE-Lite 65.2%模型卡自報
- 10/15
MemTensor 發布 MemT-1.0-Nano,这是一款基於 Qwen3.6-35B-A3B 架構的文字生成模型。總參數量 35.11B,每次推論僅啟用 3B 參數。其核心特色為原生記憶架構,結合動態局部記憶與可訓練超記憶,能在不存取原始上下文的情況下保留歷史資訊,儲存空間較 128K 長度的 KV Cache 減少約 66 倍。模型以 Apache 2.0 授權發布,適合需要長期記憶與經驗導向代理編碼的應用場景。
- 10/15
Perplexity AI 發布 pplx-decider-flash-v1.2,為 4.5B 參數量的文字與圖文多模態決策模型。基於 Qwen3.5-4B 架構,透過蒸餾 27B 教師模型及模型湯技術訓練,專精於分類、檢索與工具調用決策。支援最高 1.6 MP 影像輸入,上下文長度達 262,144 tokens(訓練約 32K)。採 Apache 2.0 授權,適合對延遲與成本敏感、需高吞吐量的即時決策場景。
Decision Index 0.3 (Overall) 60.05%Decision Index 0.3 (Knowledge) 42%Decision Index 0.3 (Language) 65%Decision Index 0.3 (Retrieval) 65.2%Decision Index 0.3 (Tools) 80.9%Decision Index 0.3 (Arts) 46.8%模型卡自報
- 10/15
Perplexity AI 發布 pplx-decider-v1.2,基於 Qwen3.8-27B 架構的 26B 參數文字分類模型。此版本支援文字與最高 1.6 MP 圖片輸入,採用 joint request format 讓多個問題共用同一序列,提升決策效率。訓練資料納入 Decision Index 官方訓練集並經去污處理,透過 model souping 整合多次訓練結果。授權為 Apache 2.0,適合需要高準確度決策分類、檢索重排及多標籤分類的應用場景。
Decision Index Overall 68.09Vision Decision Index Overall 77.43Decision Index Knowledge 56.3Decision Index Language 72.8Decision Index Retrieval 68.4Decision Index Tools 84.4模型卡自報
- 10/15
NVIDIA 發布 Nemotron-3.5-Rerank-8B-BF16,這是一款 8.38B 參數量的多模態重排模型,專為提升檢索增強生成(RAG)管線的準確率而設計。該模型基於 Ministral-3 架構,結合 Pixtral 視覺編碼器,能處理文字、圖片或图文混合文件。它支援 34 種語言的文字檢索與 18 種語言的圖片檢索,最大上下文長度達 32,768 tokens。模型採用 OpenMDW-1.1 授權,允許商用,適合整合至經典或代理式視覺 RAG 系統中,對候選文件進行精細相關性評分與重新排序。
- 10/14
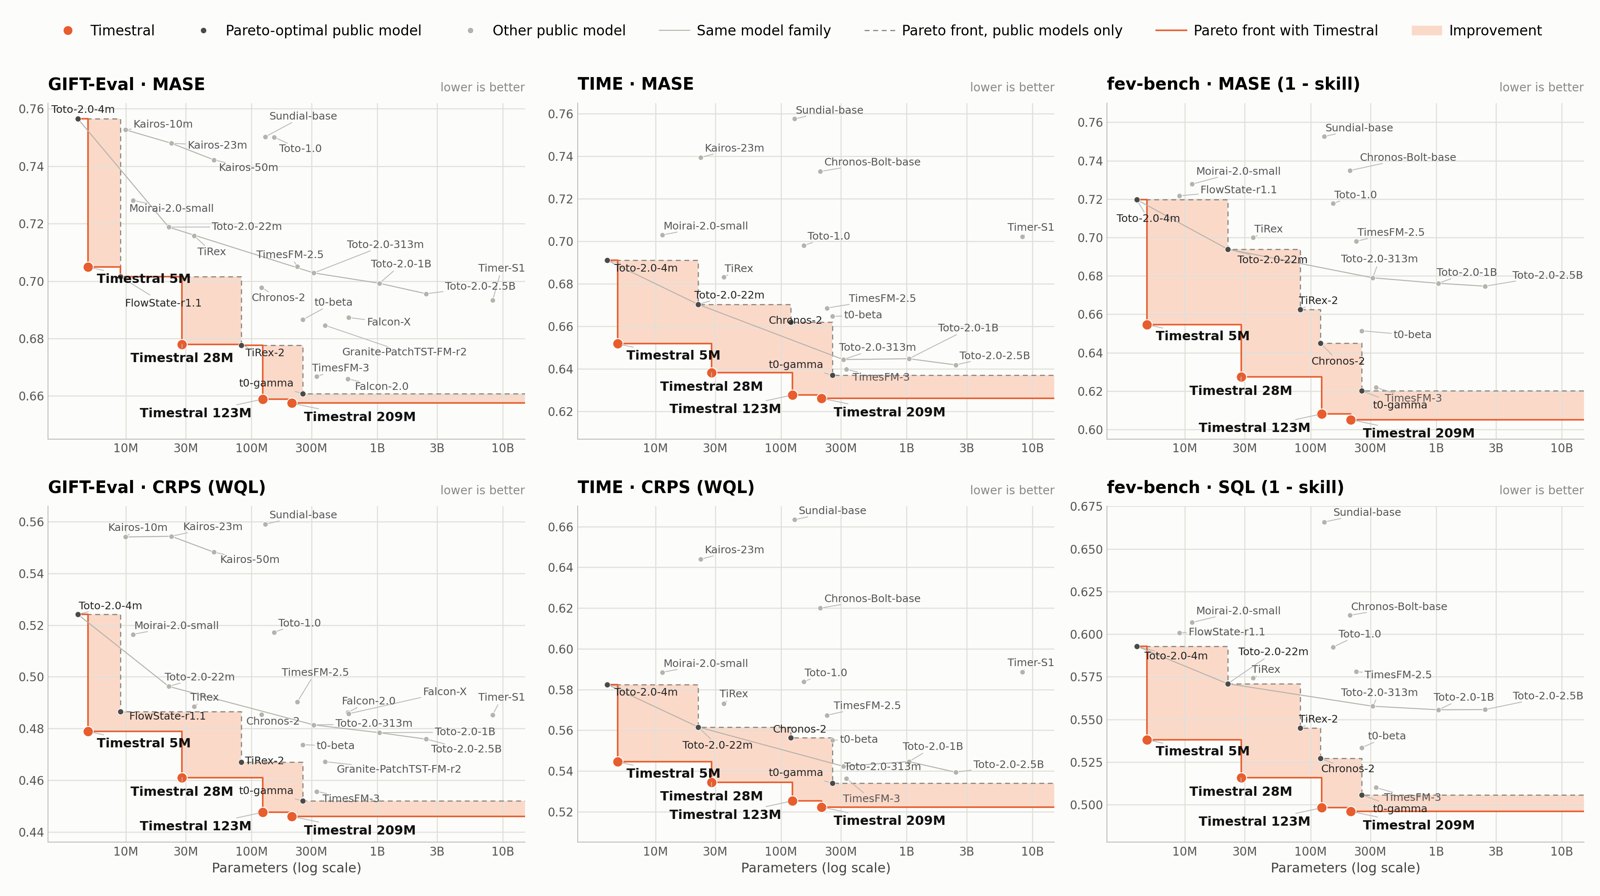
Mistral AI 發布 Timestral-209M,這是 Timestral 時間序列基礎模型家族中最大的 209M 參數版本。該模型採用 patch-based transformer 架構,支援單變量與多變量預測,可處理高達 32,768 個歷史時間步,並在一次前向傳播中預測最多 1,024 步。它提供 21 個分位數的機率性預測,適用於零樣本時間序列預測任務。授權為 Modified MIT,程式碼已開源於 GitHub。
GIFT-Eval MASE 0.658GIFT-Eval CRPS 0.446TIME MASE 0.626TIME CRPS 0.522fev-bench SQL skill score 50.39fev-bench MASE skill score 39.49模型卡自報
- 10/14
Mistral AI 發布 Timestral-5M,這是 Timestral 時間序列基礎模型家族中的最小版本,專為零樣本預測設計。該模型擁有 5M 參數量,採用基於 patch 的 Transformer 架構,結合時間注意力與變量注意力機制。它支援高達 32,768 個時間步的上下文長度,單次推論可預測 1,024 步,並輸出 21 個分位數。授權為 Modified MIT,適合在 CPU 或 GPU 上執行輕量級時間序列預測任務。
GIFT-Eval MASE 0.705GIFT-Eval CRPS 0.479TIME MASE 0.652TIME CRPS 0.545fev-bench SQL skill score 46.19fev-bench MASE skill score 34.54模型卡自報
- 10/14
Black Forest Labs 發布 FLUX 3 Image Klein Prompt Upsampler,這是一款基於 Qwen3.5-9B 微調的 9B 參數視覺語言模型。它專為 FLUX 3 Image Klein 設計,能將簡短指令擴展為包含光影、構圖與細節的詳細提示詞,支援文字生成圖片、參考圖編輯與邊界框佈局。模型採用 Apache 2.0 授權,可商用。其架構凍結視覺塔,透過監督訓練與偏好調整優化輸出品質,適合搭配 FLUX 3 影像生成管線使用,提升生成結果的準確度與細節表現。
- 10/14
IBM 發布 Granite Switch 4.1 8B,為模組化文字生成模型,參數量 8.78B,上下文長度 128K。架構結合基礎模型、兩個 aLoRA 適配器(決策與安全防護)及語音轉文字編碼器,單一端點可處理對話、決策與語音輸入。採用 Apache 2.0 授權,支援 HuggingFace Transformers 與 vLLM 後端,適合需整合多任務且重視部署彈性的應用場景。
Decision Index Overall 42.9Decision Index Knowledge 29.1Decision Index Language 48.9Decision Index Retrieval 49.8Decision Index Tools 59.8Decision Index Arts 18模型卡自報
- 10/14
inclusionAI 發布 Ming-3.0-asr-tiny,這是一款 8.9B 參數量的語音辨識模型,結合 Ling-tiny-v3 語言骨幹與音訊編碼器。它支援中文、英文及多種方言的單輪語音轉文字,並能透過熱詞或對話上下文提升領域術語辨識準確度。模型授權為 MIT,適合需要高準確度語音轉錄且具備上下文理解能力的應用場景,如會議記錄或客服系統。
- 10/14
Mistral AI 發布 Timestral 時間序列基礎模型家族,本倉庫為 123M 參數版本。採用基於 patch 的 Transformer 架構,結合時間與變數注意力機制,共 20 層。支援單變數與多變數輸入,上下文長度達 32,768 個時間步,單次推論可預測 1,024 步。輸出 21 個分位數,適用於零樣本時間序列預測任務。授權為 Modified MIT。
GIFT-Eval MASE 0.659GIFT-Eval CRPS 0.448TIME MASE 0.628TIME CRPS 0.525fev-bench SQL skill score 50.18fev-bench MASE skill score 39.19模型卡自報
- 10/14
Mistral AI 發布 Timestral-28M,這是 Timestral 時間序列基礎模型家族中的 28M 參數版本,專為零樣本預測設計。架構採用基於 patch 的 transformer,結合時間與變數注意力機制,共 12 層。支援高達 32,768 個時間步的上下文長度,單次前向推論可預測最多 1,024 步,並輸出 21 個分位數。授權為 Modified MIT,適合在 CPU 或 GPU 上進行多變量時間序列預測任務。
GIFT-Eval MASE 0.678GIFT-Eval CRPS 0.461TIME MASE 0.638TIME CRPS 0.534fev-bench SQL skill score 48.42fev-bench MASE skill score 37.27模型卡自報
- 10/14
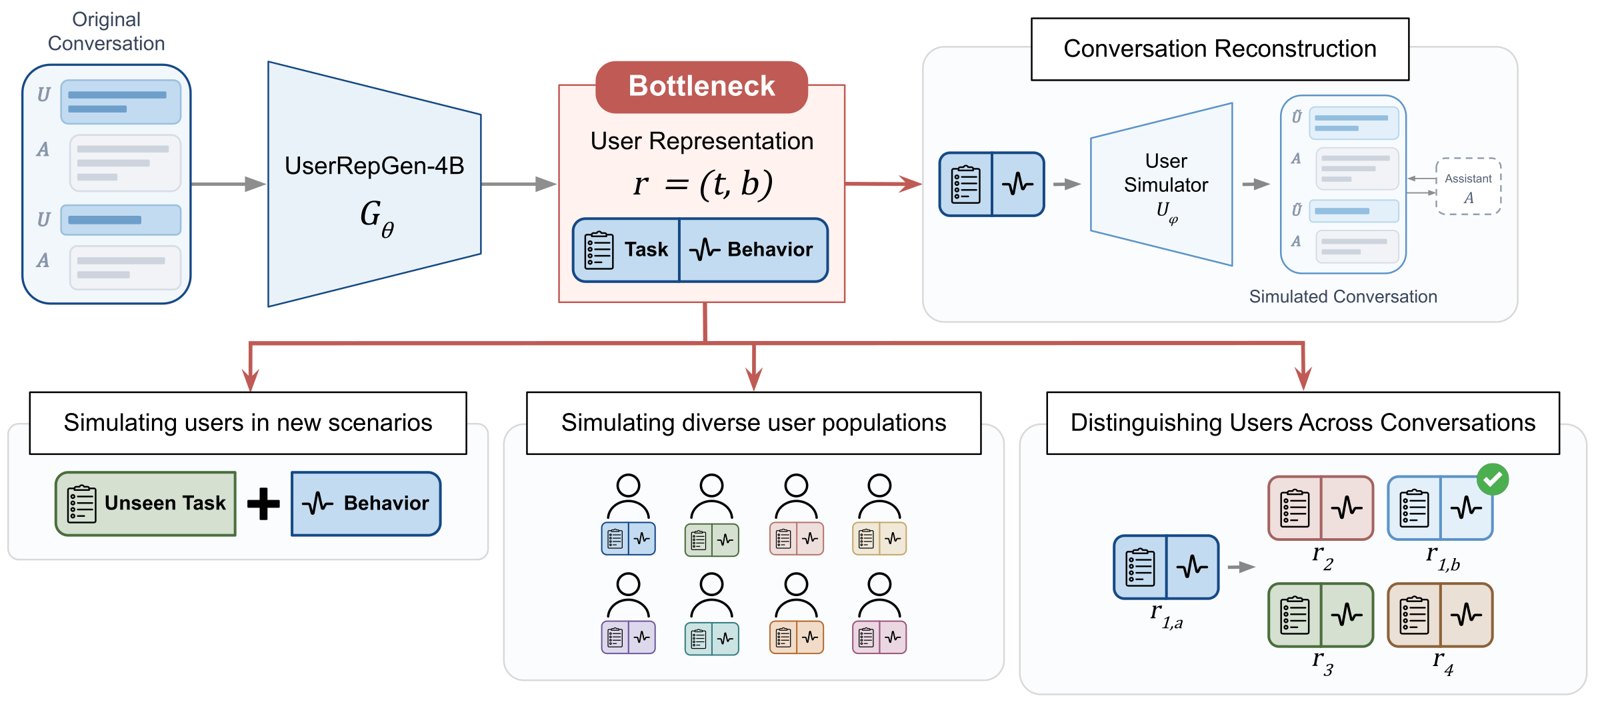
Microsoft 發布 UserRepGen-4B,這是基於 Qwen3.5-4B 微調的文字生成模型,參數量約 4.54B。它透過 Rank-64 LoRA 與線上監督微調,從多輪對話中生成結構化的使用者表徵(任務與行為描述),而非模擬使用者回覆。上下文長度為 9,216 tokens,採 MIT 授權。適合用於建構 LLM 使用者模擬器,以保留對話行為多樣性與重建對話保真度。
- 10/14
inclusionAI 發布 Ling-3.0-flash-UBTree,這是專為 Ling-3.0-flash 設計的推論加速草稿模型,非獨立生成模型。架構結合五層 DFlash 骨幹與學習型 bigram 選擇器,參數量約 482M,權重格式 BF16。透過 UBTree 機制平行提案並驗證候選分支,提升推論速度。授權為 MIT,可自由商用。適合搭配 SGLang 部署,需與目標模型共同運作以加速文字生成任務。
GSM8K 3.227MATH-500 3.761AIME 2025 3.497HumanEval 3.479MBPP 3.415LiveCodeBench 3.191模型卡自報
- 10/13
inclusionAI 發布 Ling-3.1-flash,一款原生混合推理文字模型。總參數量 560B,每 token 啟用 25B,採用 Hybrid-linear MoE 架構,支援 1M token 上下文。授權為 MIT。該模型針對複雜真實世界任務優化,涵蓋通用代理、搜尋、辦公生產力及軟體工程,在 Terminal-Bench 4.0 與 SWE-bench Pro 等基準表現強勁,適合需要長上下文與高推理能力的應用場景。
- 10/13
NVIDIA 發布 Kimodo-SOMA-RP-ArdyRep-v1.2,這是一款基於擴散模型架構的 3D 人體動作生成模型,參數量約 282M。該模型接受文字提示與姿態約束作為輸入,輸出 30 fps 的 30 關節骨骼動畫,最大時長 10 秒。其特色在於預測 Ardy 動作表示,可直接與 ARDY 模型互操作。訓練資料包含 700 小時的人體動作捕捉數據。採用 NVIDIA Open Model License 授權,允許商用,適用於遊戲開發、數位雙生及人形機器人演示等場景。
- 10/13
NVIDIA 發布 Kimodo-SOMA-RP-v1.2,这是一款 282M 參數量的 3D 骨骼動作生成模型。採用 Novel Two-Stage Transformer 架構,能根據文字提示與姿態約束生成 30 fps 的 3D 人體動畫。訓練資料包含 700 小時動作捕捉數據,v1.2 版本修正了訓練集洩漏問題並減少腳部滑動。授權為 NVIDIA Open Model License,適合遊戲、機器人演示及數位雙生應用。
- 10/12
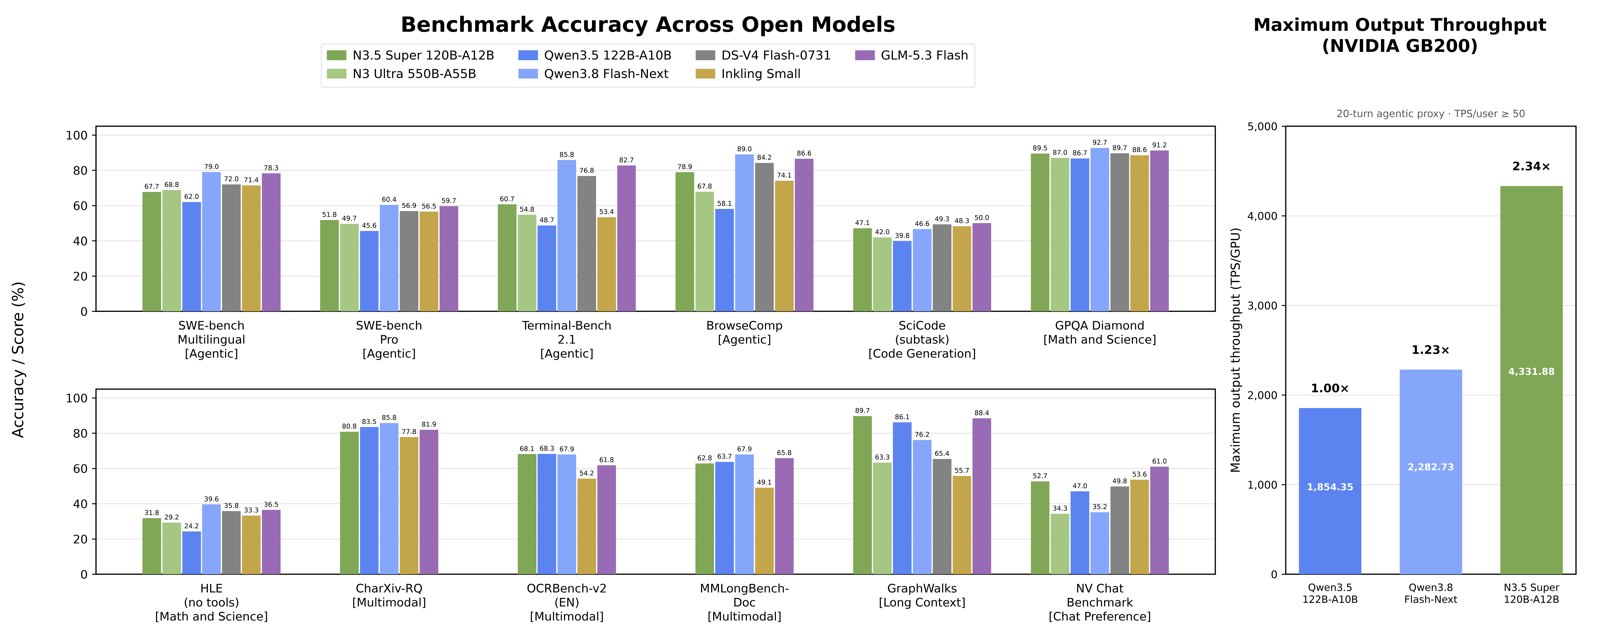
NVIDIA 發布 Nemotron 3.5 Super VL,為圖文多模態模型,總參數量 120B、啟用 12B。架構結合 Mamba-2、MoE 與 C-RADIO 視覺編碼器,支援最高 1M token 上下文。BF16 權重適合微調與全精度評估,授權為 OpenMDW-1.1,可商用。
GPQA-Diamond 89.52%MMLU-ProX 76.91%LiveCodeBench v6 88.22%SWE-bench Verified 71.1%IFBench 70.86%BrowseComp 78%模型卡自報
- 10/12
Skywork 發布 Matrix-Game-4.0,專為中世紀城堡、古埃及與城市競速場景設計的因果影片渲染模型。每個場景檢查點含 5,001,016,512 個 BF16 參數,透過執行遊戲決定物理與輸入,模型則重新渲染乾淨的低多邊形 RGB 影像。採用 Apache 2.0 授權,支援 480x864 解析度輸出,並整合 Wan2.2 VAE 與 TAEHV 編解碼器。適合用於即時遊戲畫面生成與低多邊形場景的視覺重製,需搭配特定推論原始碼使用。
- 10/12
NVIDIA 發布 Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr,為 Nemotron-3.5-Bolt-74B-A9B 之投機解碼草稿模型。此非獨立語言模型,而是透過 LiLiCorr 架構生成候選 token 加速推論。採 Dense GQA 架構,參數量 1.113B,支援 256K 上下文。授權為 OpenMDW-1.1,允許商用。適合搭配 DGX Spark 等 Blackwell 架構硬體,提升文字生成、推理與代理工作流效率。
SPEED-Bench Overall Average 4.3SPEED-Bench coding 5.26SPEED-Bench math 4.59SPEED-Bench reasoning 4.47模型卡自報
- 10/12
OpenBMB 發布 Trident-Qwen3VL-2B,這是一個參數量約 2.13B 的圖文多模態嵌入模型。該模型基於 Qwen3-VL-2B-Instruct 微調,專為混合模態檢索設計,能將文字、圖片及融合輸入映射至同一共享空間,使文字查詢可同時對純文字、純圖片及融合文件進行排序。模型已合併 LoRA 權重,無需額外基礎模型。授權採 MIT,但衍生自 Apache-2.0 基礎模型,適合需要跨模態語意搜尋的工程場景。
- 10/11
AutoTrust 發布 JEV-35B,基於 Qwen3.5-35B-A3B 架構的 MoE 模型,總參數量 35.95B,每 token 啟用約 3B 參數。此模型專為「系統一」決策設計,支援單次推論處理多達 256 個選項,無需思考模式即可進行排序與分類。上下文長度未明確標示,但強調低延遲與高吞吐。採 Apache 2.0 授權,適合需要即時推薦、搜尋重排或具身推理的應用場景。
Decision Index 0.3 (public) 59.73ERQA 51.3%Vision (rebuild) 71.94模型卡自報
- 10/11
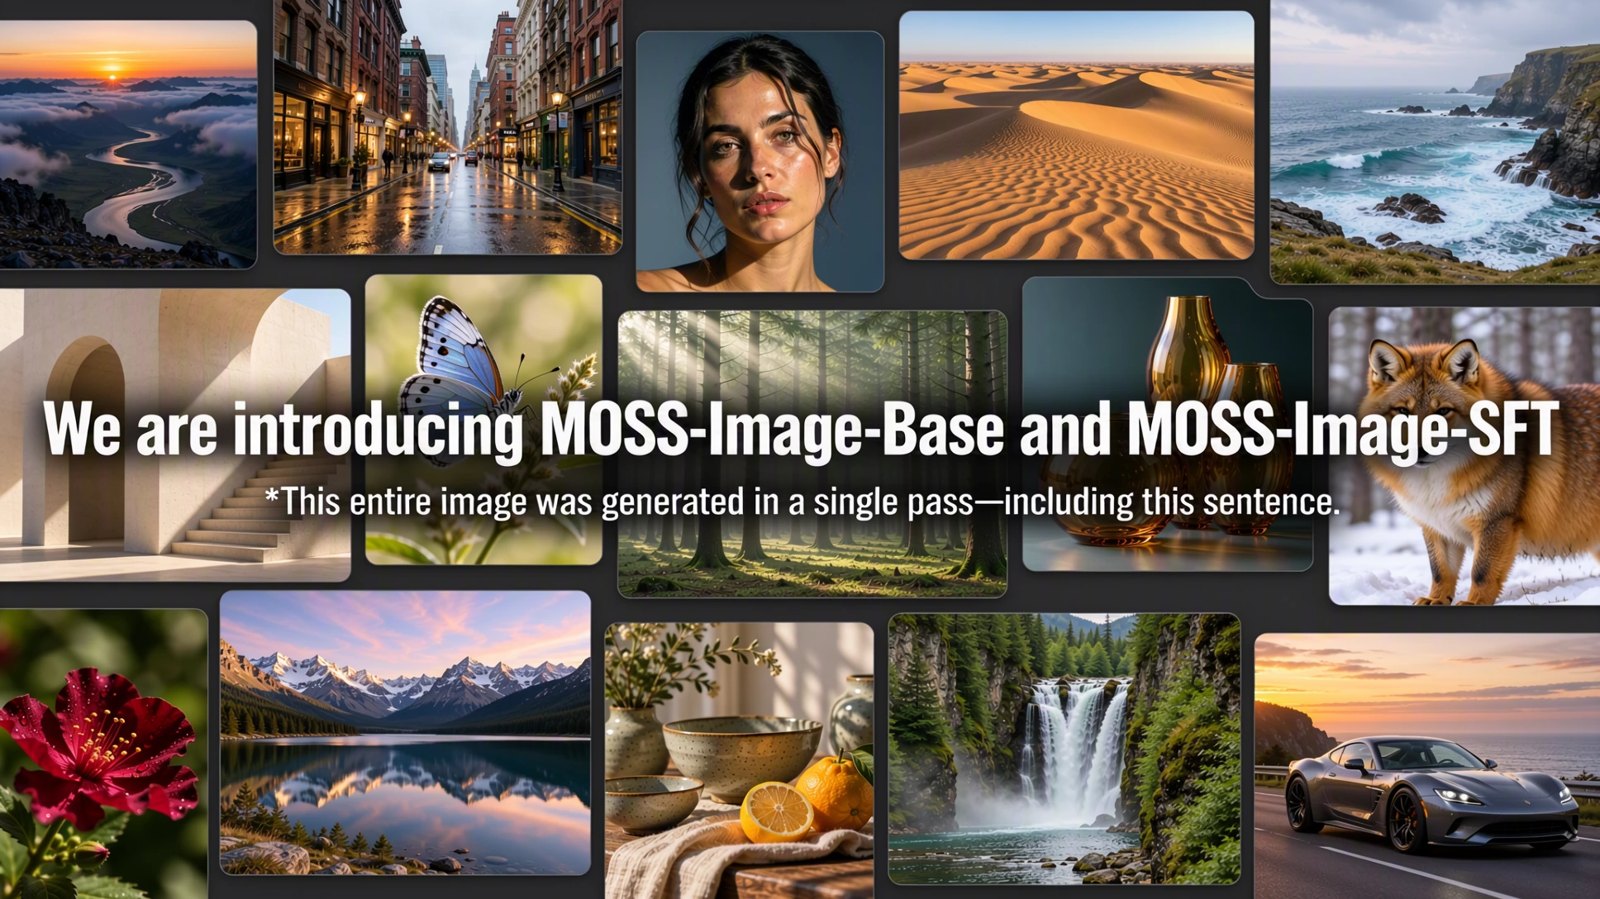
OpenMOSS 發布 MOSS-Image-SFT,為 5.1B 參數量的文字生成影像模型,採 Apache 2.0 授權可商用。此模型由 MOSS-Image-Base 微調而來,支援自然語言、標籤序列及 JSON 佈局指令,能精確控制文字位置與物件排列。架構使用 Flow-matching Euler 取樣器,預設 50 步推理,並整合 FLUX.2 小型解碼器。適合需要結構化排版或圖中文字生成的應用場景。
- 10/10
Datalab 發布 Indra OCR,一款專為 CPU 設計的輕量級圖文模型。其核心識別器僅約 1.25M 參數,預設模型總計 7.3M,無需 GPU 或 PyTorch,透過 ONNX Runtime 執行。該模型支援 80 多種語言、手寫辨識及任意角度掃描,能將 PDF 與圖片轉換為 Markdown、文字或含框線資訊的 JSON。授權採修改版 OpenRAIL-M,適合需低成本、高併發文件處理的工程場景。
OmniParseBench 66.7OmniParseBench (math) 71.4OmniParseBench (text) 46.7OmniParseBench (handwriting) 25.2%模型卡自報
- 10/10
vLLM Semantic Router 團隊發布 d3,這是 Decision 3.0 的 27B 多模態決策基礎模型。參數量 26.09B(含 0.46B 視覺編碼器),支援文字、JSON、圖片與影片輸入。不同於生成式模型,它透過單次呼叫直接輸出選項機率,處理選擇、是非與評分任務。上下文長度 262,144 tokens,採 Apache 2.0 授權。適合需要低延遲、結構化決策的路由或分類場景,並已整合進 vLLM 原生服務。
Jev Decision Index 0.3.2 66.3Perception Test 77.4%模型卡自報
- 10/09
Qwen 發布 Qwen-Image-2.1-Turbo,為 7.1B 參數量的文字轉圖像與圖像編輯模型。此為加速檢查點,僅需 8 步去噪即可生成,內建推薦取樣排程,預設 CFG=1 並支援前綴 KV 快取以重用上下文。採用 7B 視覺生成架構,可直接透過 Diffusers 的 QwenImage21Pipeline 載入,適合追求高效能推論的應用場景。
- 10/09
Liquid AI 發布 LFM2.5-24B-A2B,這是一款專為裝置端代理設計的純文字推理模型。採用 MoE 架構,總參數量 24B,每次推論僅啟用 2.45B 參數,支援 131K 上下文長度。訓練數據達 36 兆 token,強化推理、程式碼與多語能力。授權為其他類型(Other),適合需要低延遲、隱私保護且能執行工具呼叫的本地端代理應用。
LiveClaw 48.09模型卡自報
- 10/09
autotrust 發布 GLM5.3-Flash-E192-DGX-Spark,這是基於 zai-org/GLM-5.3-Flash 的非官方衍生圖文多模態模型。透過神經架構搜尋保留每層 192 個路由專家,權重佔用 124 GiB,每 token 啟用 18B 參數。支援 66,560 上下文長度,採用 MIT 授權。內建 NVFP4 MTP 草稿模型,在單張 B200 上可達 1.80 倍解碼速度,適合在雙 DGX Spark 或單張 180GB Blackwell GPU 部署。
HumanEval 93.9%GPQA-Diamond 79.8%GPQA-Diamond (effort=max) 84.8%C-Eval val 78.3%AIME 2025 80%MMMU val 70.7%模型卡自報
- 10/09
Cloudflare 發布 Clef-Omni,基於 Qwen3-Omni 微調的 30B-A3B MoE 多模態模型。它結合視覺與音訊編碼器,能讀取文字、圖片、音訊或影片,透過 Joint schema head 在單次前向推論中直接輸出結構化決策機率,無需自由文本生成。支援 64K 上下文,採 Apache 2.0 授權,適合需要高準確度分類與路由的自動化場景。
BFCL (case exact accuracy) 98.2%API-Bank (accuracy) 92.7%BANKING77 (macro-F1) 94.8%CLINC150+OOS (macro-F1) 97.7%MMLU (accuracy) 92.7%GPQA Diamond (accuracy) 47.4%模型卡自報
- 10/09
autotrust 發布 GLM5.3-Flash-E256-DGX-Spark,為 zai-org/GLM-5.3-Flash 的非官方衍生版,專為 Blackwell 架構最佳化。此圖文多模態模型總參數量 144.54B,透過 NAS 保留 256 個路由專家,每 token 啟用 18B 參數。採用 NVFP4 權重與 FP8 KV Cache,支援 66K 上下文。內建 MTP 草稿模型可提升推論速度 1.84 倍,適合單張 B200 或 DGX Spark 叢集部署,具備 MIT 授權。
HumanEval 97.6%GPQA-Diamond 77.3%C-Eval val 89.4%AIME 2025 74.2%MMMU val 76.1%BFCL v4 Non-Live AST 87.7%模型卡自報
- 10/09
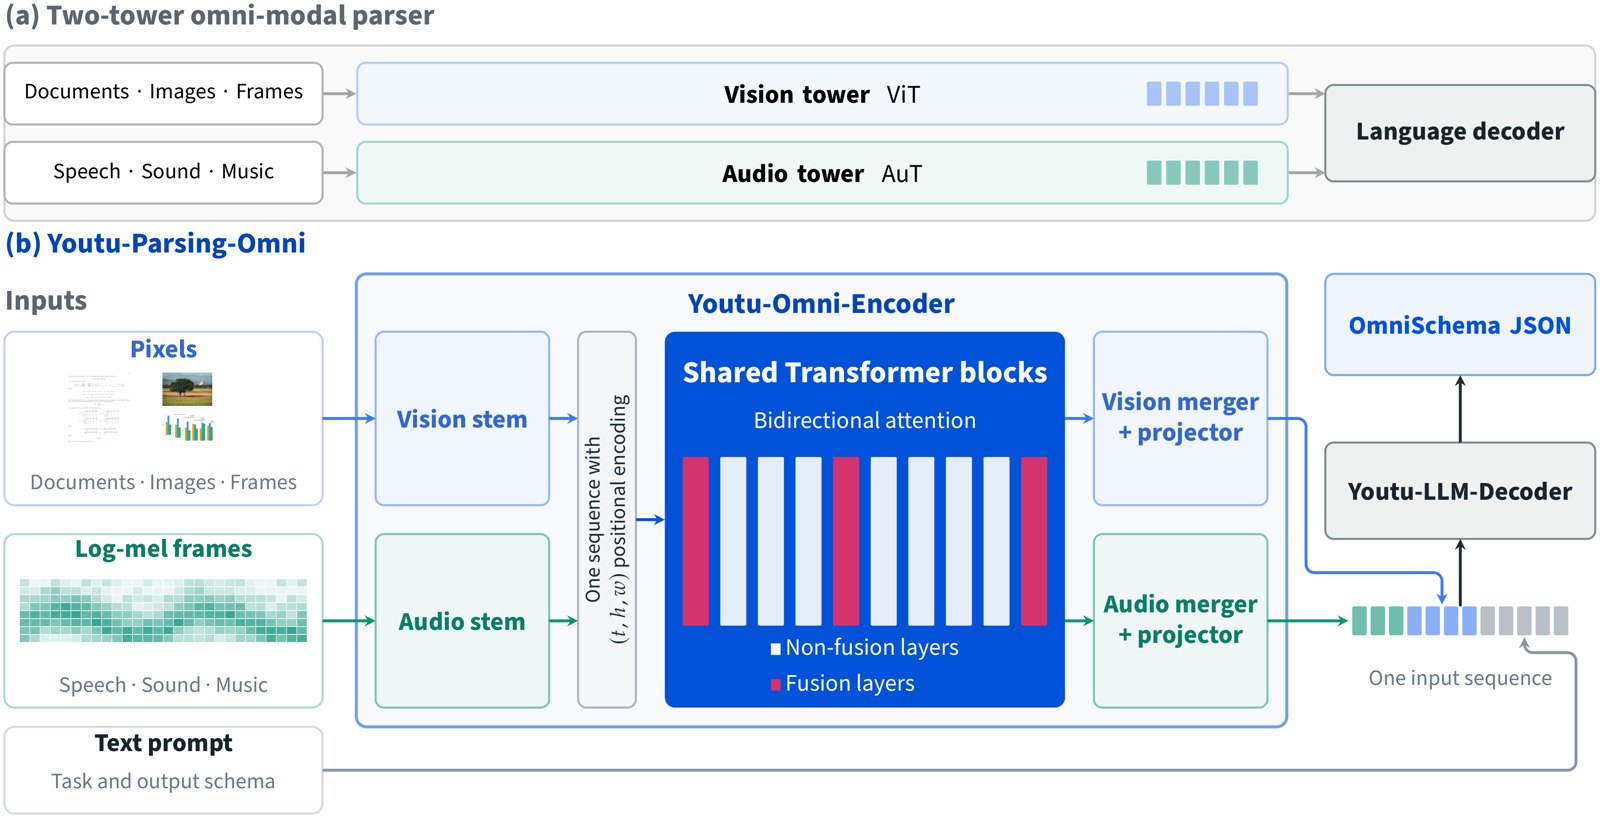
騰訊發布 Youtu-Parsing-Omni,一款 5.3B 參數的全模態解析模型。它整合單一編碼器處理文件、圖片、圖表、幾何圖形、音訊及影片,輸出結構化 JSON。架構上採用 OmniSchema 與 OSAD 訓練法,支援圖片、音訊與影音輸入。授權為其他類型,適合需將多模態內容轉換為結構化資料的工程場景。
OmniDocBench v1.6 Overall 96.96OmniDocBench v1.6 Text Edit 0.0271OmniDocBench v1.6 Formula CDM 96.8OmniDocBench v1.6 Table TEDS 96.79OmniDocBench v1.6 Table TEDS-S 98.2OmniDocBench v1.6 Reading Order Edit 0.1104模型卡自報
- 10/09
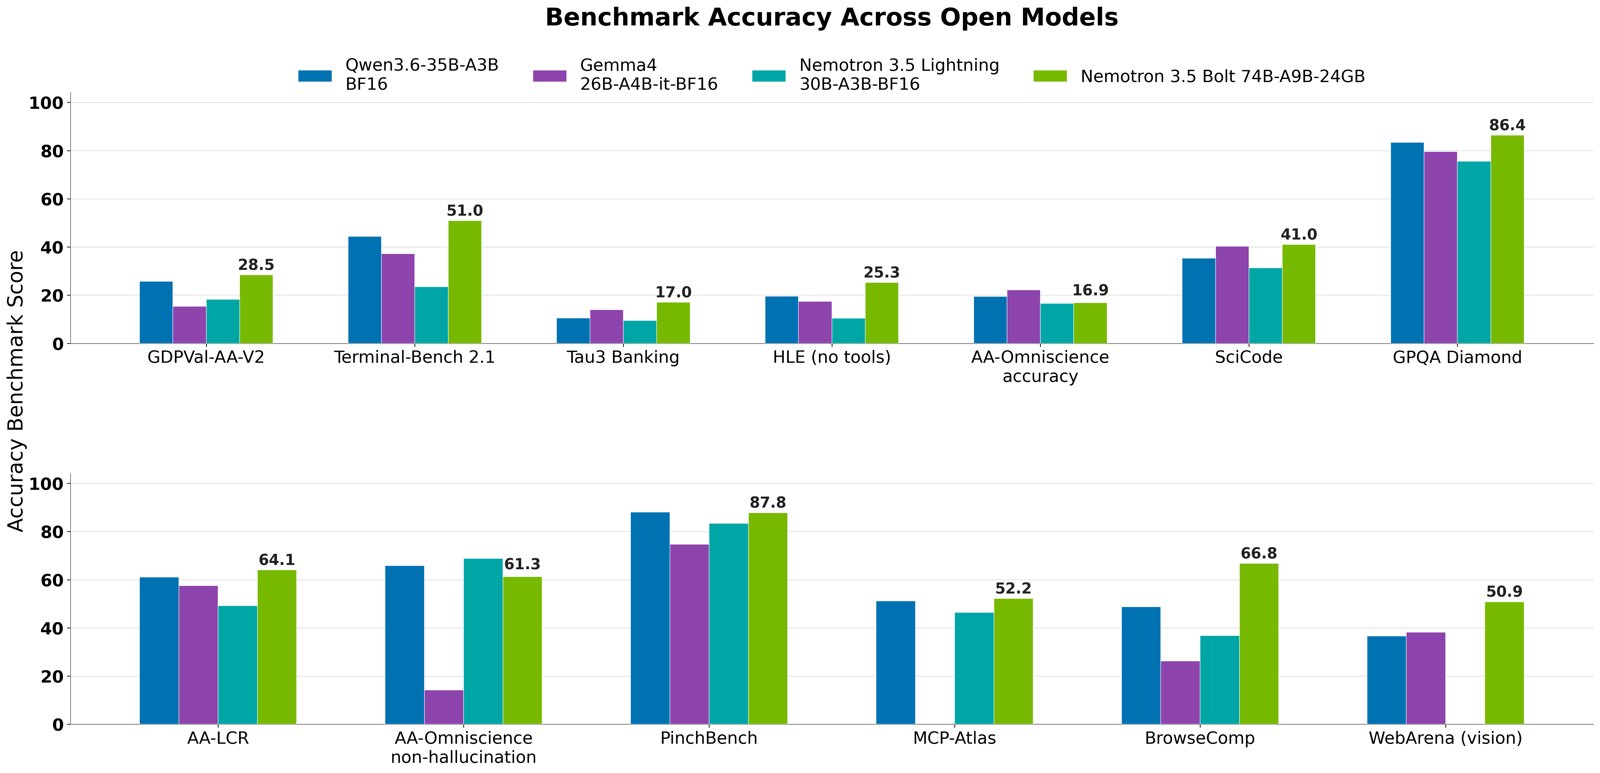
NVIDIA 發布 Nemotron-3.5-Bolt-74B-A9B-BF16,这是一款圖文多模態模型,總參數量 74B,每次推論啟用 9B 參數。架構採用 Mamba-2 與 Transformer 混合的 LatentMoE,並整合 C-RADIO v4-H 視覺編碼器。支援高達 256K token 的上下文長度,輸入涵蓋文字、圖片與影片。此 BF16 全精度版本主要用於客製化、後訓練及產出量化變體,而非直接生產部署。授權為 OpenMDW-1.1,允許商用,適合開發者進行微調或研究。
GPQA Diamond 88.83%Terminal-Bench 2.1 53.93%HLE (no tools) 28.73%SciCode 44.49%AA-LCR 67.38%BrowseComp 70%模型卡自報
- 10/08
NVIDIA 發布 Qwen3.8-Flash-Next-FP4-Local,這是基於 Alibaba Qwen3.8-Flash-Next 的量化版本,總參數量 125B(啟用 6B)。模型採用混合注意力與 MoE 架構,原生支援 262K 上下文,可擴展至 1M。透過量化感知蒸餾技術,在保持高效能下大幅降低記憶體需求,適合部署於 AI Agent、聊天機器人及 RAG 系統。授權採 NVIDIA Open Model Agreement,允許商用。
GPQA Diamond 91.5%ToolEvalBench 88.7%模型卡自報
- 10/08
NVIDIA 發布 GLM-5.3-Flash-FP4-Local,為 ZAI GLM-5.3-Flash 的量化版本。此模型採混合稀疏與線性注意力架構,總參數量 320B(啟用 18B),支援文字、圖片與影片輸入,上下文長度達 1M。透過量化感知蒸餾技術,模型約需 166 GiB vRAM,專為 NVIDIA Blackwell 架構優化,適合本地部署 AI 代理與 RAG 系統。授權採 NVIDIA Open Model Agreement,可商用。
GPQA Diamond 91.3%ToolEvalBench 92.4%模型卡自報
- 10/08
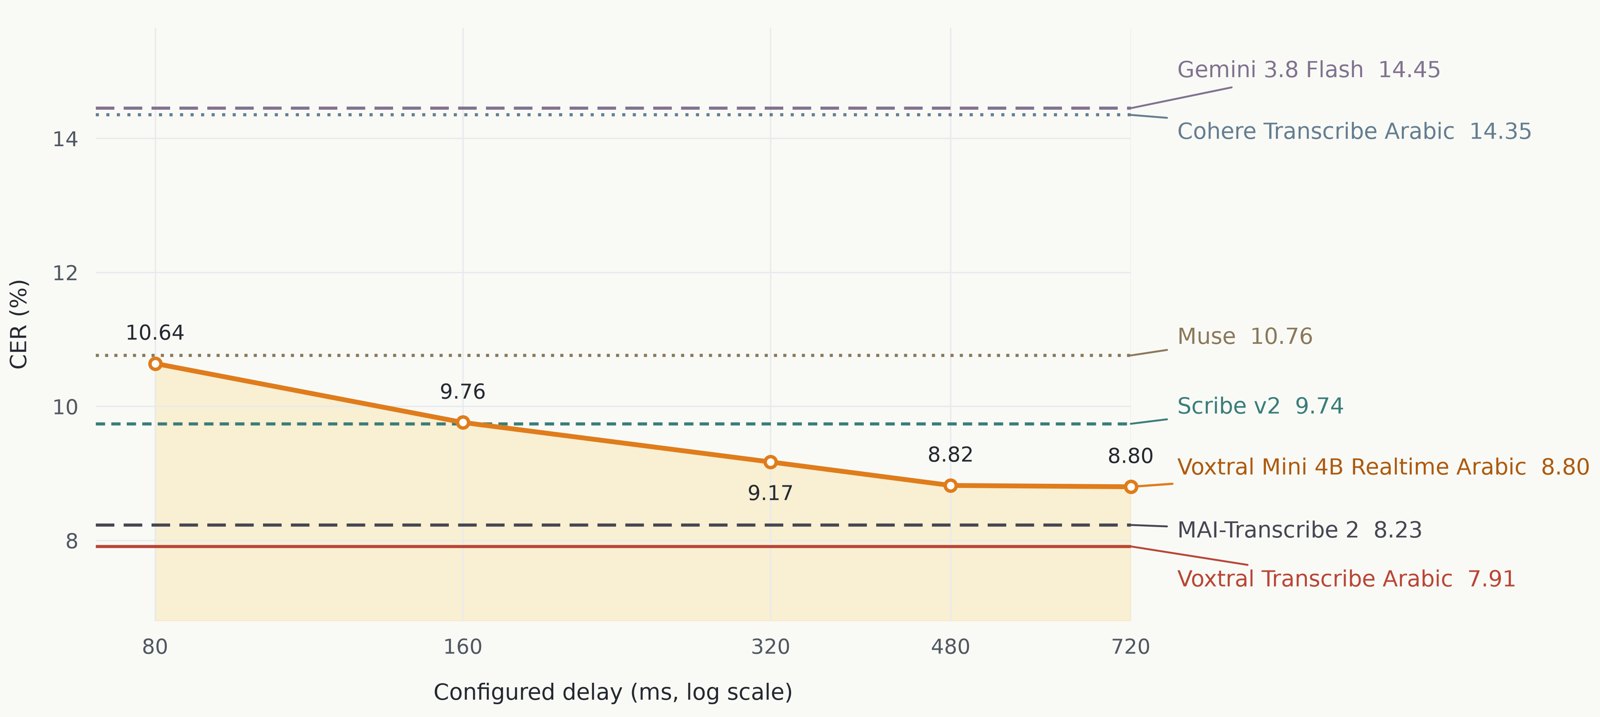
Mistral AI 發布 Voxtral Mini 4B Realtime Arabic,專為阿拉伯語方言與標準阿拉伯語設計的串流語音轉文字模型。基於 4.4B 參數架構,採用 BF16 權重,透過因果音頻編碼器處理 16 kHz 音訊。支援語言切換(code-switching),可配置轉錄延遲以適應即時字幕應用。授權為 Apache 2.0,適合開發阿拉伯語即時語音介面。
Average CER 8.82%模型卡自報
- 10/08
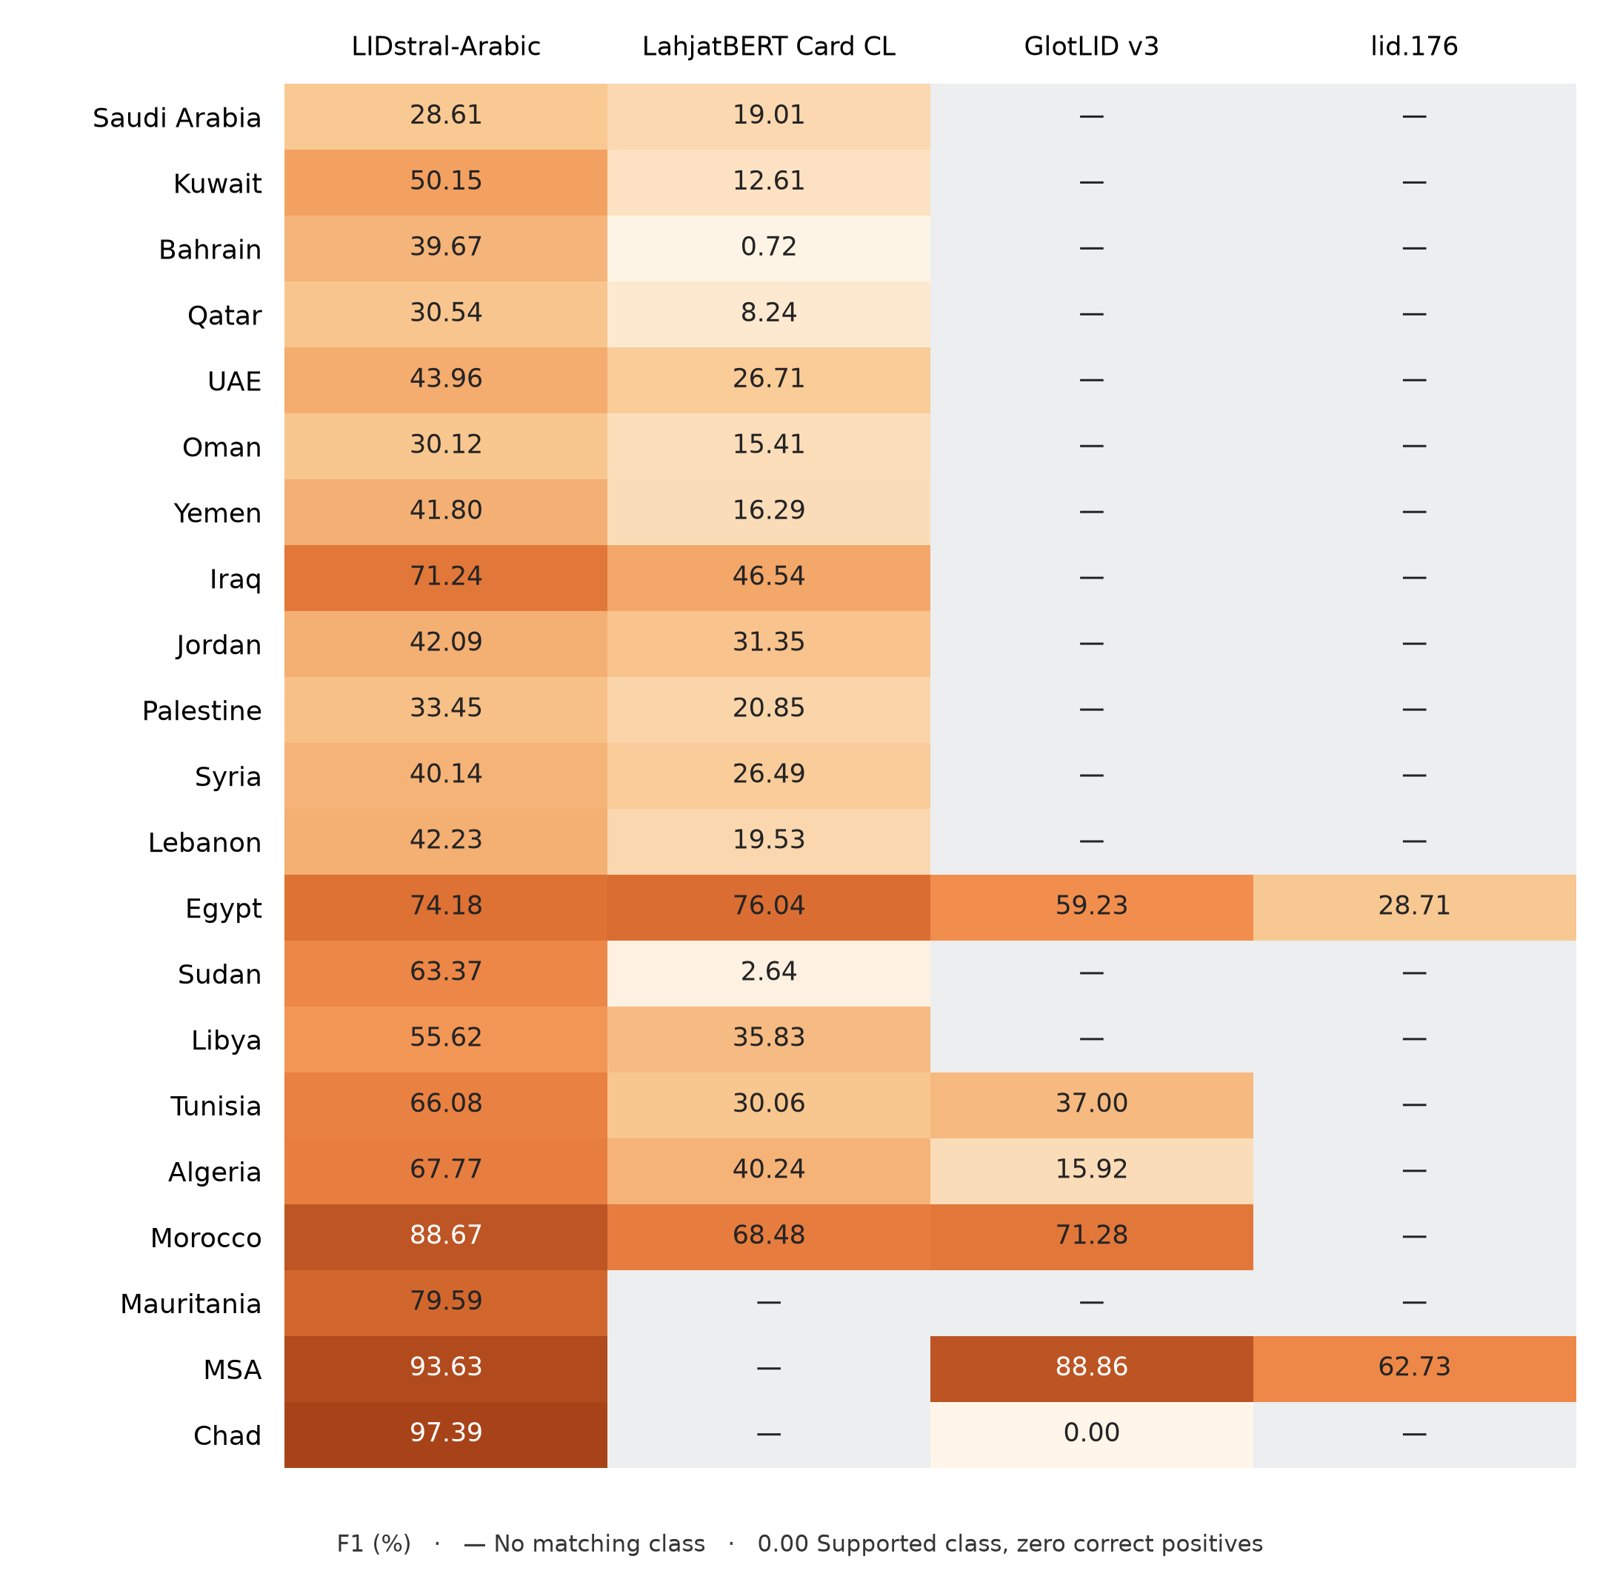
Mistral AI 發布 LIDstral-Arabic,這是一個專為阿拉伯文字腳本設計的快速語言與方言分類器。該模型採用 fastText OVA、MLP stacker 與 isotonic calibration 架構,能辨識現代標準阿拉伯語、各地方言及共用文字的其他語言。模型支援 51 個類別,在 CPU 上即可執行推論,無需大型參數量。採用 Apache 2.0 授權,適合用於多語言內容過濾、資料標註或需要區分阿拉伯語變體的工程場景。
Moroccan Darija F1 88.67%模型卡自報











收錄規則:大型實驗室與台灣在地組織的新 repo,以及熱門榜上組織帳號、讚數達門檻的模型;第三方量化、轉檔、合併版本不收。同一系列同一批多個尺寸合為一筆。