k2-fsa/OmniVoice 是 GitHub 上的開源專案,本站記錄時 16,125 星;一天內新增約 586 顆星。我們在一台 RTX A6000 48 GB 工作站 上,從安裝到跑出結果整段錄下終端機;測的是 2026-08-24 的版本(commit 08be0b4ccbac)。實測影片公開後會嵌在本文最下方。
背景
OmniVoice 是一個支援超過 600 種語言的零樣本文字轉語音(TTS)模型,採用擴散語言模型架構。它旨在解決多語言語音生成中品質與速度難以兼顧的問題,同時提供高品質的語音克隆與語音設計功能。
透過分配說話者屬性(如性別、年齡、音調、口音等),使用者可以在沒有參考音訊的情況下「設計」出特定風格的語音。此外,它還支援非語言符號(如 [laughter])和發音修正,讓生成的語音更具表現力。
運作方式與使用方式
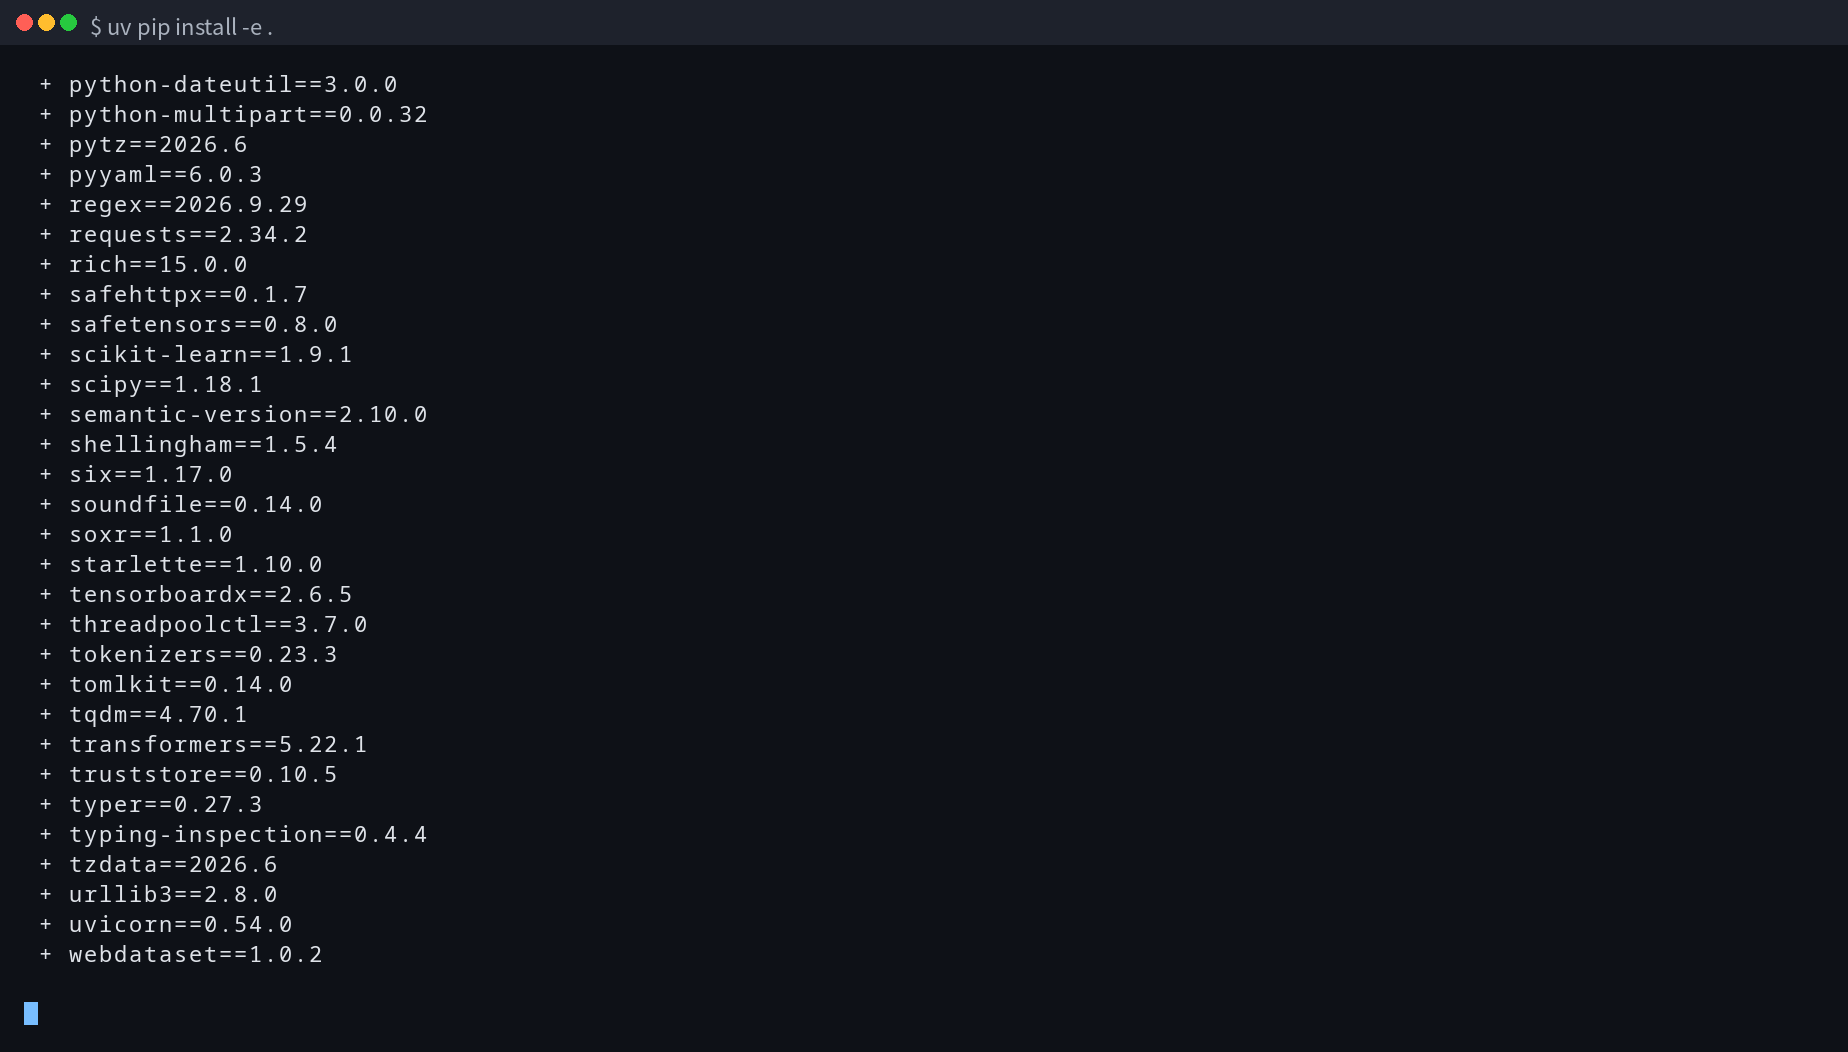
我們使用 uv 作為套件管理工具,在 Ubuntu 環境下安裝 PyTorch 2.8.0+cu128 與 OmniVoice 0.2.1。安裝過程分為兩步:先安裝 PyTorch 相關依賴,再透過 pip install -e . 安裝 OmniVoice 本身及其依賴項(包括 transformers、gradio 等)。
生成語音主要透過命令列工具 omnivoice-infer 完成。基本用法是指定模型名稱(k2-fsa/OmniVoice)、輸入文字(--text)和輸出檔案(--output)。若要使用語音設計功能,可加上 --instruct 參數指定說話者特徵,例如 'female, low pitch, british accent'。
與未使用時的差異
| 情境 | 不用它 | 用它 |
|---|---|---|
| 多語言支援 | 需尋找特定語言模型或僅支援少數主流語言 | 原生支援 600+ 種語言,無需額外配置 |
| 語音風格控制 | 僅能使用預設聲音或需大量參考音訊進行克隆 | 可透過文字指令設計性別、口音、音調等屬性 |
| 非語言表達 | 通常忽略或需後製處理 | 支援 [laughter] 等非語言符號,直接生成語氣 |
| 推理速度 | 傳統 TTS 模型延遲明顯 | 專案方自報高推理速度,實測後續生成極快 |
安裝與執行過程
| 步驟 | 指令 | 結果 |
|---|---|---|
| 環境檢查 | uname -a; python3 --version; nvidia-smi ... | 結束碼 0,0.2 秒。確認環境為 Python 3.12.3,GPU 為 NVIDIA RTX A6000 (49140 MiB)。 |
| 取得程式碼 | git clone ... && git checkout 08be0b4ccbac | 結束碼 0,2.4 秒。成功取得 commit 08be0b4ccbac,專案大小 2.2M。 |
| 安裝 PyTorch | uv pip install torch==2.8.0+cu128 torchaudio==2.8.0+cu128 ... | 結束碼 0,365.5 秒。成功安裝 torch 2.8.0+cu128 及相關 CUDA 庫。 |
| 安裝 OmniVoice | uv pip install -e . | 結束碼 0,355.5 秒。成功安裝 omnivoice 0.2.1 及其 80 個依賴套件。 |
| 語音設計生成 | omnivoice-infer --model k2-fsa/OmniVoice --text '...' --instruct '...' --output demo_design.wav | 結束碼 0,328.2 秒。包含模型下載與載入時間,成功生成 demo_design.wav。 |
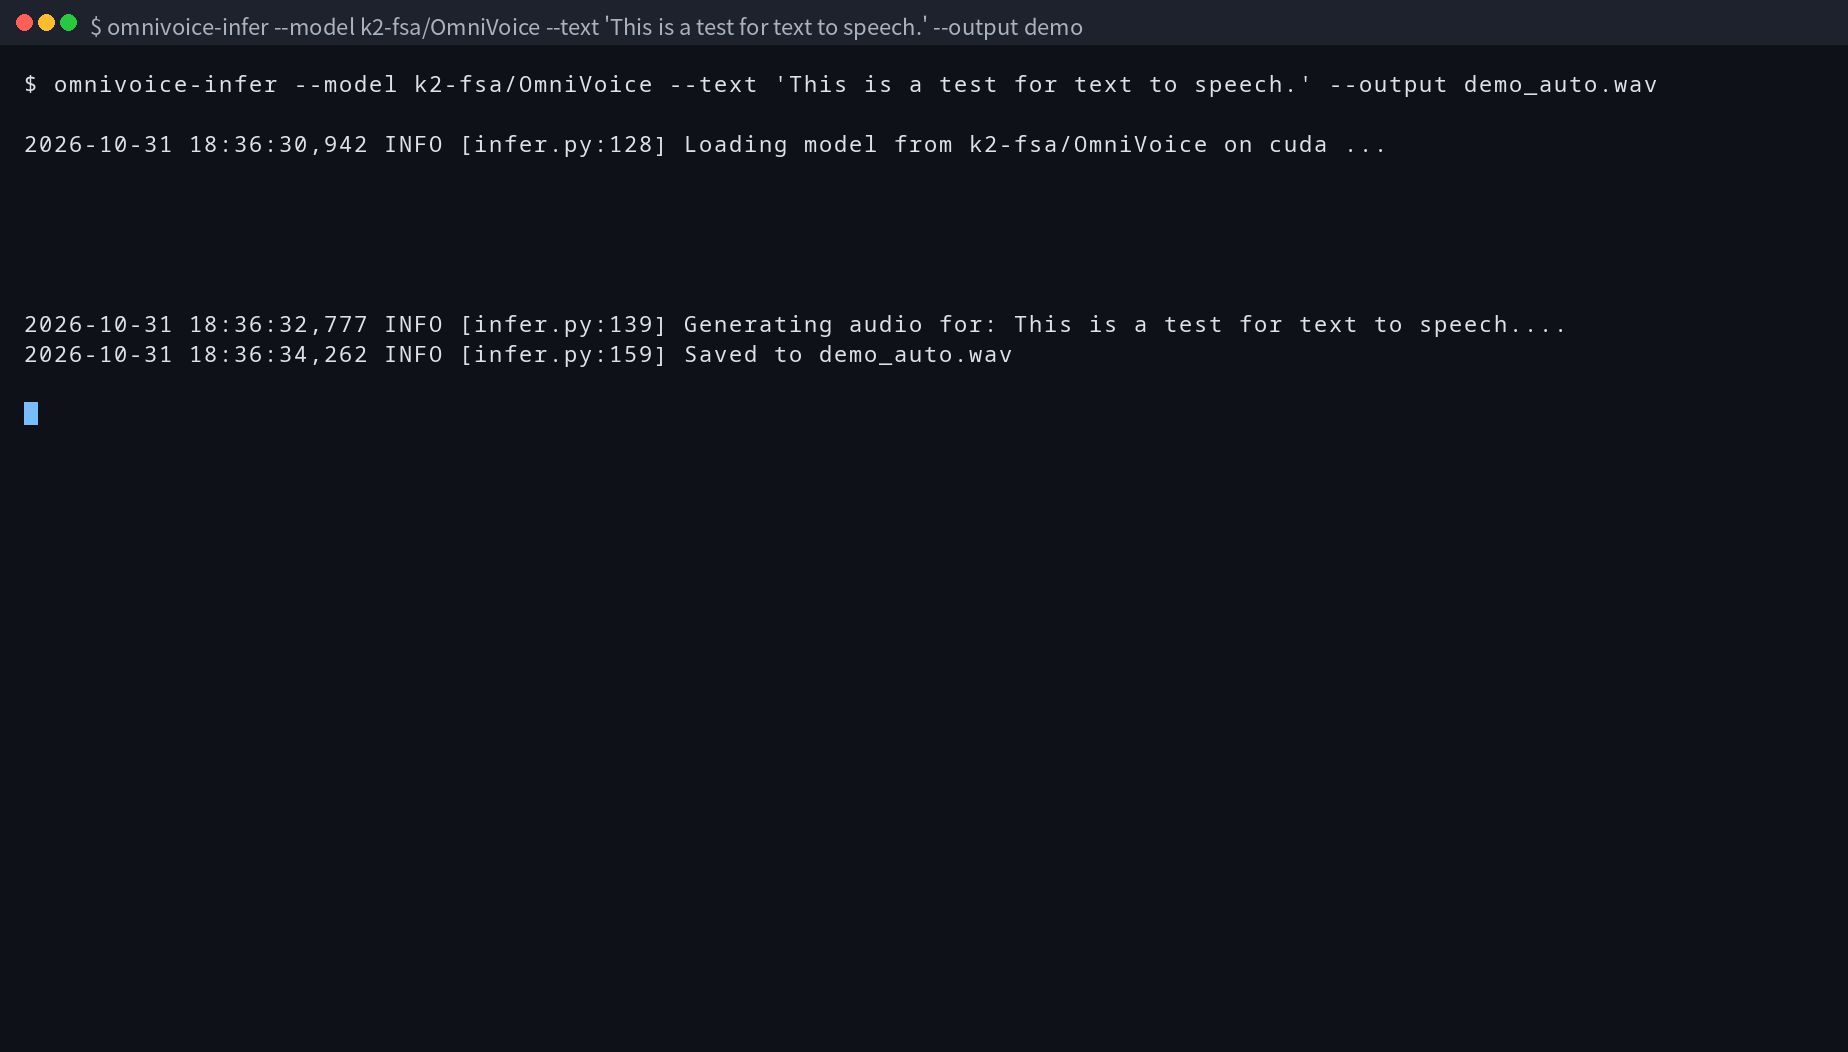
| 自動語音生成 | omnivoice-infer --model k2-fsa/OmniVoice --text '...' --output demo_auto.wav | 結束碼 0,6.9 秒。模型已載入,推理速度快,成功生成 demo_auto.wav。 |
| 非語言符號測試 | omnivoice-infer --model k2-fsa/OmniVoice --text '[laughter] ...' --output demo_nonverbal.wav | 結束碼 0,6.8 秒。成功處理 [laughter] 符號並生成語音。 |
結果驗證
所有步驟結束碼均為 0,安裝與執行過程順利。首次執行 omnivoice-infer 時,由於需要從 Hugging Face 下載模型權重,總耗時 328.2 秒,其中大部分時間花在模型載入。一旦模型載入完成,後續的推理速度非常快,生成一句話總耗時僅 6.9 秒,符合專案方自報的高推理速度優勢。
我們成功驗證了語音設計功能,透過 --instruct 參數指定 'female, low pitch, british accent',模型能生成符合描述的語音。此外,非語言符號 [laughter] 也被正確解析並生成對應的語音片段,顯示其對細粒度控制的支援良好。

遇到的問題
這次沒有遇到需要另外處理的問題。
結論
OmniVoice 適合需要高品質、多語言語音生成且對推理速度有要求的研究人員或開發者。其語音設計功能提供了靈活的風格控制,無需參考音訊即可生成特定風格的語音。然而,首次使用時需下載較大的模型權重,且安裝過程需處理 PyTorch 與 CUDA 版本相容性,對新手可能稍有門檻。
- 它是什麼、解決什麼問題:k2-fsa/OmniVoice 是什麼:支援 600 多種語言的零樣本文字轉語音模型
- 照著做的安裝教學:k2-fsa/OmniVoice 安裝與使用教學:在 Linux 工作站三步裝好