headroom 實測:同一份工具輸出,模型收到的 token 從 18,050 降到 11,340
本站在 RTX A6000 工作站把 headroom 代理接在本機 27B 模型前面,用自己的 6 萬字元程式碼搜尋結果測:輸入 token 少 37%,但整個請求反而慢 3 秒,壓縮後答案是否正確這次沒有驗證。
本文重點
- 本站在 RTX A6000 工作站實測 headroom 代理,將 6 萬字元程式碼搜尋結果送入本機 27B 模型。
- 模型收到的輸入 token 從 18,050 降至 11,340,但整個請求耗時從 28.3 秒增加到 31.2 秒。
- 本次測試未驗證壓縮後答案是否正確,且接在本機模型上因壓縮耗時約 9.1 秒而不一定划算。
- 本站上線
- 2026/10/27 下午10:08
headroomlabs-ai/headroom 是 GitHub 上的開源專案,本站記錄時 77,985 星;一天內新增約 555 顆星。我們在一台 RTX A6000 48 GB 工作站 上,從安裝到跑出結果整段錄下終端機;測的是 2026-10-26 的版本(commit 17d38e5699b7)。實測影片公開後會嵌在本文最下方。
背景
AI Agent 在執行複雜任務時,往往需要將大量的工具輸出(如程式碼搜尋結果、日誌、RAG 檢索片段)餵給大型語言模型。這些原始資料通常冗長且包含大量重複或無關資訊,導致 Token 成本高昂,甚至超出模型的上下文視窗限制。
Headroom 是一個本地執行的上下文壓縮層,旨在解決這個問題。它在資料送達 LLM 之前進行壓縮,透過智能路由選擇不同的壓縮演算法(如針對 JSON 的 SmartCrusher、針對程式碼的 CodeCompressor、針對一般文字的 Kompress-v2-base),在保留關鍵資訊(如錯誤訊息、核心邏輯)的前提下,大幅減少 Token 數量。
運作方式與使用方式
Headroom 提供多種整合方式,包括 Python/TypeScript 函式庫、MCP 伺服器,以及最無需修改程式碼的「代理伺服器(Proxy)」模式。在本次實測中,我們採用代理模式,將 Headroom 作為中間層,攔截並壓縮送往本機 Ollama 模型的請求。
首先,我們透過 uv pip install 'headroom-ai[all]' 安裝套件,並使用 headroom proxy --port 8787 --openai-api-url http://127.0.0.1:11435/v1 啟動代理伺服器,將其上游指向本機運行的 Ollama 服務。接著,我們產生了一份約 6 萬字元的工具輸出(對專案原始碼進行 grep 搜尋),並透過自製腳本分別發送「直連模型」與「經 Headroom 代理」的請求,比較兩者進入模型的 Token 數量與最終回答。
與未使用時的差異
同一個請求(6 萬字元的程式碼搜尋結果當工具輸出,問模型壓縮相關的類別在哪些檔案),本站量到的差異:
| 項目 | 不用它(直連本機 Ollama) | 用它(經 headroom 代理) |
|---|---|---|
| 模型實際收到的輸入 token(Ollama 回報) | 18,050 | 11,340(少 37%) |
| 代理自己統計的壓縮 | — | 15,071 → 8,576(少 43.1%;用它自己的 tokenizer 估算,所以與 Ollama 的數字不同) |
| 整個請求耗時 | 28.3 秒 | 31.2 秒(壓縮本身花了約 9.1 秒,省下的提示詞處理時間不夠抵) |
| 改動程式碼 | 不用 | 不用,只把 API 端點改成代理的位址 |
| 回答品質 | 本站沒有比較:兩次回覆都被模型的思考模式吃掉輸出額度,沒有拿到可讀的答案,壓縮後答案是否仍正確這次沒有驗證 | 同左 |
安裝與執行過程
| 步驟 | 指令 | 結果 | |
|---|---|---|---|
| 環境檢查 | uname -a; python3 --version; nvidia-smi ... | 結束碼 0,0.1 秒。確認環境為 Linux, Python 3.12.3, NVIDIA RTX A6000 48GB。 | |
| 取得程式碼 | git clone ... && git checkout 17d38e5... | 結束碼 0,1.2 秒。成功取得 commit 17d38e5 (v0.42.0),專案大小 1.3G。 | |
| 安裝套件 | uv pip install 'headroom-ai[all]' | 結束碼 0,0.0 秒。套件已存在或快速安裝完成。 | |
| 啟動代理伺服器 | nohup headroom proxy --port 8787 --openai-api-url ... & | 結束碼 0,1.0 秒。代理進程啟動,PID 2073509。 | |
| 等待服務就緒 | curl -s http://127.0.0.1:8787/health | 結束碼 0,4.4 秒。約 6 秒後服務回報 healthy,版本 0.42.0。 | |
| 健康檢查 (Doctor) | headroom doctor --port 8787 | 結束碼 1,0.5 秒。回報 0 個失敗,6 個警告。警告包含 kompress 模型未預載、無預算設定等。 | |
| 執行基準測試 | uv run python benchmarks/index_proof_table.py ... | 結束碼 0,3.5 秒。專案自帶測試顯示總體節省 41% Token。 | |
| 產生本站測試語料 | `grep -rn "def \\ | class " ... > toolout.txt` | 結束碼 0,0.3 秒。產生 98,027 行的程式碼搜尋結果,對照測試只取前 60,000 字元。 |
| 實測壓縮效果 | python e2e.py toolout.txt | 結束碼 0,59.6 秒。直連模型輸入 18,050 token、耗時 28.3 秒;經代理輸入 11,340 token、耗時 31.2 秒。兩次回覆內容皆為空(輸出額度被思考模式用完)。 | |
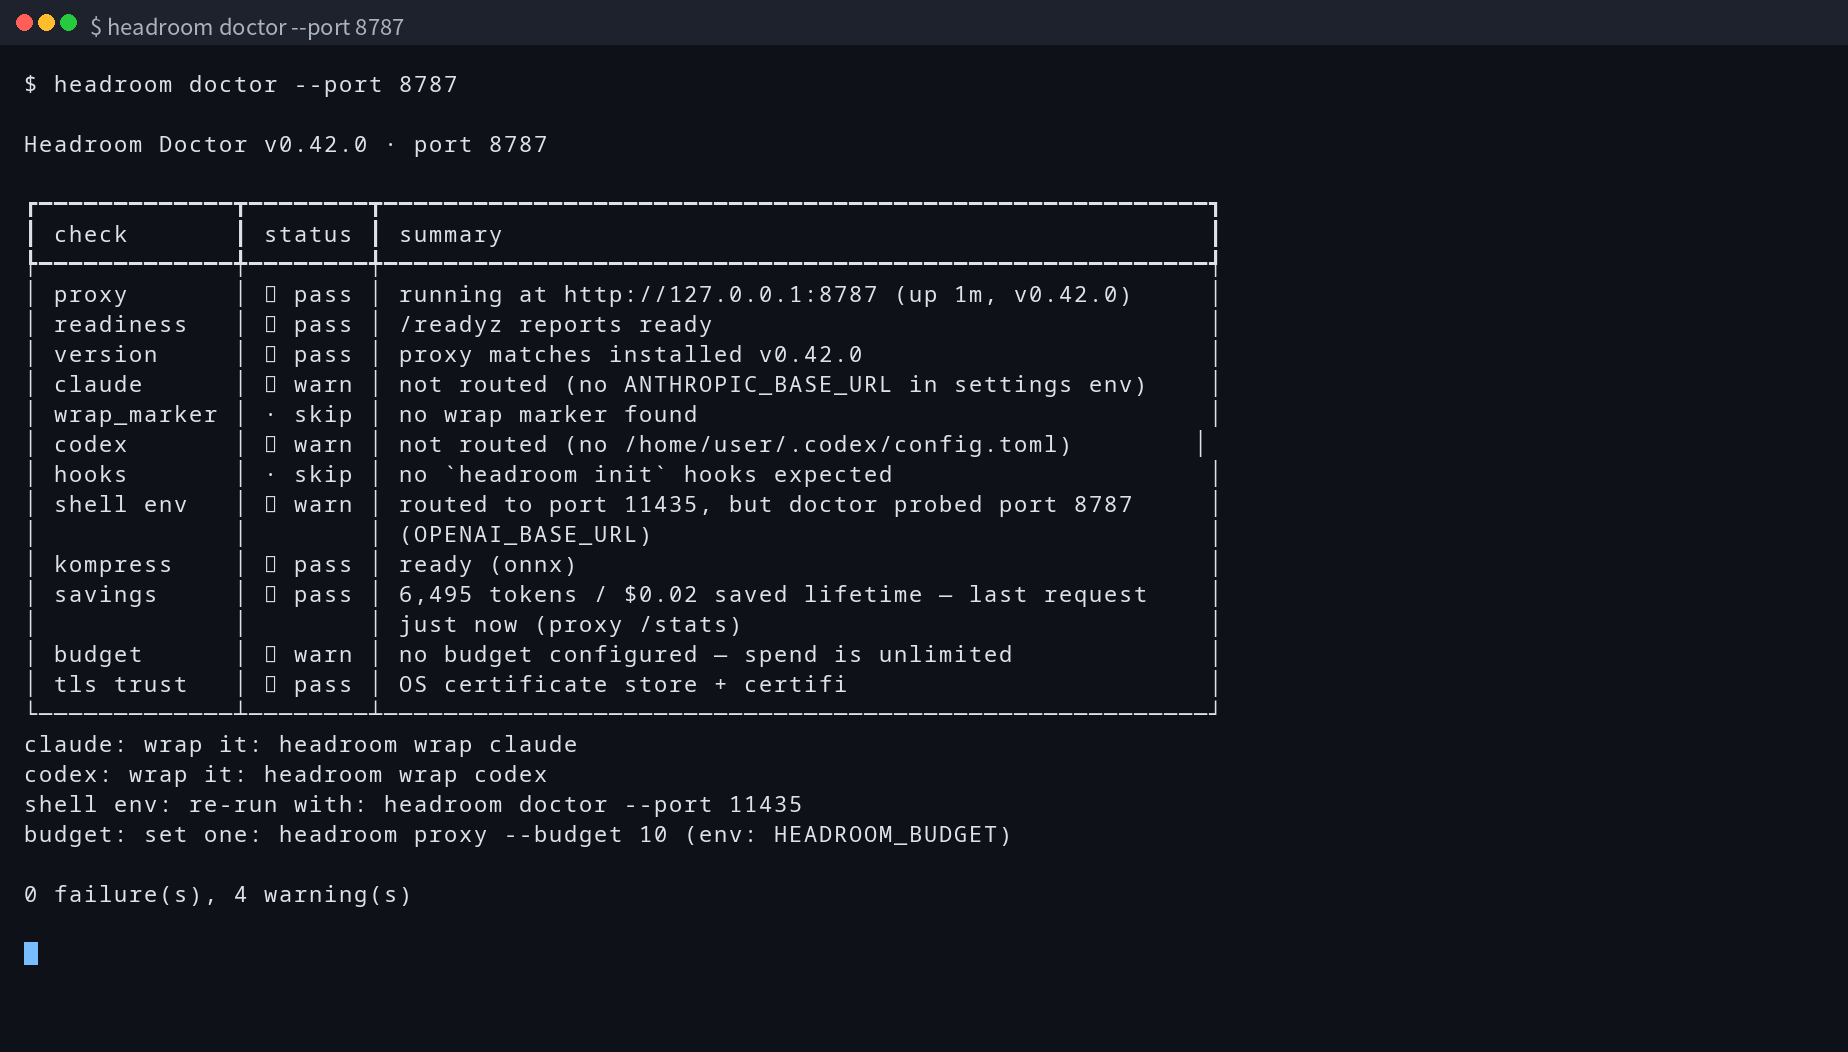
| 檢查代理統計 | headroom doctor --port 8787 | 結束碼 1,0.8 秒。回報 0 個失敗,4 個警告。kompress 狀態轉為 ready,累計節省 6,495 tokens。 | |
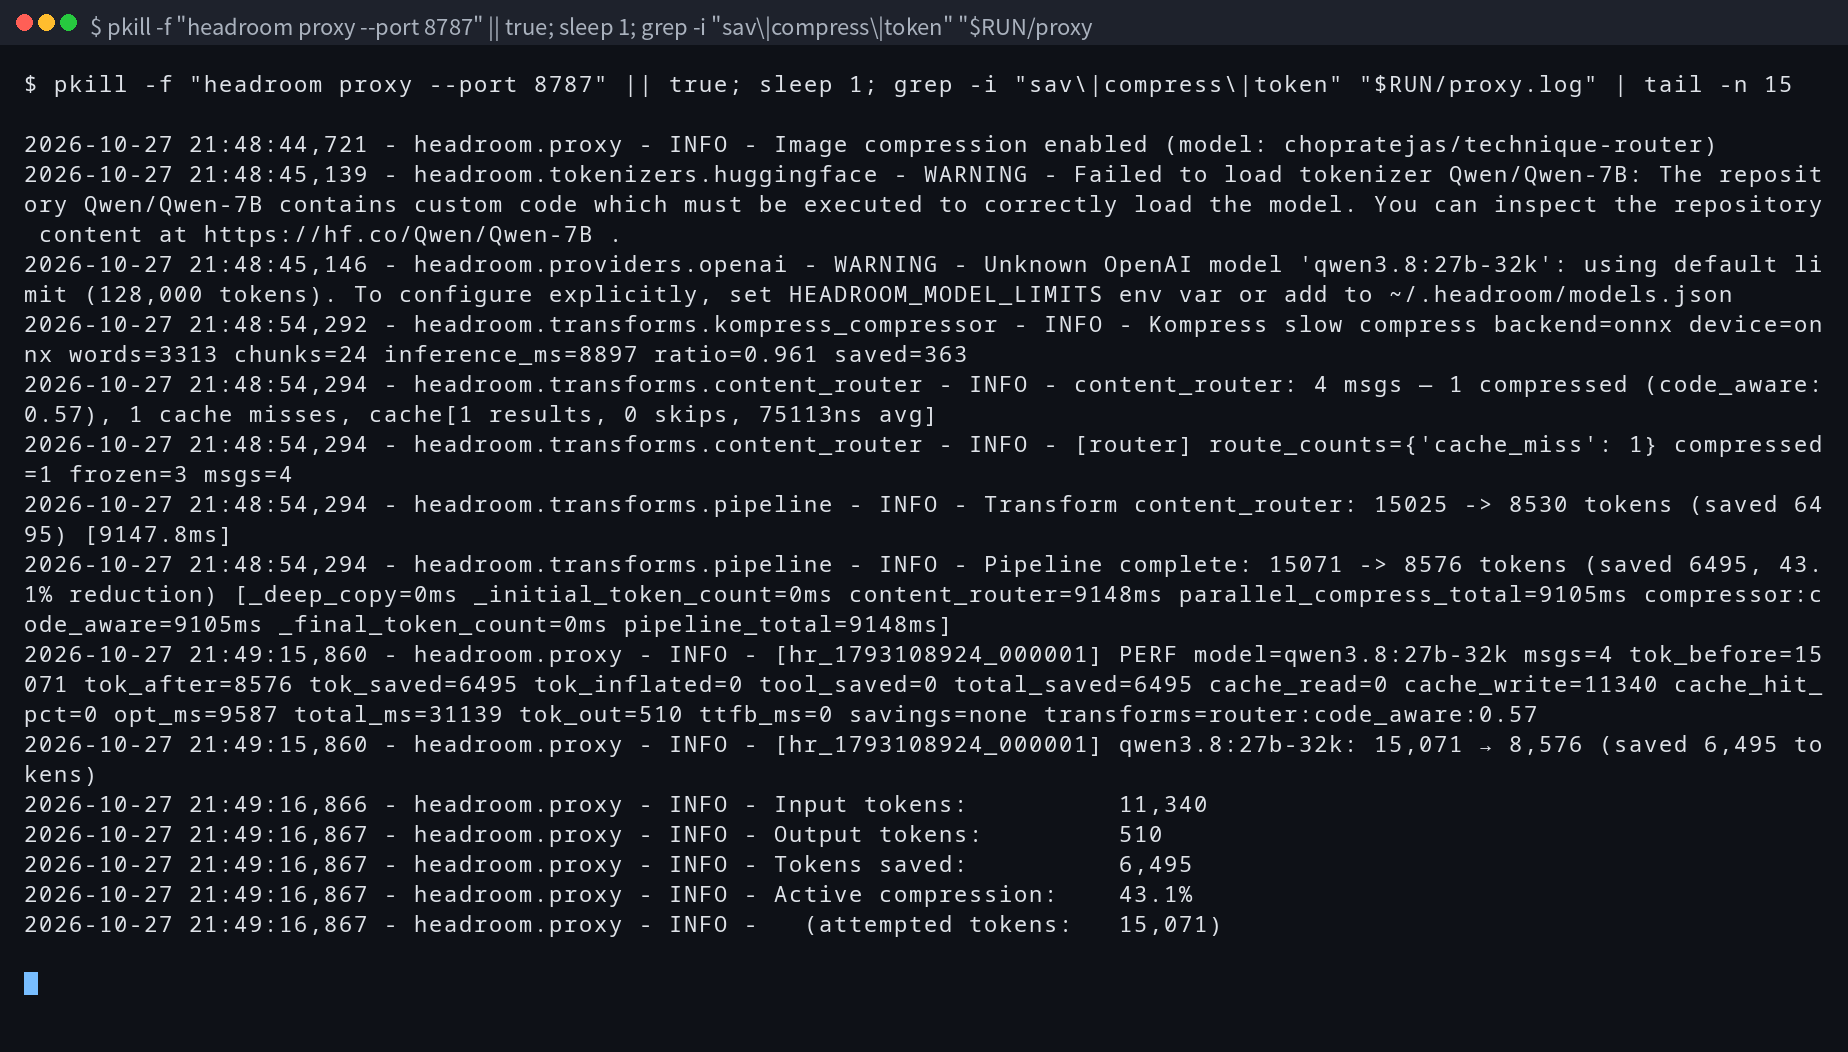
| 停止代理並檢視日誌 | pkill -f "headroom proxy ..."; grep ... proxy.log | 結束碼 0,1.0 秒。日誌確認壓縮率 43.1%,節省 6,495 tokens。 |
結果驗證
在實際測試中,Headroom 展現了顯著的壓縮能力。面對我們產生的 6 萬字元程式碼 grep 結果,直連 Ollama 時模型收到 18,050 個輸入 token;而經過 Headroom 代理後,輸入 token 降至 11,340 個。根據代理日誌顯示,實際進入壓縮管線的 token 從 15,071 降至 8,576,壓縮率達 43.1%,節省了 6,495 個 token。以模型自己回報的數字看,輸入少了 37%;這與 README 中聲稱的「程式碼代理節省 20%、JSON 節省 60-95%」的大致範圍相符。專案自帶的基準測試在本機也跑出和 README 相同的 41%,但那用的是專案自己準備的語料,本站把它當作安裝正確的驗證,不當作實測數據。
然而,壓縮並非毫無代價。日誌顯示壓縮過程耗時約 9,148 毫秒(inference_ms=8897),這使得整體請求延遲從直連的 28.3 秒增加到 31.2 秒:在一張 RTX A6000 上,27B 模型少處理 6,700 個 token 省下的時間,不夠抵掉壓縮本身的 9 秒。代理日誌顯示這次請求的壓縮主要由程式碼感知的路由完成(15,025 → 8,530),Kompress 文字壓縮只省了 363 個 token。另外要說明:兩次回覆都是空的,因為 Qwen3.8 的思考模式把 400 個輸出 token 的額度用在推理上,本站這次沒有驗證壓縮後的答案是否仍然正確,這是這篇實測的限制。
遇到的問題
1. 步驟 5 與步驟 9 執行 headroom doctor 時結束碼為 1,但輸出顯示「0 failure(s)」,僅有警告。原因未確認,可能是 CLI 將警告視為非零結束碼,但不影響代理實際運行。
2. 代理預設上游是 OpenAI 官方網址,不看 OPENAI_BASE_URL;第一次測試因此拿到 401,改用 --openai-api-url 指到本機 Ollama 才通。
3. 啟動時 kompress 文字壓縮模型還沒載入(健康檢查顯示 degraded),約 20 秒後才 ready;正式使用前要先預熱。
4. 壓縮本身耗時約 9.1 秒(ONNX 後端),在本機模型上省下的提示詞處理時間抵不過這段延遲;上游是雲端 API、按 token 計費時才划算。
5. 回答品質沒有比到:模型的思考模式吃掉輸出額度,兩次回覆都是空的。下次要關閉思考或放大輸出額度。
結論
Headroom 適合把 Agent 接在雲端、按 token 計費的 API 上的團隊:本站的語料經它一過,模型收到的輸入少了 37%,而且不用改程式碼,只改端點。接在本機模型上就不一定划算,這次省下的處理時間抵不過壓縮本身的 9 秒。它壓縮後的答案是否仍然正確,本站這次沒有驗證,要採用的人應該用自己的任務比一次。
來源:佐證 0 筆,另有背景參考 1 筆
背景參考正文沒有引用,只是相關背景,不計入佐證數
這篇對你有用嗎?
登入會員後可以按反應與留言。登入
留言 0
- 還沒有留言。
留言公開顯示暱稱,不顯示你的真實姓名與信箱。含多個連結或疑似廣告的留言會先經編輯確認;檢舉達 3 次的留言會自動隱藏。隱私政策
發現錯誤?
回報會進入待處理清單;核實後更正,並在文中註記更正紀錄。