LFM3-1.7B 實測:生成速度是 Qwen3.5-4B 的 2.3 倍,繁體中文知識明顯落後
在 RTX A6000 上生成 359.84 tok/s、純 CPU 29.35 tok/s,約為同樣 4-bit 的 Qwen3.5-4B 兩到三倍;工具呼叫 8/10、指令遵循 8/10,但繁體中文知識題只對 4/6,還曾憑空呼叫工具。
本文重點
- LFM3-1.7B 在 RTX A6000 上生成速度達 359.84 tok/s。
- 工具呼叫與指令遵循各得 8/10,繁體中文知識題僅對 4/6。
- 繁體中文知識準確度落後,不建議用於需精確事實的場景。
- 本站上線
- 2026/10/28 上午11:33
LiquidAI/LFM3-1.7B 是 Hugging Face 上的開源模型,發布兩天內 161 個讚、6,311 次下載。我們在一台 RTX A6000 48 GB 工作站 上,從下載、架起推論服務到跑完測試整段錄下終端機;測的是 2026-10-27 發布的 Q4_K_M GGUF 的版本。實測影片公開後會嵌在本文最下方。
背景
LFM3-1.7B 是 Liquid AI 推出的輕量級語言模型,主打本地端代理(Local Agents)與邊緣運算應用。其採用三混合架構(tri-hybrid architecture),結合門控短卷積、滑動視窗注意力與全域注意力,旨在以極小的參數量(1.73B)提供高達 256K 的上下文視窗,並針對 Hermes Agent 等代理框架進行後訓練,適合需要快速反應且記憶體受限的場景。
與傳統 Transformer 模型不同,LFM3 強調在 4-bit 量化下僅需約 1 GB 記憶體即可運行,這使得它能夠部署在手機或筆記型電腦上。專案方指出該模型專為工具呼叫、結構化輸出與領域微調設計,但不建議用於複雜的多步驟推理或程式碼生成,這使其定位於特定任務的輔助代理而非通用聊天機器人。
運作方式與使用方式
我們使用 llama.cpp 框架來運行 LFM3-1.7B 的 Q4_K_M GGUF 版本。首先透過 huggingface_hub 下載模型檔案,接著編譯支援 CUDA 的 llama.cpp 以啟用 GPU 加速。啟動服務時,使用 llama-server 指令載入模型,設定 --jinja 以支援聊天模板,--ngl 99 將所有層載入 GPU,並指定 --port 8181 開啟本地 API 服務。
測試流程包含速度基準測試與功能評估。速度部分使用 llama-bench 分別在 GPU 與純 CPU 模式下測量預填充(pp)與生成(tg)速度。功能評估則透過自訂腳本發送四組測試:工具呼叫、指令遵循、繁體中文知識問答以及長文件找針(Needle in a Haystack)。所有請求均透過 HTTP POST 發送至本地端點,並記錄回應時間與正確性。
與未使用時的差異
| 情境 | 不用它(傳統大模型或雲端 API) | 用它(LFM3-1.7B 本地端) |
|---|---|---|
| 記憶體佔用 | 對照組 Qwen3.5-4B 同為 4-bit 時 2.54 GiB | 1.02 GiB,沒有獨立顯卡的機器也跑得動 |
| 生成速度 | Qwen3.5-4B:GPU 156.41 tok/s、純 CPU 10.77 tok/s | GPU 359.84 tok/s、純 CPU 29.35 tok/s |
| 工具呼叫與指令遵循 | Qwen3.5-4B:10/10、7/10 | 8/10、8/10 |
| 繁體中文知識 | Qwen3.5-4B:6/6 | 4/6,有事實錯誤(把台灣最高峰答成「金山」) |
安裝與執行過程
| 步驟 | 指令 | 結果 |
|---|---|---|
| 環境檢查 | uname -a; python3 --version; nvidia-smi ... | 結束碼 0;確認環境為 Ubuntu 24.04, Python 3.12.3, NVIDIA RTX A6000 (49140 MiB) |
| 下載模型 | hf download LiquidAI/LFM3-1.7B-GGUF LFM3-1.7B-Q4_K_M.gguf ... | 結束碼 0;下載 LFM3-1.7B-Q4_K_M.gguf (1099627808 bytes) 與 Qwen3.5-4B-Q4_K_M.gguf 作為對照組 |
| 編譯 llama.cpp | cmake -B build -DGGML_CUDA=ON ... && cmake --build build ... | 結束碼 0;耗時 457.8 秒;成功建置 llama-server 與 llama-bench |
| LFM3 GPU 速度測試 | llama-bench -m LFM3-1.7B-Q4_K_M.gguf -p 512 -n 128 -ngl 99 | 結束碼 0;預填充 15698.55 tok/s,生成 359.84 tok/s |
| LFM3 CPU 速度測試 | llama-bench -m LFM3-1.7B-Q4_K_M.gguf -p 512 -n 128 -ngl 0 -t 8 | 結束碼 0;預填充 203.91 tok/s,生成 29.35 tok/s |
| 啟動 LFM3 服務 | llama-server -m LFM3-1.7B-Q4_K_M.gguf --jinja -ngl 99 -c 65536 --port 8181 ... | 結束碼 0;服務啟動成功,健康檢查回傳 {"status":"ok"} |
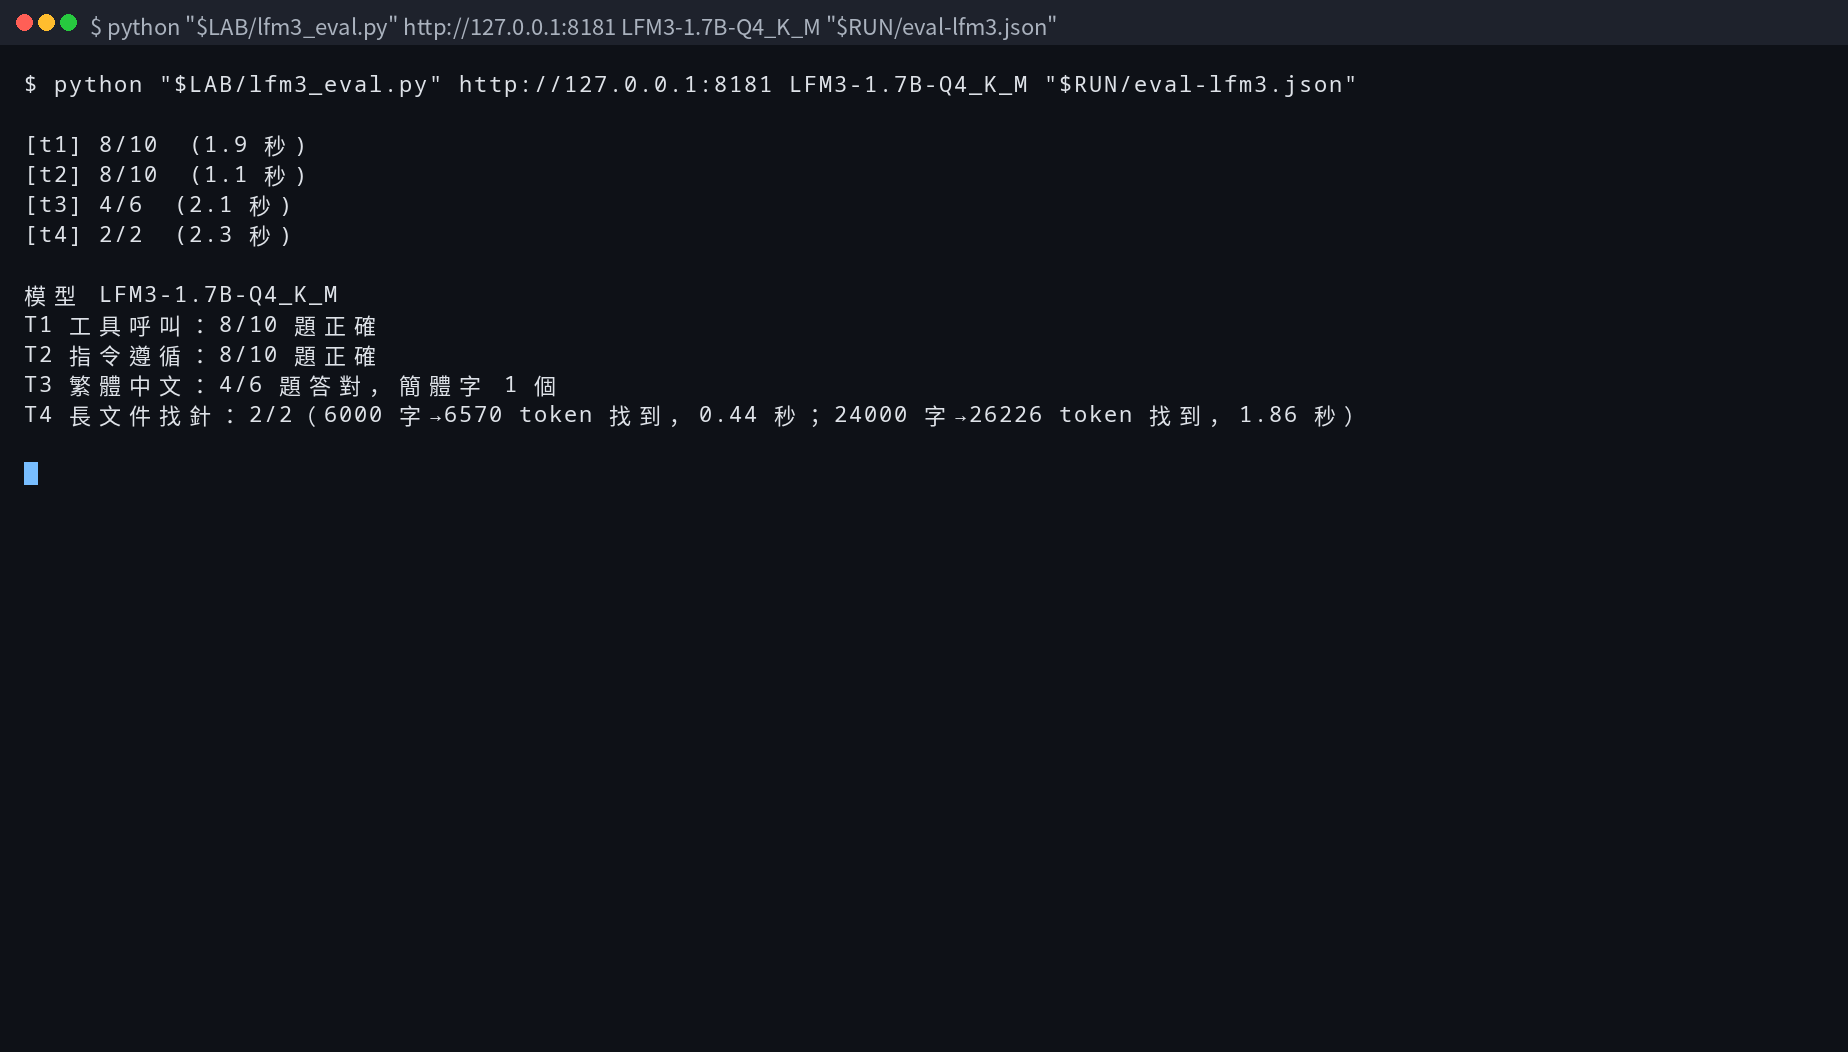
| LFM3 能力評估 | python lfm3_eval.py http://127.0.0.1:8181 LFM3-1.7B-Q4_K_M ... | 結束碼 0;工具呼叫 8/10,指令遵循 8/10,繁體中文 4/6,長文件找針 2/2 |
| Qwen3.5-4B 對照測試 | llama-bench -m Qwen3.5-4B-Q4_K_M.gguf ... && python lfm3_eval.py ... | 結束碼 0;GPU 生成 156.41 tok/s;工具呼叫 10/10,繁體中文 6/6 |
結果驗證
在速度方面,LFM3-1.7B 展現了驚人的效率。在 NVIDIA RTX A6000 上,其生成速度達到 359.84 tok/s,遠高於對照組 Qwen3.5-4B 的 156.41 tok/s。即使在純 CPU 模式(Intel i7-9700)下,LFM3 仍維持 29.35 tok/s 的生成速度,而 Qwen3.5-4B 則降至 10.77 tok/s。這證實了 README 中關於其輕量高效、適合邊緣運算的說法。
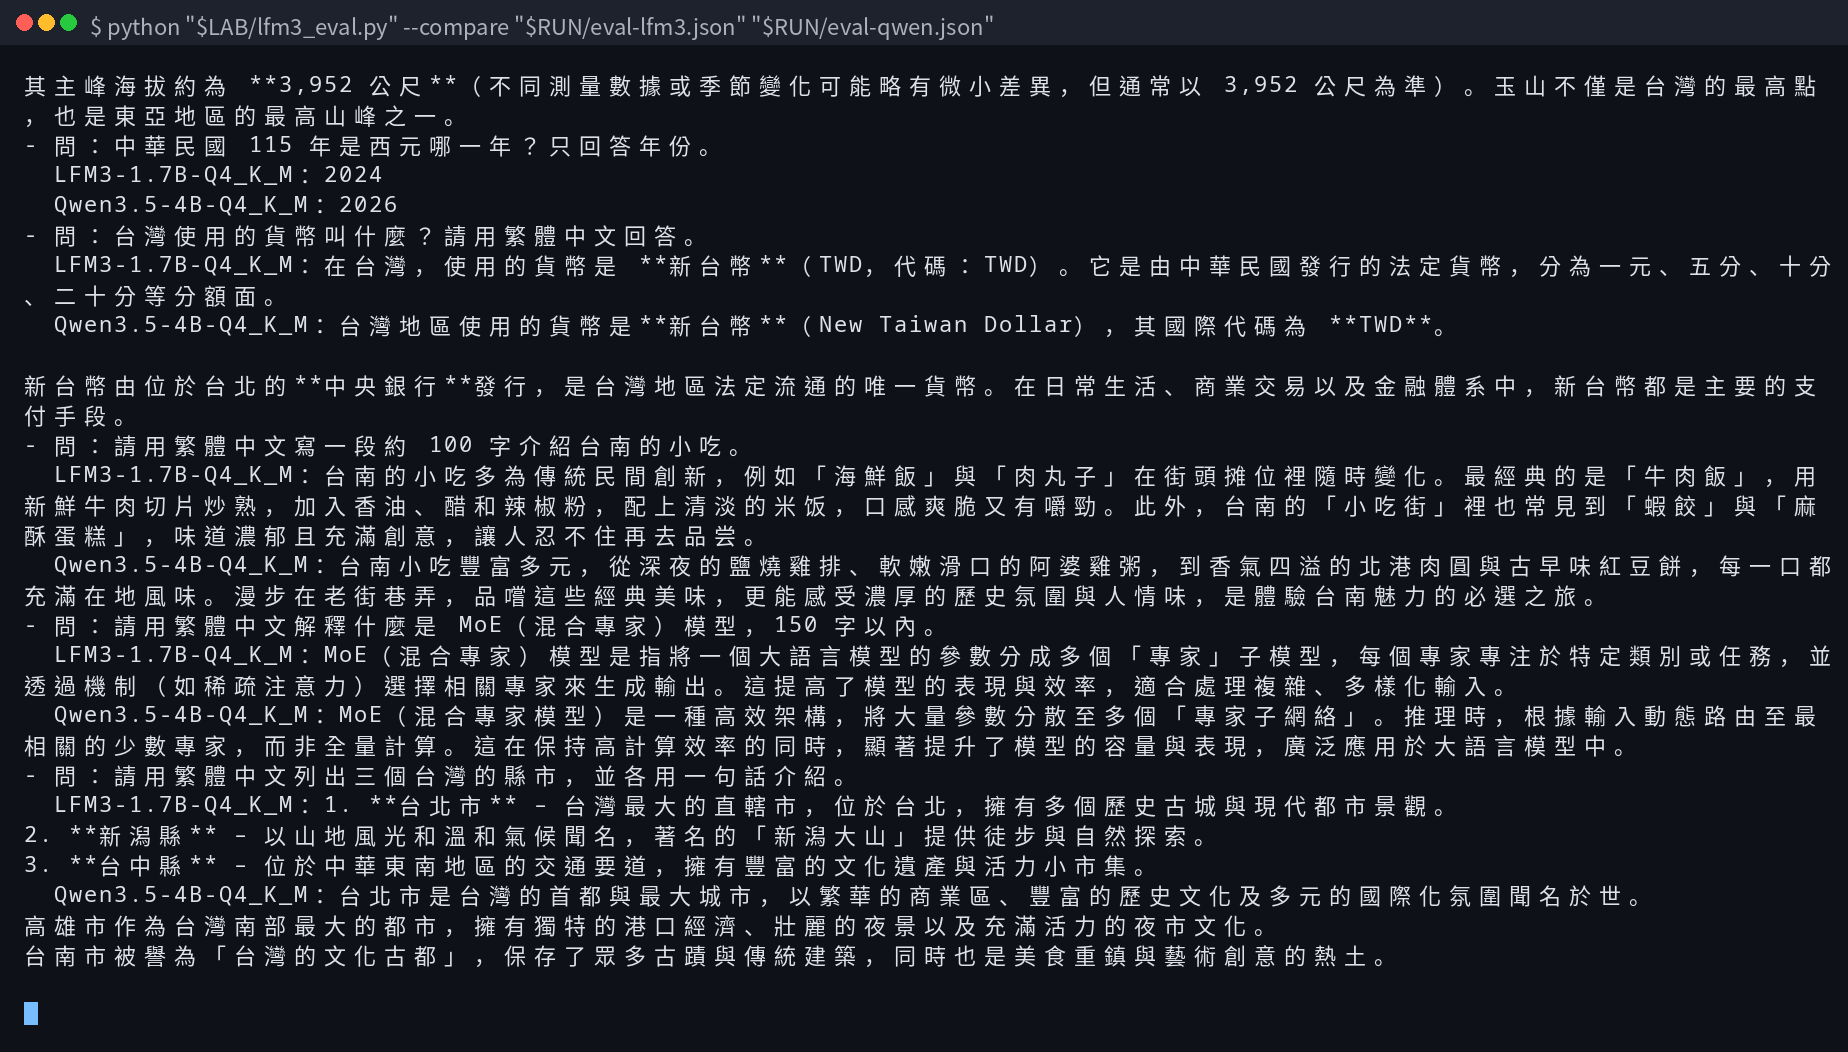
在功能測試中,LFM3 在工具呼叫(8/10)與指令遵循(8/10)方面表現尚可,但在繁體中文知識準確度上明顯落後於較大的 Qwen3.5-4B(6/6)。工具呼叫錯的兩題值得一提:問它「請用一句話介紹你自己」時,它憑空呼叫了查天氣的工具,城市還填成「北京」;請它查「2026 年台北國際電腦展的日期」時,函式選對了,但送出的搜尋關鍵字被改寫成簡體字「台北国际电脑展」。對照組 Qwen3.5-4B 十題全對,不過在指令遵循上反而只有 7/10,像「全部大寫的英文句子」與「恰好五個英文單字」這類格式限制它沒有做到。例如,LFM3 錯誤地回答台灣最高山為「金山」且高度僅 1,983 公尺(實際為玉山 3,952 公尺),並將中華民國 115 年誤算為 2024 年(實際為 2026 年)。這顯示小參數模型在特定語言知識上可能存在幻覺或訓練資料不足的問題。
長文件找針測試中,LFM3 在 24,000 字(約 26,226 token)的上下文中成功找到目標,耗時 1.86 秒,符合其 256K 上下文視窗的設計能力。然而,在繁體中文回答中,LFM3 偶爾會混用簡體字(測試中出現 1 個簡體字),且回答風格較為機械化,不如 Qwen3.5-4B 自然流暢。
遇到的問題
1. 第一輪錄製時編譯 llama.cpp 失敗:我們的腳本用短版 commit 編號做 git fetch,遠端找不到;改成完整的 40 字元編號後重錄即正常。這是本站腳本的問題,與模型無關。
2. llama.cpp 要自己從原始碼編:專案這一版的 GitHub release 沒有附 Linux 執行檔,在這台工作站上用 CUDA 12.0 編 llama-server 與 llama-bench 花了約 458 秒。
3. Ollama 這一版(v0.40.12)的 LFM3 支援只有 Apple 硬體,Linux 要等後續版本,所以本次用 llama.cpp 的 GGUF 檔測試。
結論
LFM3-1.7B 適合需要極低延遲、低記憶體佔用且主要處理英文或結構化任務的本地端代理應用。對於繁體中文知識要求較高或需要精確事實回答的場景,建議選擇參數更大的模型或進行領域微調。其速度優勢明顯,但知識準確度是主要短板。另外要提醒:四組測試都是本站自訂的小題組(10/10/6/2 題),只能看趨勢,不等於模型卡上的 IFEval、BFCL 分數。
來源:佐證 0 筆,另有背景參考 1 筆
背景參考正文沒有引用,只是相關背景,不計入佐證數
- huggingface.co · LiquidAI/LFM3-1.7B(Hugging Face)
這篇對你有用嗎?
登入會員後可以按反應與留言。登入
留言 0
- 還沒有留言。
留言公開顯示暱稱,不顯示你的真實姓名與信箱。含多個連結或疑似廣告的留言會先經編輯確認;檢舉達 3 次的留言會自動隱藏。隱私政策
發現錯誤?
回報會進入待處理清單;核實後更正,並在文中註記更正紀錄。