定義題目即決定結果:本站重現皮膚癌 200 例實測說明準確率靠資料量而非架構
十年前的 CNN 用 68,011 張標好的影像拿到 62%,地端最好的視覺語言模型只有 34%;範例圖、告知分布、先列特徵五種提示沒一種加到 10 分,多花的 token 只讓錯誤換位置。
本文重點
- 效果取決於資料量而非架構:Inception v3 靠 68,011 張標好的影像得 62%,2026 年的視覺語言模型最好只有 34%。
- 選對工具才有效率與正確率:CNN 毫秒級、手機能跑;視覺語言模型每例 4 到 22 秒、要 48 GB 顯示卡,還比較不準。
- 把資料倒進最強模型期待它變準只是浪費 token:五種提示沒一種加到 10 分,看似進步的那組是多猜常見類別,黑色素瘤反而漏更多。
- 本站上線
- 2026/10/29 下午08:55
「A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis」是 Magnus Lynch(英國 Guy's Hospital 皮膚科顧問醫師、King's College London 榮譽讀者)於 2026-10-25 發表的公開測試(https://lynchlab.net/llm-skin-cancer),資料、提示詞與模型回覆都公開。本站在一台 RTX A6000 48 GB 工作站上,用同一批 200 例、同一段提示詞測六個能在地端跑的開源視覺模型,再對其中最好的兩個試五種提示方法,整段錄下終端機;雲端模型的分數由作者公開的回覆重新評分,CNN 的分數引用作者公布的數字,本站沒有重跑。這篇不只是重現,要回答兩個問題:十年前的 CNN 為什麼會贏,以及 CNN 和視覺語言模型在使用上到底差在哪。實測影片公開後會嵌在本文最下方。
這個實驗在測什麼
作者從 MILK10k(ISIC 2025 年公開的資料集)隨機抽 200 例,全部有病理確診,分六類:黑色素瘤 30、基底細胞癌 25、鱗狀細胞癌 25、光化性角化 20(這 100 例不該出院),痣 50、脂漏性角化 50(這 100 例可出院)。每例給臨床照片與皮膚鏡影像各一張,模型要在六類裡選一個第一診斷、一個第二選項,並決定能不能出院。
作者的結果(第一診斷正確/200 例):GPT-6 Astra 84(42%)、Claude Fable 5.1 85(42%)、2015 年的 Inception v3 CNN 125(62%)。CNN 先用一般照片預訓練,再以 ISIC Archive 的 68,011 張皮膚鏡與臨床影像全層微調,單張 H100 約 20 分鐘,測試病例與同病人的影像全部排除在訓練外。
看這些數字前要先記住兩件事:六類比例失衡,痣與脂漏性角化合計占一半,所以「全部猜痣」也能拿 25%,單看正確率要小心;黑色素瘤只有 30 例,任何一列的黑色素瘤數字不確定區間都很寬。
本站的做法
- 地端模型六個,全部在 Ollama 上跑 Q4_K_M 量化:Gemma 4 31B、MedGemma 27B(Google 的醫療模型)、MedGemma 4B、Qwen3-VL 32B、Qwen3-VL 8B、Mistral Small 3.2 24B。
- 提示詞用作者的原文,temperature 0,關閉思考,每題只跑一次;和作者「預設設定、跑一次」的做法對齊,但不完全相同。
- 評分程式同一套:雲端兩個模型的分數是用作者公開的原始回覆重算,得到與作者相同的 84 與 85,確認評分方式一致。
- 第二輪只對 Gemma 4 31B 與 MedGemma 27B 做,不訓練、只改給模型的東西,五個條件各跑一遍 200 例:告知六類的比例;先要模型列出皮膚鏡特徵再下判斷;只給皮膚鏡影像、不給臨床照片;每類給 2 張標好答案的範例圖(從同一批 200 例固定抽、每題排除自己);前三者疊加。另外把三個最好的基線答案做多數決。
一、CNN 為什麼會贏
它看過答案,而且看了很多。 CNN 在 68,011 張標好類別的影像上微調過,六類各看過上千例。視覺語言模型在預訓練裡零星看過皮膚鏡圖,但多半沒有標答案;MedGemma 雖然加了醫療資料,仍然不是針對這六類、這種影像做的。這是專科醫師對通識生的差距,跟架構新舊無關。
它直接在像素上學紋理。 分辨黑色素瘤與痣靠的是色素網、不規則條紋、藍白幕這類細微結構。CNN 的卷積直接在像素上找這些紋理;視覺語言模型先用一個為「看圖說話」訓練的視覺編碼器把圖壓成幾百個 token(Gemma 4 一張圖約 140 個 token),再交給語言模型。壓縮時留下的是「一塊棕色、邊緣不規則」這種語意,細微紋理多半丟了。測試影像只有 600×450,而 CNN 本來就縮到 299×299 用,所以解析度不是 LLM 輸的理由。
它的輸出是校準過的機率。 CNN 給六個加總為一的機率,門檻可以依臨床需求調:寧可多留病人就把出院門檻拉高。視覺語言模型給的是一段文字加一個自稱的信心分數,沒有統計意義:第一輪 Mistral Small 把 200 例裡的 123 例判成基底細胞癌,信心照樣高。
題目是 CNN 的主場。 封閉六選一、不需要病史、不需要推理、測試資料和訓練資料同源,這正是分類器被設計來做的事。LLM 的強項是整合不同形式的資訊,這題一點也用不上。
二、LLM 與 CNN 在使用上的差異
| 面向 | 專用 CNN | 視覺語言模型(LLM) |
|---|---|---|
| 輸入 | 固定尺寸影像 | 影像加任意文字(病史、問法、範例) |
| 輸出 | 固定格式的六個機率 | 自由文字,要自己解析;第一輪 Qwen3-VL 8B 有 130 例格式壞掉 |
| 可信度 | 校準過的機率,可設門檻 | 自報信心,與對錯無關 |
| 速度與成本 | 毫秒級,手機能跑 | 每例 4 到 22 秒,要一張 48 GB 顯示卡 |
| 換任務 | 要重新訓練 | 改提示詞就行 |
| 失敗方式 | 換相機、換光源會悄悄失準 | 偏向某一類、思考打轉、格式錯 |
| 可解釋 | 熱圖指出看哪裡 | 一段理由,可能是事後編的 |
| 監管 | 模型固定、容易驗證 | 版本一換行為就變 |
一句話:CNN 是量具,LLM 是助理。量具要準、要穩、要能校正;助理要能聽懂話、整合資訊、說明理由。這題只需要量具。
三、用實驗數字回頭檢驗
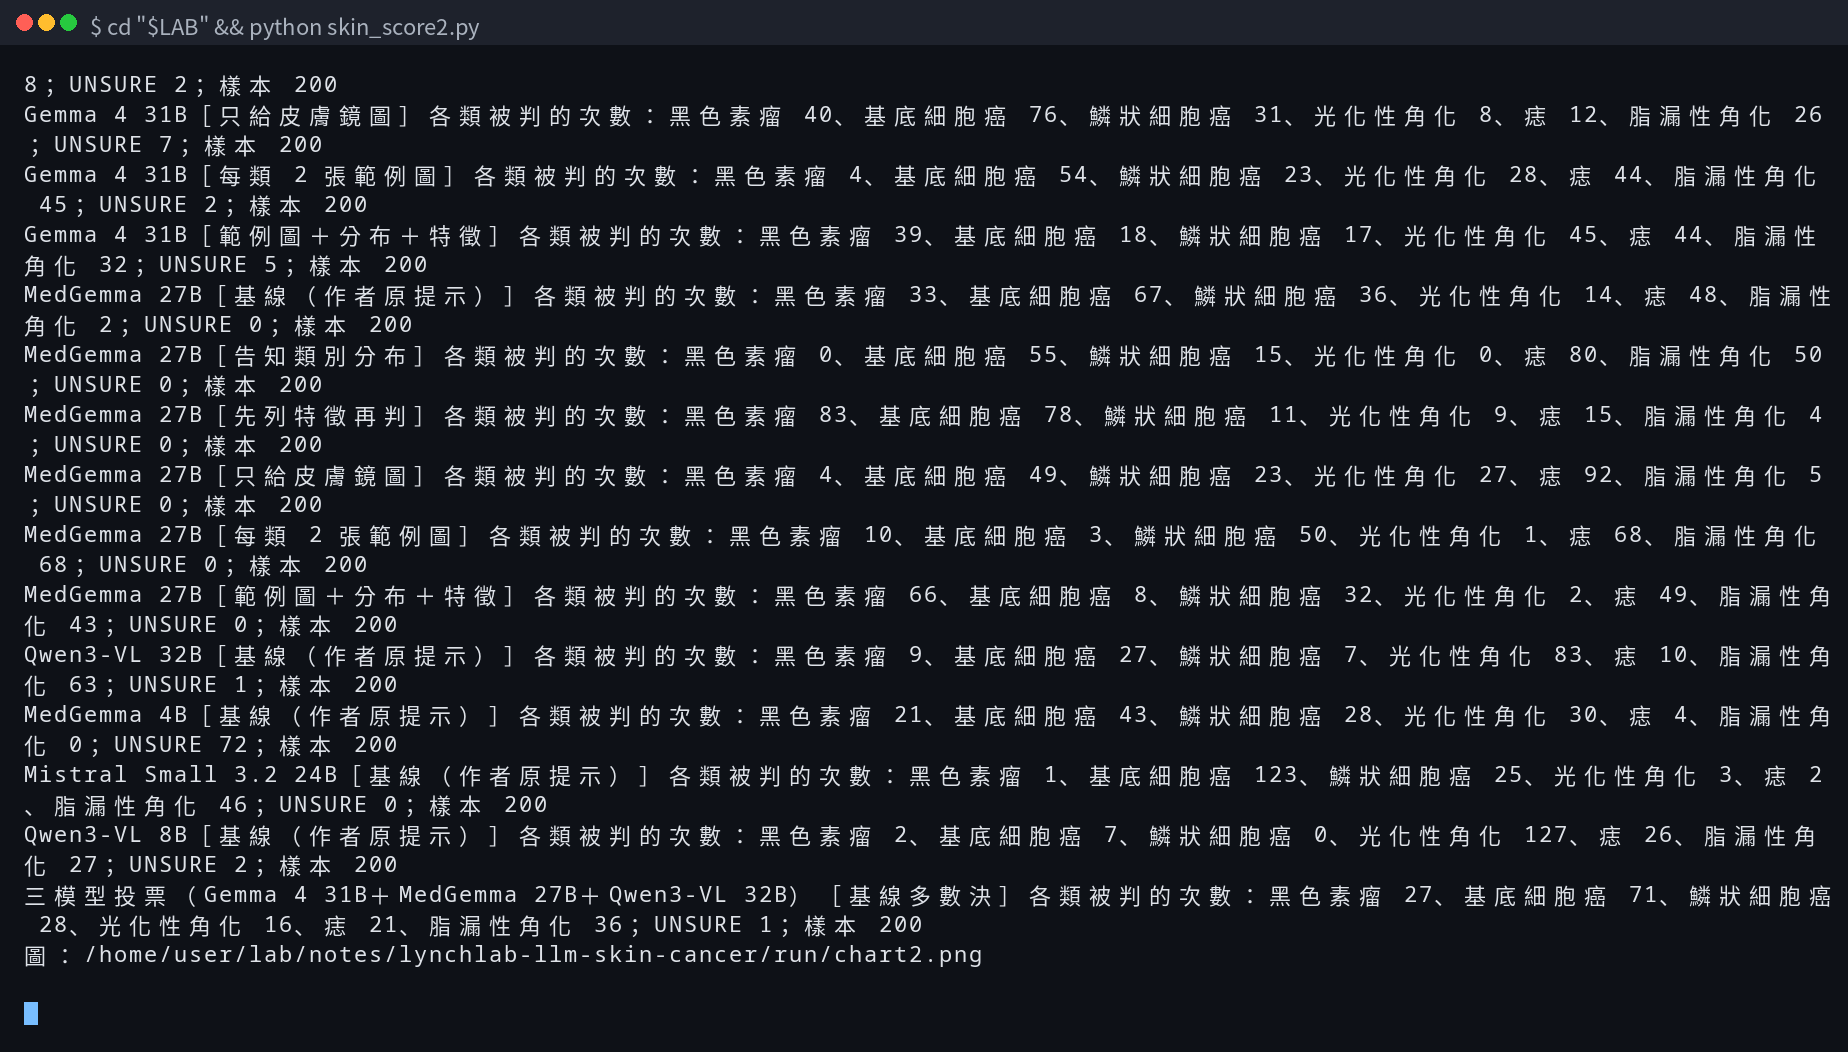
第一輪,六個地端模型用作者原提示的基線(第一診斷正確/200 例):
| 模型 | 第一診斷正確 | 前兩選項內 | 黑色素瘤抓到(30) | 不該出院的留下(100) | 可出院的放走(100) |
|---|---|---|---|---|---|
| Gemma 4 31B | 67(34%) | 112 | 11 | 91 | 38 |
| MedGemma 27B | 59(30%) | 110 | 13 | 91 | 41 |
| Qwen3-VL 32B | 54(27%) | 108 | 4 | 81 | 54 |
| Qwen3-VL 8B | 48(24%) | 85 | 1 | 90 | 42 |
| Mistral Small 3.2 24B | 40(20%) | 67 | 0 | 89 | 35 |
| MedGemma 4B | 20(10%) | 49 | 5 | 98 | 7 |
| 三模型投票(前三者多數決) | 70(35%) | 11 | 90 | 46 | |
| GPT-6 Astra(作者公開回覆) | 84(42%) | 134 | 8 | 97 | 32 |
| Claude Fable 5.1(作者公開回覆) | 85(42%) | 138 | 11 | 96 | 22 |
| Inception v3 CNN(作者公布,本站未重跑) | 125(62%) | 173 | 13 | 77 | 76 |
地端最好的 Gemma 4 31B 離雲端旗艦差 8 個百分點,離 CNN 差 28 個百分點。MedGemma 4B 有 72 例回答 UNSURE,幾乎不能用。三個模型投票只比單一最好多 3 例。
第二輪,五個條件對兩個模型各跑 200 例:
| 條件 | Gemma 4 31B 正確 | 黑色素瘤抓到 | 不該出院的留下 | MedGemma 27B 正確 | 黑色素瘤抓到 | 不該出院的留下 |
|---|---|---|---|---|---|---|
| 基線(作者原提示) | 67(34%) | 11 | 91 | 59(30%) | 13 | 91 |
| 告知類別分布 | 58(29%) | 5 | 77 | 66(33%) | 0 | 42 |
| 先列皮膚鏡特徵再判 | 67(34%) | 16 | 96 | 46(23%) | 22 | 96 |
| 只給皮膚鏡圖 | 60(30%) | 14 | 96 | 58(29%) | 1 | 68 |
| 每類 2 張範例圖 | 65(32%) | 2 | 78 | 76(38%) | 1 | 47 |
| 範例圖+分布+特徵疊加 | 68(34%) | 13 | 84 | 62(31%) | 12 | 62 |
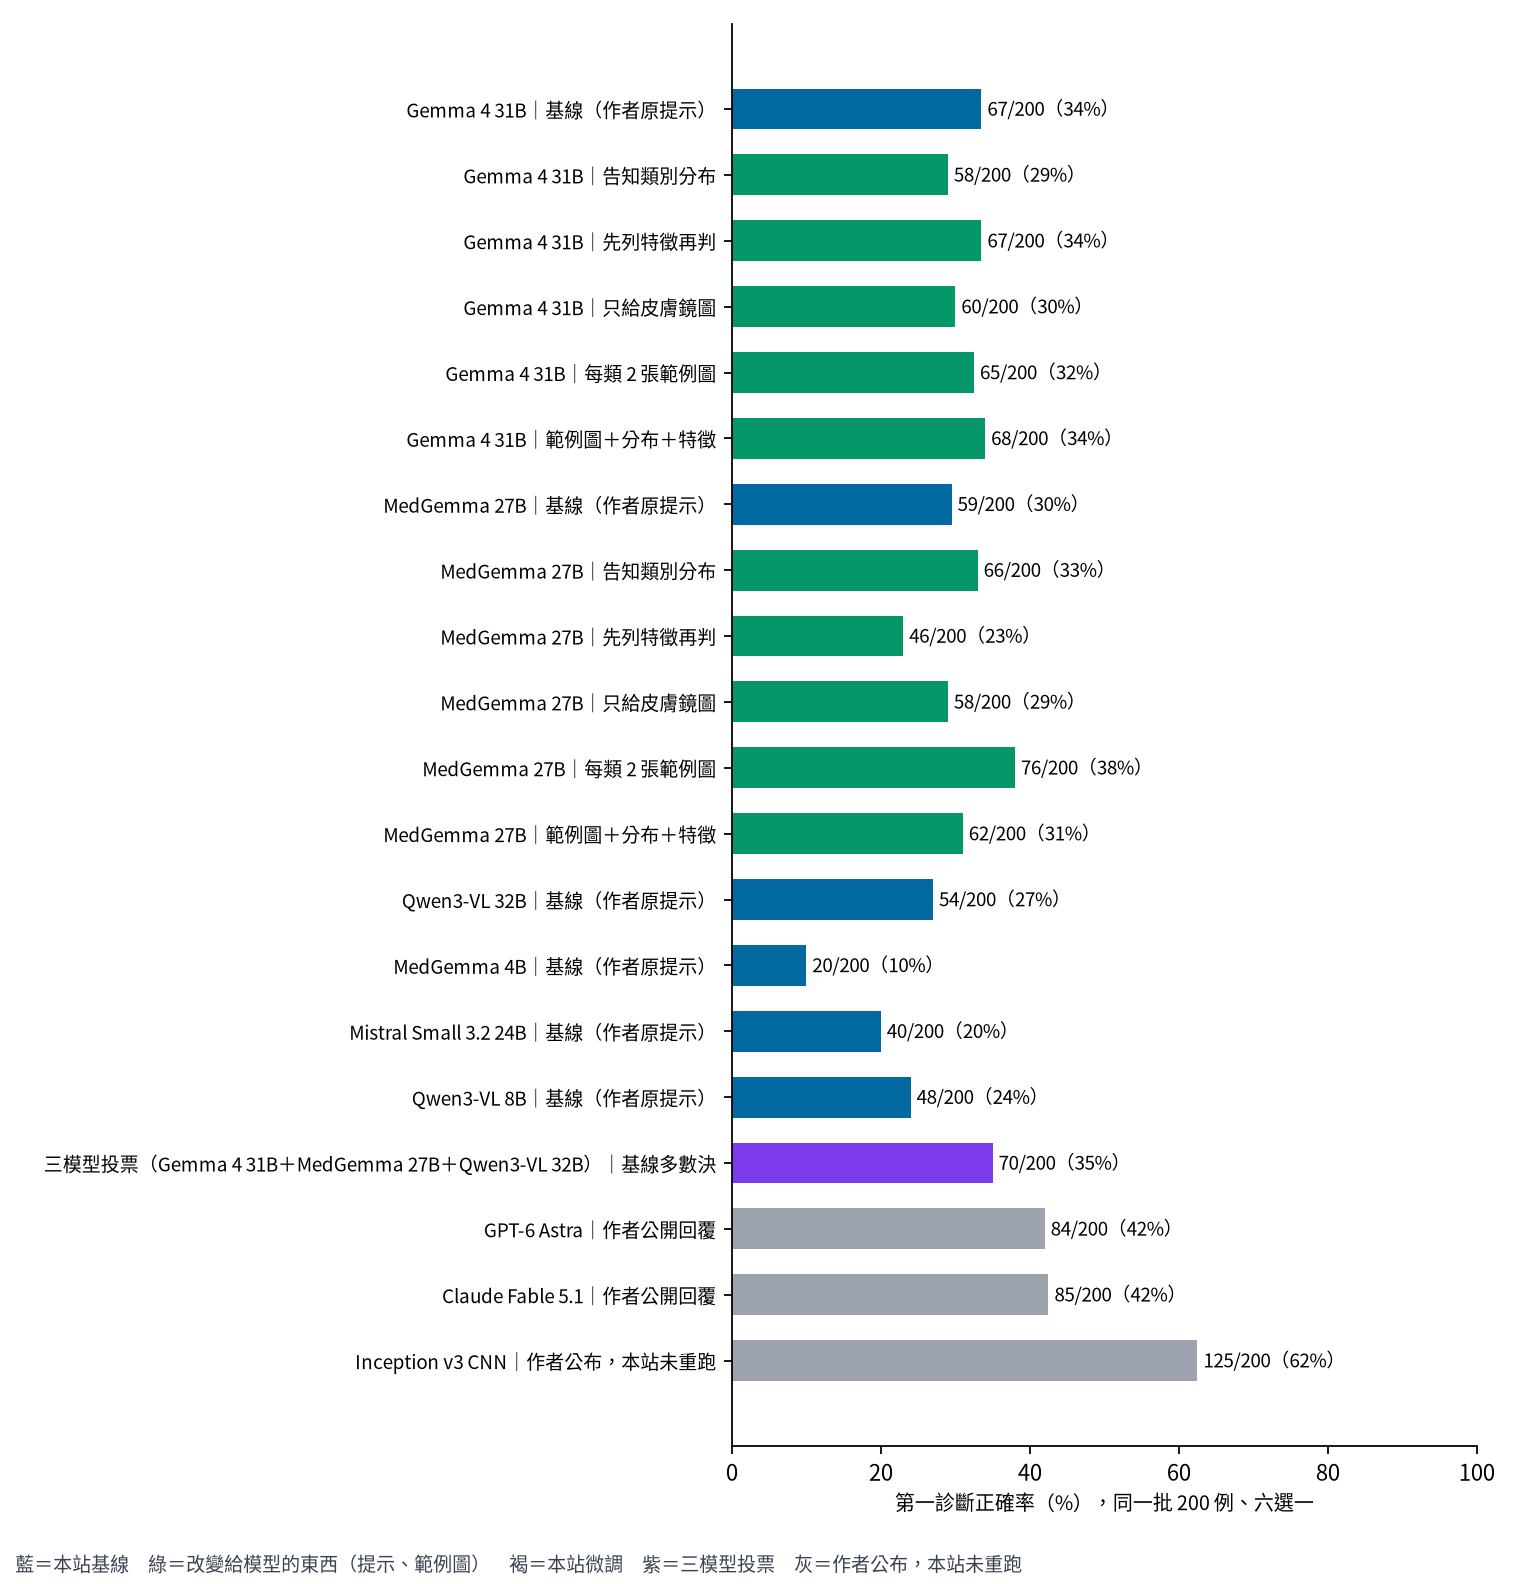
實驗前就講好的判讀規則有三種:若範例圖加分最多,表示 LLM 缺的是那幾萬張圖、不是腦袋;若只給皮膚鏡圖那組加分最多,表示瓶頸在視覺編碼器;若全部加不到 10 分,表示這類題該用 CNN。結果落在第三種,沒有任何一個條件加到 10 分,兩個模型的十組結果全部落在 23% 到 38% 之間。
幾個條件值得單獨看:
- 範例圖看起來讓 MedGemma 27B 升到 38%,其實是在賭類別。 它判「痣」的次數從 48 次變成 68 次、「脂漏性角化」變成 50 次,剛好是占一半的兩個大類;同時黑色素瘤 30 例只抓到 1 例,不該出院的 100 例只留下 47 例。正確率是靠猜多數類換來的,臨床上更危險。Gemma 4 31B 加範例圖也一樣:判痣次數從 16 次變成 44 次,黑色素瘤從 11 例掉到 2 例。兩張範例圖不足以教會模型辨認紋理,只告訴它「這類很常見」。
- 告知類別分布也是同一回事。 MedGemma 27B 得知痣和脂漏性角化各占四分之一後,80 例判成痣,黑色素瘤一例都沒抓到。這驗證了第一節說的「輸出沒有校準」:它不是把先驗乘進機率,而是把先驗當成答案。
- 先列特徵再判是唯一讓黑色素瘤抓得更多的做法(Gemma 4 從 11 例到 16 例、MedGemma 從 13 例到 22 例),但總正確率持平或下降,因為它同時把很多良性病灶也判成黑色素瘤(MedGemma 判黑色素瘤的次數從 33 次變成 83 次)。提示詞搬動了錯誤的位置,沒有減少錯誤的總量。
- 只給皮膚鏡圖沒有變好。 兩個模型都略降。如果瓶頸是臨床照片干擾判斷,拿掉它應該會進步;沒有,表示瓶頸在模型看皮膚鏡圖的能力本身。
- 疊加沒有相加的效果。 兩個模型疊加後都回到基線附近,三個條件互相抵消。
回到第一節的四個理由,實驗數字支持的是前三個:缺標好答案的資料(兩張範例圖補不了 68,011 張)、視覺編碼器壓掉了紋理(只給皮膚鏡圖沒變好)、輸出沒有校準(告知分布變成直接猜多數類)。沒有任何證據說這是「提示詞沒寫好」。
安裝與執行過程
| 步驟 | 指令 | 結果 | ||||
|---|---|---|---|---|---|---|
| 確認測試資料完整性 | `cd "$LAB" && test -f run/PREP_DONE && cat run/PREP_DONE && ls -l data && wc -l data/cases.csv && ls images \ | wc -l && du -sh images && head -c 600 data/prompts.txt` | 結束碼 0;資料包含 201 行 CSV 與 401 張圖片,總大小 15M,確認 200 例測試集就緒。 | |||
| 安裝 Python 依賴套件 | uv pip install -q matplotlib && python -c "import matplotlib; print('matplotlib', matplotlib.__version__)" | 結束碼 0;成功安裝 matplotlib 3.11.2。 | ||||
| 確認 Ollama 本地模型清單 | `OLLAMA_HOST=127.0.0.1:11435 ollama list \ | grep -E "medgemma\ | qwen3-vl\ | gemma4\ | mistral-small3.2" && curl -s 127.0.0.1:11435/api/version` | 結束碼 0;確認 MedGemma 4B/27B、Qwen3-VL 8B/32B、Gemma 4 31B、Mistral Small 3.2 24B 已載入,Ollama 版本 0.32.13。 |
| MedGemma 27B 基線測試 | cd "$LAB" && python skin_classify.py medgemma:27b --host 127.0.0.1:11435 | 結束碼 0;耗時 1124.0 秒;第一診斷正確 59/200(30%)。 | ||||
| Qwen3-VL 32B 基線測試 | cd "$LAB" && python skin_classify.py qwen3-vl:32b --host 127.0.0.1:11435 | 結束碼 0;耗時 4365.2 秒;第一診斷正確 54/200(27%)。 | ||||
| Gemma 4 31B 基線測試 | cd "$LAB" && python skin_classify.py gemma4:31b --host 127.0.0.1:11435 | 結束碼 0;耗時 851.1 秒;第一診斷正確 67/200(34%)。 | ||||
| Mistral Small 3.2 24B 基線測試 | cd "$LAB" && python skin_classify.py mistral-small3.2:24b --host 127.0.0.1:11435 | 結束碼 0;耗時 758.4 秒;第一診斷正確 40/200(20%)。 | ||||
| Qwen3-VL 8B 基線測試 | cd "$LAB" && python skin_classify.py qwen3-vl:8b --host 127.0.0.1:11435 | 結束碼 0;耗時 1223.4 秒;第一診斷正確 48/200(24%)。 | ||||
| MedGemma 4B 基線測試 | cd "$LAB" && python skin_classify.py medgemma:4b --host 127.0.0.1:11435 | 結束碼 0;耗時 533.3 秒;第一診斷正確 20/200(10%)。 | ||||
| 彙整基線評分結果 | cd "$LAB" && python skin_score.py | 結束碼 0;生成包含雲端模型與地端模型的比較表格,確認地端最佳為 Gemma 4 31B(34%)。 | ||||
| Gemma 4 31B:告知類別分布 | cd "$LAB" && python skin_exp.py gemma4:31b --cond prior --host 127.0.0.1:11435 | 結束碼 0;耗時 836.1 秒;第一診斷正確 58/200(29%)。 | ||||
| Gemma 4 31B:先列特徵再判 | cd "$LAB" && python skin_exp.py gemma4:31b --cond features --host 127.0.0.1:11435 | 結束碼 0;耗時 1577.5 秒;第一診斷正確 67/200(34%)。 | ||||
| Gemma 4 31B:只給皮膚鏡圖 | cd "$LAB" && python skin_exp.py gemma4:31b --cond dermo --host 127.0.0.1:11435 | 結束碼 0;耗時 632.3 秒;第一診斷正確 60/200(30%)。 | ||||
| Gemma 4 31B:每類 2 張範例圖 | cd "$LAB" && python skin_exp.py gemma4:31b --cond fewshot --host 127.0.0.1:11435 | 結束碼 0;耗時 865.4 秒;第一診斷正確 65/200(32%)。 | ||||
| Gemma 4 31B:範例圖+分布+特徵疊加 | cd "$LAB" && python skin_exp.py gemma4:31b --cond stack --host 127.0.0.1:11435 | 結束碼 0;耗時 2019.2 秒;第一診斷正確 68/200(34%)。 | ||||
| MedGemma 27B:告知類別分布 | cd "$LAB" && python skin_exp.py medgemma:27b --cond prior --host 127.0.0.1:11435 | 結束碼 0;耗時 1154.0 秒;第一診斷正確 66/200(33%),黑色素瘤 0/30。 | ||||
| MedGemma 27B:先列特徵再判 | cd "$LAB" && python skin_exp.py medgemma:27b --cond features --host 127.0.0.1:11435 | 結束碼 0;耗時 2542.0 秒;第一診斷正確 46/200(23%),黑色素瘤 22/30。 | ||||
| MedGemma 27B:只給皮膚鏡圖 | cd "$LAB" && python skin_exp.py medgemma:27b --cond dermo --host 127.0.0.1:11435 | 結束碼 0;耗時 810.8 秒;第一診斷正確 58/200(29%)。 | ||||
| MedGemma 27B:每類 2 張範例圖 | cd "$LAB" && python skin_exp.py medgemma:27b --cond fewshot --host 127.0.0.1:11435 | 結束碼 0;耗時 1902.5 秒;第一診斷正確 76/200(38%),黑色素瘤 1/30,靠多判痣與脂漏性角化得來。 | ||||
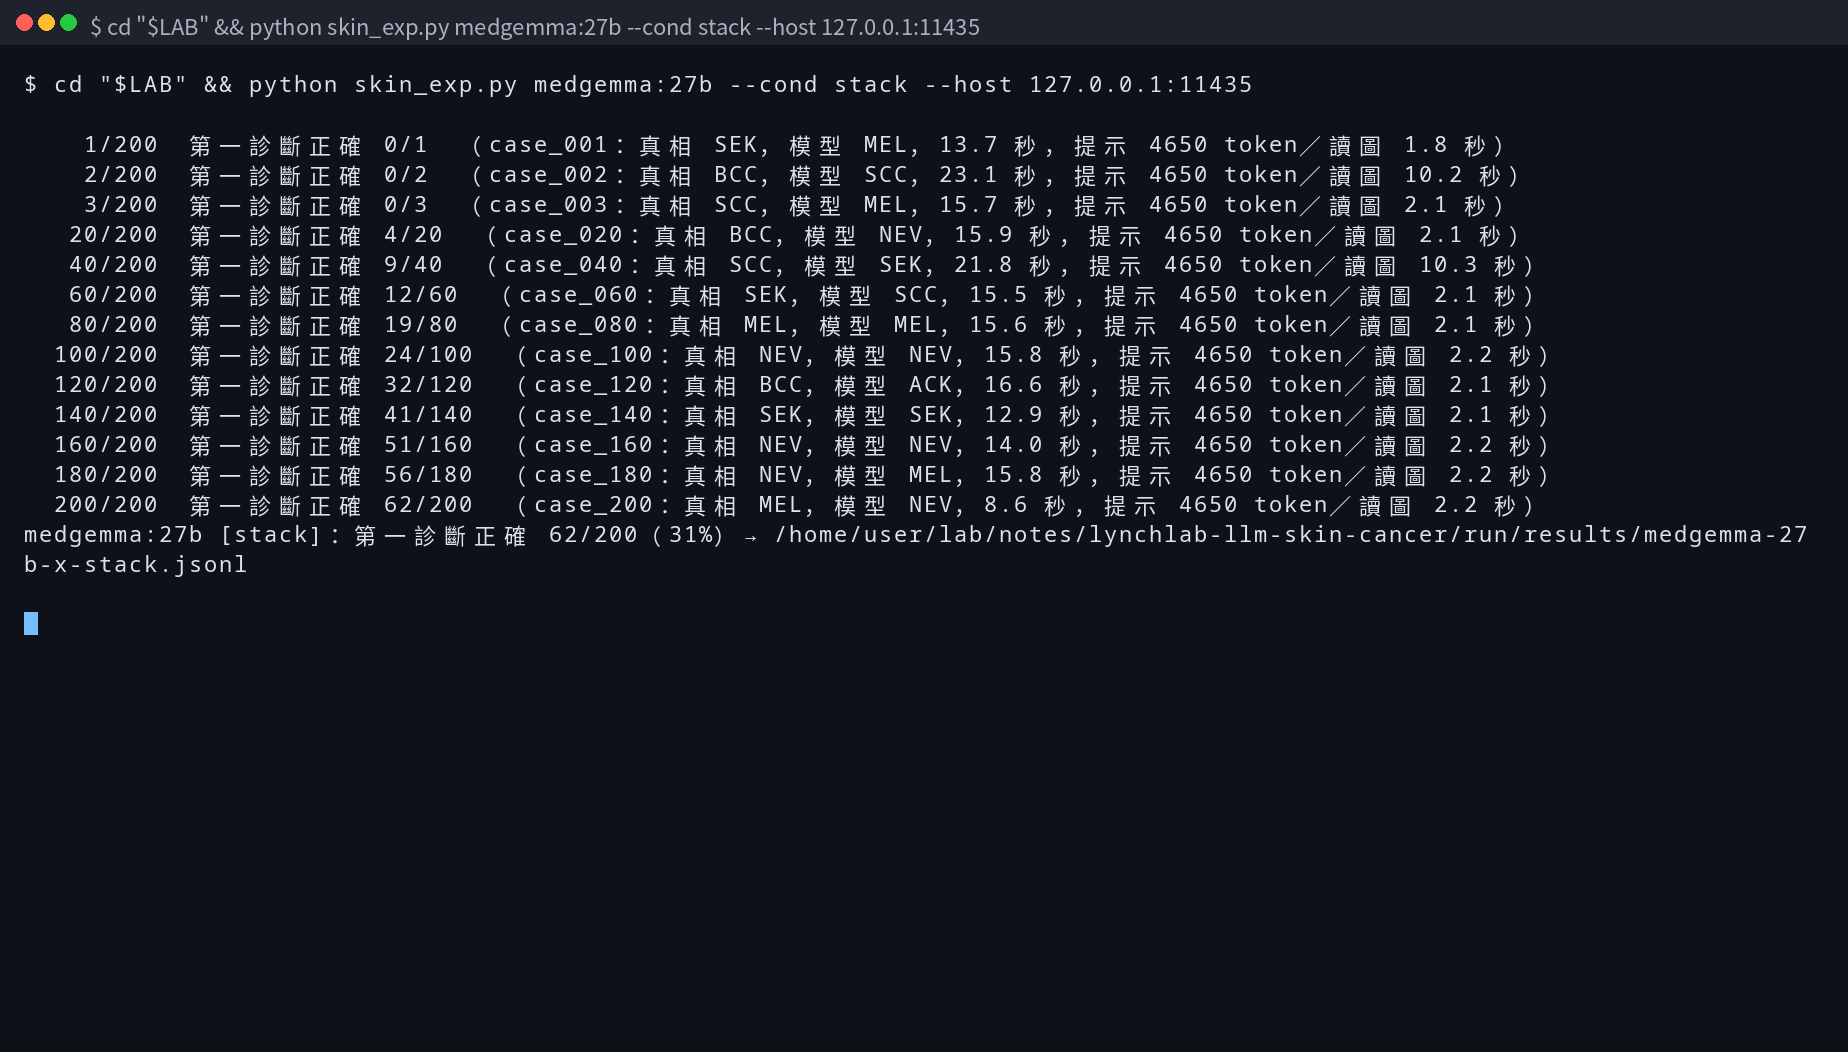
| MedGemma 27B:範例圖+分布+特徵疊加 | cd "$LAB" && python skin_exp.py medgemma:27b --cond stack --host 127.0.0.1:11435 | 結束碼 0;耗時 3125.8 秒;第一診斷正確 62/200(31%)。 | ||||
| 最終評分與投票 | cd "$LAB" && python skin_score2.py | 結束碼 0;生成完整比較表,包含三模型投票結果(35%)與各條件細節。 |
遇到的問題
1. 第一輪 Qwen3-VL 32B 在 50 分鐘內只判了 18 例。原因是本站沒有指定上下文長度,Ollama 依模型預設開到 131072,KV cache 把模型擠到 CPU 上,生成速度只剩 2.7 tok/s。指定 8192 後回到 28 tok/s,每例約 12 到 22 秒。這是本站的設定問題,不是模型能力。
2. 第一輪 Qwen3-VL 8B 有 130 例格式壞掉。Qwen3-VL 即使關閉思考也會先思考一段,把輸出額度吃光,JSON 被截斷。把輸出上限提高到 4000 token、截斷時用規則救回診斷欄位並補跑後,剩 9 例格式錯誤。同樣是本站跑法的問題,但也印證第二節說的:LLM 的輸出要自己解析,而且會壞。
3. MedGemma 4B 有 72 例回答 UNSURE,不計入任何類別;它的 10% 不代表小模型判錯多,而是它多半不作答。
結論
這次實驗要說的是三件事,而不是哪個模型分數高。
1. 近代 AI 的效果取決於資料量,不是模型架構。 十年前的 Inception v3 贏,是因為它用 68,011 張標好類別的影像、直接在像素上學會了這六類的紋理,而且輸出是可以設門檻的機率。2026 年的視覺語言模型參數多上百倍,但在這六類上沒有看過標好答案的資料,最好的只有 34%,比雲端旗艦低 8 個百分點、比 CNN 低 28 個百分點。架構新舊在這題上沒有意義,資料有沒有、夠不夠才有。
2. 選擇適切的工具,才能同時得到效率與正確率。 封閉的影像分類題,專用 CNN 毫秒級、手機能跑、62% 正確;視覺語言模型每例 4 到 22 秒、要一張 48 GB 顯示卡、最好 34%。工具選錯,慢十倍、貴百倍、還比較不準。LLM 該做的是它擅長的事:整合病史、影像與 CNN 的結果,用人話說明給醫師看。
3. 一味把資料倒進最強的模型,期待它自己變準,只是在浪費 token。 給範例圖、告知分布、先列特徵、只給皮膚鏡圖、三者疊加,五種做法沒有一種加到 10 分;看起來進步的那組是靠多猜常見類別換來的,黑色素瘤反而漏得更多。每一個條件都多花了幾倍的 token(範例圖一題 2,300 到 4,400 token,疊加條件一趟跑了 52 分鐘),換到的是錯誤換位置,不是錯誤變少。沒有標好答案的資料,提示詞再長也補不了。
地端模型唯一的實質優點是資料不出機房,但以現在的準確率,它只適合做研究,不適合獨立判讀。
本文不是醫療建議,也不代表任何模型可用於臨床。CNN 的數字引自作者公布,本站未重跑;雲端兩個模型的數字由作者公開的回覆重新評分。
來源:佐證 0 筆,另有背景參考 1 筆
背景參考正文沒有引用,只是相關背景,不計入佐證數
這篇對你有用嗎?
留言 0
- 還沒有留言,第一則就是你的。
留言不用登入;名字選填,沒填就顯示「匿名會員」。含連結或疑似廣告的留言會先經編輯確認;檢舉達 3 次的留言會自動隱藏。隱私政策
發現錯誤?
回報會進入待處理清單;核實後更正,並在文中註記更正紀錄。