背景
Together AI 的研究團隊提出了「多態推論」(Polymorphic Inference)的概念,這是一種應對開放原始碼模型快速發布、架構多樣化、流量形態持續演變以及硬體平台快速更迭的推論方式。過去業界處於「靜態推論」(Static Inference)時代,特徵是封閉模型、傳統 Transformer 架構、單一使用者與單一硬體平台。然而,隨著開放原始碼模型數量激增,OpenRouter 上 80% 的流量流向最近三個月發布的模型,且目前最受歡迎的前十名開放原始碼模型皆採用不同的架構。此外,硬體從 B200 到 GB300 的變化,以及即將部署的 Vera Rubin,都顯示硬體環境正在快速改變。 官方原文・Together AI Blog
發生什麼事
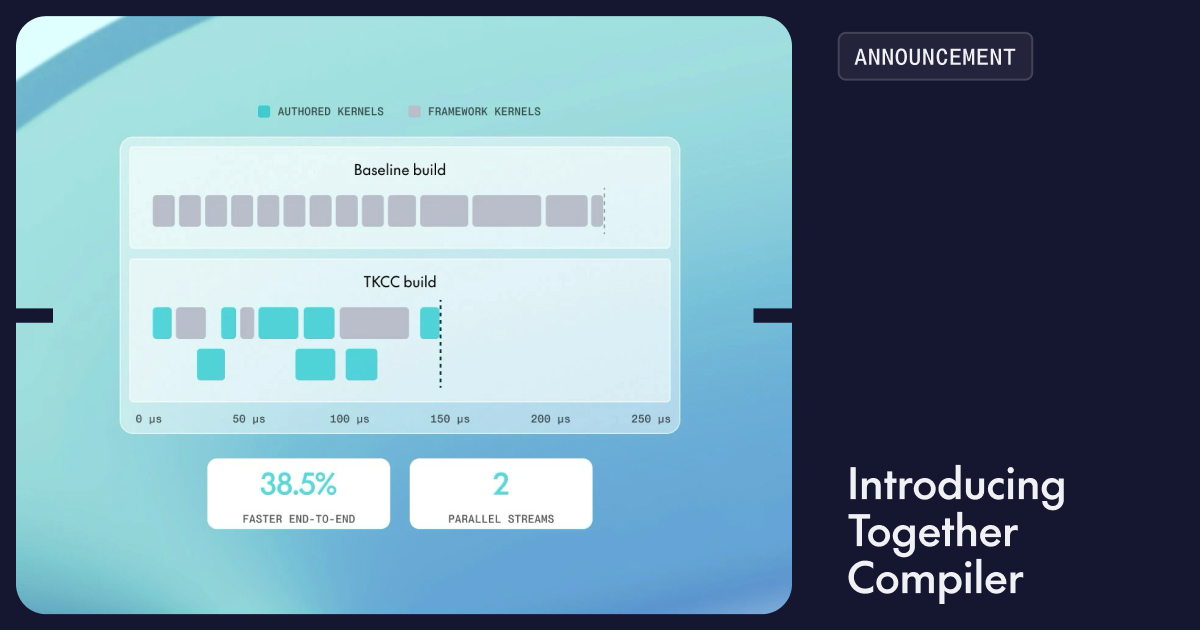
Together AI 於部落格文章中介紹 Together Compiler,這是實現多態推論的第一步。Together Compiler 是一個由 AI 驅動的效能優化迴路,旨在解決推論工作負載的優化挑戰。該工具目前已在其部分最受歡迎的無伺服器(serverless)端點上運行於生產環境,並在已經高度優化的程式碼基礎上進一步提升了效能。 官方原文・Together AI Blog
重點內容
Together Compiler 將傳統的編譯器翻譯問題轉化為代理搜尋(agentic search,由 AI 代理自主探索最佳化方案)問題。它識別出一組核心的優化模式,並結合一群 AI 代理與高保真度的持久化引擎(能長期維持狀態以加速迭代運算的系統)進行快速迭代。這種方法被稱為「持續編譯」(Continuous Compilation),意味著系統可以自動適應新的流量形態和工作負載,而不需要像過去那樣為每個新工作負載手寫新的核心(kernel)和優化。Together AI 指出,過去他們曾嘗試針對單一靜態形狀(例如批次大小為 1 的 Llama 1B)設計巨型核心(megakernels),但發現這並非現代多態推論的正確設計目標,因為每個變異都需要不同的技術方法。 官方原文・Together AI Blog
除了 Together Compiler,Together AI 的研究議程還包括其他幾項技術。首先是「變身式投機解碼(用較小的草稿模型預測結果,再由大模型驗證以加速生成)」(Shape-shifting speculative decoding),旨在讓投機解碼的草稿模型和前瞻參數能根據領域、請求、token 和流量負載進行動態調整,而非像 vLLM 或 SGLang 那樣使用固定配置。其次是 ThunderAgent Router,這是一個用於跨異質部署的路由系統,已作為 ICML 2026 Spotlight 論文發布,用於動態路由請求以應對不同使用者的流量形態和服務等級協議(SLA)。此外,還有 TogetherLink,這是一種工作負載感知的模型路由技術,基於弱監督(利用非精確或自動生成的標籤來訓練模型)和模型組合(Mixture-of-Agents)的研究,旨在透過組合多個模型來提升整體表現。 原文
對使用者的意義
Together Compiler 目前以有限測試版(limited beta)的形式向終端客戶開放。未來,客戶將能夠透過點擊按鈕的方式,使用 Together Compiler 針對其獨特的專有端點(dedicated endpoints)進行效能優化。這意味著開發者和企業可以根據其特定的模型、引擎、流量形態和使用案例,自動獲得更佳的推論效能,而不需要依賴手動的超參數調整。Together AI 表示,他們希望透過這些技術讓 AI 變得更加普及,並幫助使用者應對日益複雜的推論環境。 官方原文・Together AI Blog
限制與未定事項
Together Compiler 目前僅處於有限測試版階段,使用者需要主動聯繫以獲取早期存取權限。 官方原文・Together AI Blog
接下來要看的事
- Together Compiler 在特定模型架構(如 MoE)上的具體效能提升數據
- ThunderAgent Router 在處理異質硬體集群時的實際延遲改善情況
- TogetherLink 模型組合技術與單一大型模型在成本效益上的比較