先說清楚這是什麼、不是什麼
10 月 31 日中午,台北市長候選人蔣萬安與沈伯洋在 TVBS 與三立聯合主辦的電視辯論會正面交鋒,兩小時。辯論一結束,各家媒體的「誰贏了」就出來了:名嘴打分、學者點評、網友投票,也有媒體把逐字稿丟給一個 AI 問「誰表現比較好」。看的人很難分辨哪些是分析、哪些是立場。
本站做的事不一樣:同一份逐字稿、同一張評分表,交給三家公司的模型各打三次分——Anthropic 的 Claude Sonnet 5.5、OpenAI 的 GPT-5.5、Google 的 Gemini 4 Argon。評分表用的是一般辯論比賽的面向,不是政治立場;兩位候選人在送進模型前匿名為「甲」「乙」,而且每次隨機對調,模型不知道誰是誰,也拿不到他們的黨籍、民調或過往形象。所有的提示詞、評分表、九次原始回覆全部公開。
這不是民調,不是支持度,不預測選舉結果。它回答的只有一個問題:單看這兩小時的辯論內容,依照辯論比賽通用的標準,誰講得比較好。
結果:三家一致的地方,和不一致的地方
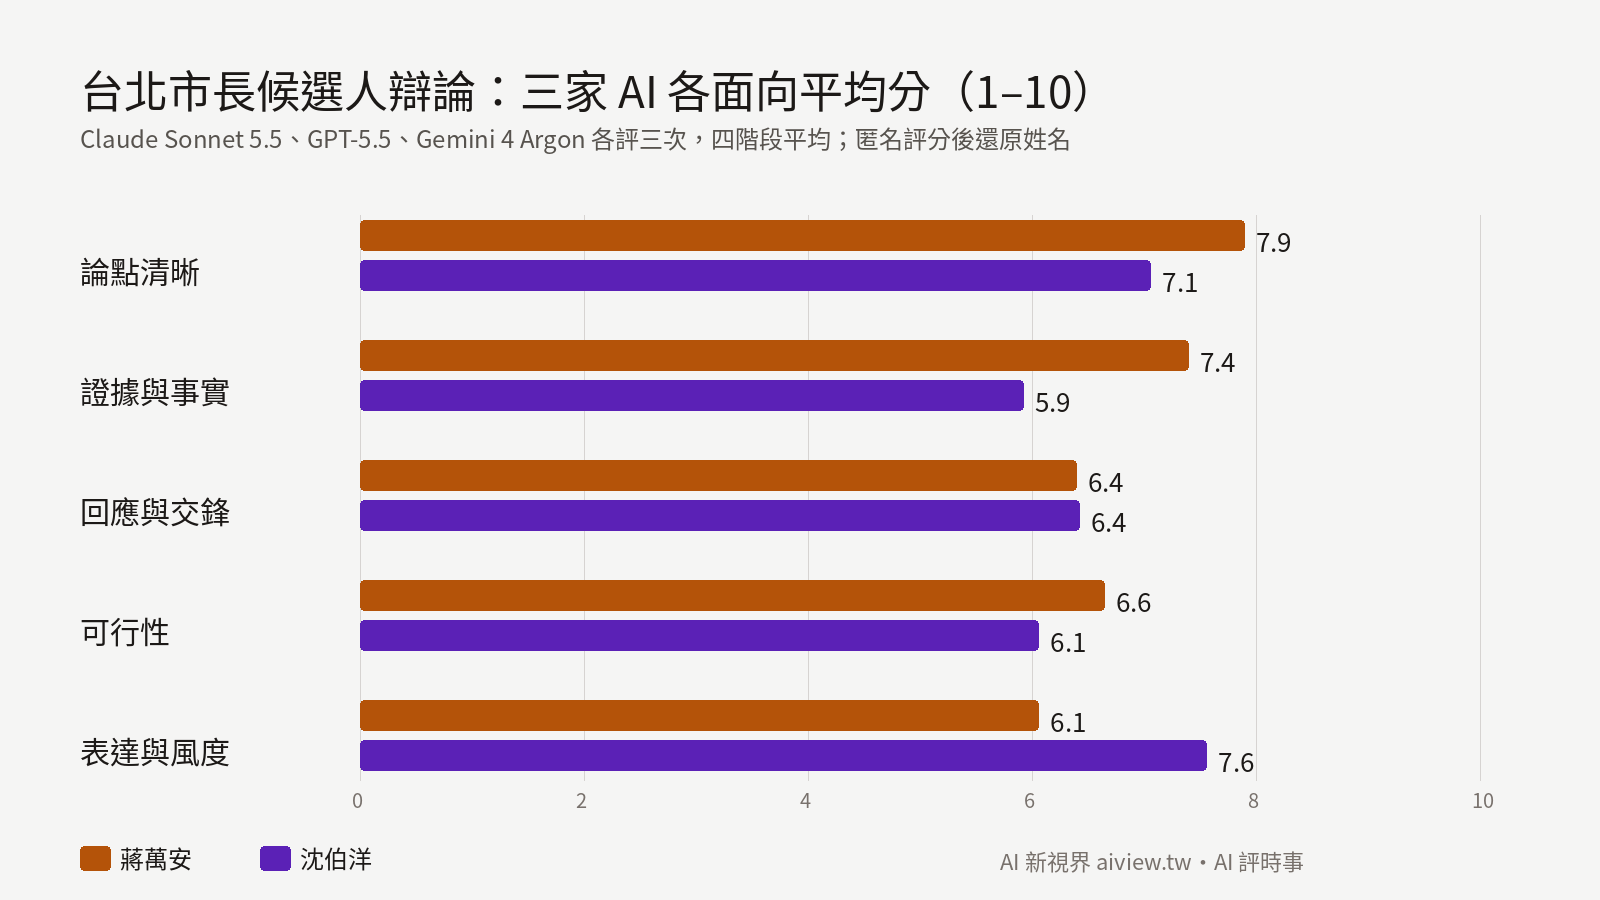
五個面向的分數(四個階段、每家三次的平均;1 到 10 分):
三家雲端平均(四階段、九次)
| 面向 | 蔣萬安 | 沈伯洋 | 領先 |
|---|---|---|---|
| 論點清晰 | 蔣 7.9 | 沈 7.1 | 蔣 +0.8 |
| 證據與事實 | 蔣 7.4 | 沈 5.9 | 蔣 +1.5 |
| 回應與交鋒 | 蔣 6.4 | 沈 6.4 | 持平 |
| 可行性 | 蔣 6.6 | 沈 6.1 | 蔣 +0.6 |
| 表達與風度 | 蔣 6.1 | 沈 7.6 | 沈 +1.5 |
Anthropic/claude-sonnet-5-5
| 面向 | 蔣萬安 | 沈伯洋 | 領先 |
|---|---|---|---|
| 論點清晰 | 蔣 7.2 | 沈 6.2 | 蔣 +1.1 |
| 證據與事實 | 蔣 6.9 | 沈 5.5 | 蔣 +1.4 |
| 回應與交鋒 | 蔣 5.9 | 沈 5.8 | 蔣 +0.2 |
| 可行性 | 蔣 5.5 | 沈 5.8 | 沈 +0.2 |
| 表達與風度 | 蔣 5.3 | 沈 6.8 | 沈 +1.5 |
OpenAI/gpt-5.5
| 面向 | 蔣萬安 | 沈伯洋 | 領先 |
|---|---|---|---|
| 論點清晰 | 蔣 7.9 | 沈 7.3 | 蔣 +0.6 |
| 證據與事實 | 蔣 7.6 | 沈 5.9 | 蔣 +1.7 |
| 回應與交鋒 | 蔣 6.2 | 沈 6.4 | 沈 +0.2 |
| 可行性 | 蔣 6.8 | 沈 6.0 | 蔣 +0.8 |
| 表達與風度 | 蔣 5.7 | 沈 7.7 | 沈 +2.0 |
Google/gemini-4-argon
| 面向 | 蔣萬安 | 沈伯洋 | 領先 |
|---|---|---|---|
| 論點清晰 | 蔣 8.5 | 沈 7.7 | 蔣 +0.8 |
| 證據與事實 | 蔣 7.7 | 沈 6.3 | 蔣 +1.3 |
| 回應與交鋒 | 蔣 7.0 | 沈 7.1 | 沈 +0.1 |
| 可行性 | 蔣 7.7 | 沈 6.4 | 蔣 +1.2 |
| 表達與風度 | 蔣 7.2 | 沈 8.2 | 沈 +1.0 |
Alibaba(地端 Ollama)/qwen3.8:27b-32k(地端參考)
| 面向 | 蔣萬安 | 沈伯洋 | 領先 |
|---|---|---|---|
| 論點清晰 | 蔣 7.8 | 沈 6.8 | 蔣 +0.9 |
| 證據與事實 | 蔣 7.6 | 沈 5.5 | 蔣 +2.1 |
| 回應與交鋒 | 蔣 6.6 | 沈 6.2 | 蔣 +0.3 |
| 可行性 | 蔣 6.4 | 沈 5.7 | 蔣 +0.8 |
| 表達與風度 | 蔣 7.2 | 沈 7.2 | 持平 |
Alibaba(地端 llama.cpp)/Qwen3.8-Flash-Next-180B(地端參考)
| 面向 | 蔣萬安 | 沈伯洋 | 領先 |
|---|---|---|---|
| 論點清晰 | 蔣 7.6 | 沈 7.0 | 蔣 +0.6 |
| 證據與事實 | 蔣 7.4 | 沈 5.4 | 蔣 +2.0 |
| 回應與交鋒 | 蔣 6.9 | 沈 6.0 | 蔣 +0.9 |
| 可行性 | 蔣 6.4 | 沈 5.1 | 蔣 +1.2 |
| 表達與風度 | 蔣 6.0 | 沈 7.9 | 沈 +1.9 |
三家模型在方向上一致:
- 證據與事實是差距最大的一項,蔣萬安高出 1.3 到 1.7 分。三家都提到他反覆引用具體數字與現行機制——大巨蛋、公館圓環事故率、基準容積 225 到 300、5099 公辦都更。
- 表達與風度反過來,沈伯洋高出 1.0 到 2.0 分。三家都點出蔣萬安在交叉詰問與結論階段貼標籤、翻舊帳(「雙城論壇是滲透的破口,這句話是誰說的?」被兩家選為最弱的一段),而沈伯洋「我長得像卓榮泰嗎?我長得像蘇巧慧嗎?」則被三家選為他最弱的一段。
- 回應與交鋒三家都給接近平手:蔣萬安被指多次迴避會議出席率與 SOP 的追問,沈伯洋則被指問 A 答 B、把問題轉到中央權責。
- 論點清晰與可行性蔣萬安領先,但幅度小於證據項;Anthropic 在可行性上反而給沈伯洋略高。
總分與判定:
| 評審(公司/模型) | 蔣萬安 總分 | 沈伯洋 總分 | 判定 |
|---|---|---|---|
| Anthropic/claude-sonnet-5-5 | 蔣 6.3(±0.5,3 次) | 沈 6.0(±0.0,3 次) | 平手 2 次、蔣萬安 1 次 |
| OpenAI/gpt-5.5 | 蔣 8.0(±0.0,3 次) | 沈 7.0(±0.0,3 次) | 蔣萬安 3 次 |
| Google/gemini-4-argon | 蔣 8.0(±0.0,3 次) | 沈 7.0(±0.0,3 次) | 蔣萬安 3 次 |
| Alibaba(地端 Ollama)/qwen3.8:27b-32k(地端參考,不計入平均) | 蔣 7.0(±0.0,3 次) | 沈 6.0(±0.0,3 次) | 蔣萬安 3 次 |
| Alibaba(地端 llama.cpp)/Qwen3.8-Flash-Next-180B(地端參考,不計入平均) | 蔣 7.0(±0.0,2 次) | 沈 6.0(±0.0,2 次) | 蔣萬安 2 次 |
| 三家雲端平均 | 蔣 7.4(±0.8,9 次) | 沈 6.7(±0.5,9 次) |
三家都沒有給出相反的結論,但力道不同:GPT-5.5 和 Gemini 4 Argon 三次都判蔣萬安勝、總分差 1 分;Claude Sonnet 5.5 三次裡兩次判平手、一次判蔣萬安勝,兩人總分只差 0.3,而且它給兩人的分數整體都比另外兩家低一到兩分——同一份逐字稿,Claude 的尺比較嚴。
各階段:
申論
| 面向 | 蔣萬安 | 沈伯洋 | 領先 |
|---|---|---|---|
| 論點清晰 | 蔣 8.3 | 沈 7.0 | 蔣 +1.3 |
| 證據與事實 | 蔣 8.0 | 沈 6.4 | 蔣 +1.6 |
| 回應與交鋒 | 蔣 5.7 | 沈 5.3 | 蔣 +0.3 |
| 可行性 | 蔣 7.1 | 沈 6.0 | 蔣 +1.1 |
| 表達與風度 | 蔣 6.7 | 沈 7.7 | 沈 +1.0 |
交叉詰問
| 面向 | 蔣萬安 | 沈伯洋 | 領先 |
|---|---|---|---|
| 論點清晰 | 蔣 7.0 | 沈 6.9 | 蔣 +0.1 |
| 證據與事實 | 蔣 7.6 | 沈 6.6 | 蔣 +1.0 |
| 回應與交鋒 | 蔣 5.4 | 沈 6.8 | 沈 +1.3 |
| 可行性 | 蔣 6.3 | 沈 6.2 | 蔣 +0.1 |
| 表達與風度 | 蔣 5.1 | 沈 6.9 | 沈 +1.8 |
媒體提問
| 面向 | 蔣萬安 | 沈伯洋 | 領先 |
|---|---|---|---|
| 論點清晰 | 蔣 8.4 | 沈 7.1 | 蔣 +1.3 |
| 證據與事實 | 蔣 7.9 | 沈 5.8 | 蔣 +2.1 |
| 回應與交鋒 | 蔣 8.1 | 沈 7.7 | 蔣 +0.4 |
| 可行性 | 蔣 7.8 | 沈 7.0 | 蔣 +0.8 |
| 表達與風度 | 蔣 7.3 | 沈 7.7 | 沈 +0.3 |
結論
| 面向 | 蔣萬安 | 沈伯洋 | 領先 |
|---|---|---|---|
| 論點清晰 | 蔣 7.8 | 沈 7.2 | 蔣 +0.6 |
| 證據與事實 | 蔣 6.1 | 沈 4.9 | 蔣 +1.2 |
| 回應與交鋒 | 蔣 6.3 | 沈 5.9 | 蔣 +0.4 |
| 可行性 | 蔣 5.3 | 沈 5.0 | 蔣 +0.3 |
| 表達與風度 | 蔣 5.1 | 沈 8.0 | 沈 +2.9 |
階段的樣子也一致:申論與媒體提問是蔣萬安的場子(論點、證據、可行性都領先),交叉詰問是沈伯洋表達與風度領先、證據落後,結論兩人的證據與可行性都掉到 5 分以下——三家都認為結辯階段兩人各自回到訴求和標籤,少了內容。
評審的話(匿名評分後還原姓名,節錄):
- Claude:「政績數字具體、結構清楚,媒體提問和都更回答扎實;但交叉詰問常迴避問題,以質問和翻舊帳為主,結論以標籤攻擊收尾。」/「交叉詰問用出席率、事故排名、營養午餐等細節具體施壓;但申論偏散,部分問題轉移到中央權責,結論偏抒情、缺乏數字。」
- GPT-5.5:「政績與數據多、都更與媒體題具體,但交叉多次人身化且部分未正答。」/「價值與市民參與清楚,部分政策有方向,但預算時程不足且多次未答細節。」
- Gemini:「熟稔市政細節,善用具體政績與數據支撐論點,媒體提問表現極佳;惟交叉詰問多次迴避對手關於出席率與 SOP 的質問。」/「態度沉穩且風度佳,交鋒時能堅持追問市政焦點並拆解對手數據盲點;但面對極為具體的市政個案與量化細節時較不熟悉,部分政見仍流於概念與口號。」
費用:
| 評審 | 次數 | 輸入 token | 輸出 token | 秒數合計 | 費用(美元) |
|---|---|---|---|---|---|
| Anthropic/claude-sonnet-5-5 | 3 | 99,807 | 2,227 | 17 | 0.333 |
| OpenAI/gpt-5.5 | 3 | 79,683 | 4,769 | 76 | 0.542 |
| Google/gemini-4-argon | 3 | 61,125 | 1,718 | 31 | 0.139 |
| Alibaba(地端 Ollama)/qwen3.8:27b-32k | 3 | 56,376 | 13,862 | 516 | 0.000 |
| Alibaba(地端 llama.cpp)/Qwen3.8-Flash-Next-180B | 2 | 37,660 | 10,691 | 680 | 0.000 |
| 切段標記/claude-sonnet-5-5 | 1 | 48,396 | 2,764 | — | 0.187 |
| 合計 | 1.200 |
地端參考組:兩個開源 Qwen 的看法
三家雲端之外,我們也讓本站自己機器上的兩個開源模型用同一套提示評分,當作「如果不花錢、不把逐字稿送出去,會得到什麼」的參考,不計入三家的平均:
- Qwen3.8-Flash-Next-180B(阿里巴巴開源,本站 GB10 主機上以 llama.cpp 執行,也是本站產線的撰稿模型):三次裡兩次成功、一次兩回都輸出壞掉的 JSON;兩次都給蔣萬安 7、沈伯洋 6,判蔣萬安勝。評語:「政績與數據具體,媒體答覆場景化,交鋒積極;但多次翻舊帳與貼標籤,風度扣分」/「主軸溫和清楚,追問出席與標準有效,風度佳;但數據、預算與執行細節不足,結論偏情感」。
- Qwen3.8 27B(同系列小模型,本站 RTX A6000 上以 Ollama 執行):三次都給蔣萬安 7、沈伯洋 6,判蔣萬安勝。評語和大模型幾乎一樣,多了一句「交叉詰問中『我長得像卓榮泰嗎』等回應顯閃避」。
兩個地端模型的方向和三家雲端一致,分數落在 Claude 與另外兩家之間;差別在穩定度——180B 三次有一次格式失敗,27B 每次要兩到五分鐘,而三家雲端一次 6 到 30 秒。地端模型的費用是 0,三家雲端加切段合計 1.2 美元。
從選舉的角度看這些分數
分數本身不會決定選舉,但它把兩個人在這兩小時裡端出來的東西拆開了,拆開之後能看到幾件和選戰有關的事。
蔣萬安打的是「現任」牌,而且三家都買單——在證據項。 證據與事實是他領先最多的面向(+1.5),媒體提問階段三家給他的論點、證據、可行性都是全場最高;三家引用的「最有力」段落幾乎都是具體數字:大巨蛋、公館圓環事故率、基準容積 225 到 300、5099 公辦都更。對一個現任者,這是最自然也最難被反駁的訴求:「我做了什麼」比「我會做什麼」好驗證。這一塊的目標選民是看政績投票的人,辯論替他鞏固了這群人。
但他在交叉詰問付出的代價也是三家一致的。 表達與風度是他落後最多的面向(−1.5),交叉詰問階段 Anthropic 給到 4.5 分;三家選出的「最弱段落」全部來自他質問對手過去言論、貼標籤的句子(「雙城論壇是滲透的破口,這句話是誰說的?」「你還真的是不了解市政……已讀亂回」),加上被指多次迴避出席率與 SOP 的追問。這對基本盤不是問題,對他這次辯論明顯想爭取的中間選民是風險:政績牌講給他們聽,標籤牌卻可能把他們推開。下一場辯論,他的題目是在不丟掉「市政熟悉度」的前提下,把交叉詰問從攻擊對手的過去改成回答對手的問題。
沈伯洋的強項是價值敘事和風度,三家也一致。 表達與風度全場最高(7.6),結論階段 7.5;三家選的「最有力」段落都是框架式的話:「數字像溫度計上的溫度,不是體感溫度」「先有市民,才有市長」「都更入口開那麼寬,出口卻那麼窄」。這類訴求打的是對現狀有感、覺得「數字漂亮但生活沒變」的選民,辯論讓這個框架被聽見了。
他的短板是證據與可行性,而且是三家給分最低的面向之一。 證據與事實 5.9、結論階段只有 4.3;三家的理由都提到「政見流於概念與口號」「預算、時程、技術細節不足」「對具體市政個案不熟」,Gemini 直接點出他引介東京制度時說「因為時間因素沒辦法介紹」。對一個挑戰者,這是必須補的功課:價值敘事能讓人想換,具體方案才能讓人敢換。他在媒體提問階段的都更回答(陪伴、初篩、行動服務團)是三家少數肯定他有步驟的地方,顯示他做得到,只是這場做得太少。
三家的分歧也有訊息。 Claude 給兩人的分數都比另外兩家低一到兩分、兩次判平手,代表在比較嚴格的尺度下,這場辯論沒有一方把對方比下去;GPT-5.5 與 Gemini 判蔣勝但總分只差 1 分。把三家放在一起看,這是一場「現任者守住了專業形象、挑戰者守住了價值形象、兩人都沒有擴張到對方的地盤」的辯論。對選情的意義是:這場辯論比較可能強化既有支持者的判斷,而不是改變它;真正會動的是那些同時在乎「做得到」和「有沒有被照顧」的選民,而兩人這一晚各只給了他們一半。
這些是從分數和評語推出來的觀察,不是預測。選舉還有四週,還會有更多場合;本站會用同一套方法評下一場,到時才看得出誰補了短板。
完整提示詞
評分用的系統提示(三家一字不差,都是這一段):
你是辯論比賽的評審。下面是一場市長候選人電視辯論的逐字稿(語音辨識,可能有錯字),兩位候選人已匿名為「甲」「乙」。
請只根據逐字稿內容評分,不要猜測他們是誰,也不要使用你對任何政治人物的既有印象或立場。評分面向(每項 1 到 10 分,10 最好):
- clarity 論點清晰:主張是否明確、有結構、聽眾能複述。
- evidence 證據與事實:有沒有具體數字、來源、案例;引用是否具體(不要求你查證真偽,但空泛口號要扣分)。
- engagement 回應與交鋒:有沒有正面回答對方與提問人的問題,還是問 A 答 B;反駁是否針對對方論點。
- feasibility 可行性:政策有沒有說怎麼做、預算、時程、權責;只喊目標不講方法要扣分。
- delivery 表達與風度:語言是否清楚,有無人身攻擊、貼標籤、搶話或違規。
每個階段(申論、交叉詰問、媒體提問、結論)分開打,再給整場總分(1–10,不是平均,是你的整體判斷)與 80 字內的理由,並各給一句「最有力的一段」與「最弱的一段」(引用逐字稿原句)。
輸出 JSON:
{"phases":{"申論":{"甲":{"clarity":n,"evidence":n,"engagement":n,"feasibility":n,"delivery":n},"乙":{...}}, ...},
 "overall":{"甲":{"score":n,"reason":"...","best":"...","worst":"..."},"乙":{...}},
 "winner":"甲"|"乙"|"平手"}
只輸出 JSON。
使用者訊息只有一行開頭「逐字稿(兩位候選人匿名為甲、乙):」,後面接整份切好段的逐字稿,格式是:
## 階段:申論
主持人:……
乙:……
甲:……
## 階段:交叉詰問
……
送進模型前,以下字串一律替換成「甲」或「乙」(含語音辨識的錯字變體,稱謂「市長」「委員」保留):
蔣萬安:蔣[萬灣][安恩]?|蔣娃|蔣官|講官|講完先生|講案先生|蔣安先生|蔣(?=市長|先生|候選人)
沈伯洋:沈[伯柏北不浦梅博浩貝][洋陽]?|省委員|神務委員|沈務委員|沈(?=委員|先生|候選人|市長)
切段用的系統提示(只給 Claude,切完三家共用):
你拿到的是一場台北市長候選人電視辯論的語音辨識逐字稿,每行開頭是秒數。請標出「發言人或階段改變」的時間點。
階段只有四種:申論、交叉詰問、媒體提問、結論。發言人只有:主持人、提問人、蔣萬安、沈伯洋。
判斷依據是主持人的口令(例如「請○○候選人進行申論」「接下來交叉詰問」「請媒體提問」「最後結論」)、計時鈴聲前後的轉換,以及上下文(候選人互相稱呼對方、自稱「我在市長任內」等)。
不要重抄逐字稿。只輸出每一次換人或換階段的那一行的秒數,以及從那一刻起的 phase 與 speaker。
輸出 JSON:{"marks":[{"start": 秒數(整數), "phase": "...", "speaker": "..."}, ...]},依時間排序,第一筆從 0 秒開始(開場是主持人、階段寫「申論」前的開場也算「申論」)。只輸出 JSON。
API 參數:Claude max_tokens 8000、其餘預設;GPT-5.5 預設;Gemini temperature 0.3、要求 JSON 輸出;沒有開啟搜尋或任何工具。每家各跑三次,第一與第三次「甲」是蔣萬安,第二次對調。
怎麼做的
逐字稿。 來源是主辦單位 TVBS 在 YouTube 上的官方直播存檔(2 小時 7 分鐘),本站用 Whisper large-v3-turbo 轉成文字,再由模型依主持人的口令(「請○○候選人申論」「接下來交叉詰問」「媒體提問」「結論」)切成四個階段、標上發言人。語音辨識有錯字,我們不修,三家模型拿到的是同一份。
匿名與對調。 送進模型前,「蔣萬安」一律換成「甲」或「乙」,「沈伯洋」換成另一個,連候選人互相稱呼對方的名字也換掉;每一次評分隨機決定誰是甲,三次裡至少對調一次,用來抵銷模型對「甲」或「乙」這個位置本身可能有的偏好。
評分表。 四個階段(申論、交叉詰問、媒體提問、結論)各自打分,每階段五個面向,各 1 到 10 分:
| 面向 | 看什麼 |
|---|---|
| 論點清晰 | 主張明確、有結構、聽眾能複述 |
| 證據與事實 | 有具體數字、來源、案例;空泛口號扣分(不要求模型查證真偽) |
| 回應與交鋒 | 正面回答對方與提問人,還是問 A 答 B;反駁有沒有針對對方論點 |
| 可行性 | 政策有沒有說怎麼做、預算、時程、權責;只喊目標不講方法扣分 |
| 表達與風度 | 語言清楚,有無人身攻擊、貼標籤、搶話或違規 |
最後再給整場總分(1 到 10,是整體判斷、不是平均)、80 字理由、各引一句「最有力的一段」與「最弱的一段」,以及勝負判定。
模型與次數。 三家各跑三次,共九次;表格給平均與標準差,標準差大代表同一個模型自己也不太確定。模型版本:claude-sonnet-5-5、gpt-5.5、gemini-4-argon,都用各家 API 的預設設定,沒有開搜尋、沒有給任何背景資料。
公開什麼。 評分程式、提示詞、逐字稿切段結果、九次原始 JSON 回覆都放在本站程式庫 ops/lab/debate;文章裡的每個數字都能回溯到那裡。
限制
- 語音辨識的錯字會影響「證據與事實」那一項:數字聽錯了,模型就會以為候選人講錯。我們抽查過幾段,整體可讀,但這是系統性的誤差來源。本文引用的段落已依多家報導把人名與用語校正回原話(「蘇喬惠」→蘇巧慧、「以毒亂回」→已讀亂回、「大接闊」→大街廓;「5099」查證後是公辦都更門檻的政策名稱,原文如此),送給模型評分的逐字稿則維持辨識原樣,沒有改。
- 模型只看文字,看不到表情、語氣、停頓;「表達與風度」只能從用字判斷。
- 匿名擋得住名字,擋不住內容:候選人談到自己的任內政績或所屬政黨時,模型可能猜得出誰是誰。我們沒有辦法完全排除這一層。
- 三家模型都是美國公司的產品,訓練資料裡對台灣政治的理解深淺不一;它們一致的地方比較可信,分歧的地方就是分歧。
- 這是第一次做,評分表和流程會依讀者回饋調整;下一場辯論會用同一套方法再做一次,才有比較基礎。