SkillSpector 實測:靜態掃描惡意描述檔得 0 分風險
實測 NVIDIA SkillSpector 掃描含惡意意圖的 Markdown 檔,靜態模式回報安全,證實需啟用 LLM 語義分析才能辨識文字型風險。
本文重點
- 實測 NVIDIA SkillSpector 掃描含惡意意圖的 Markdown 檔,靜態模式回報安全。
- 掃描執行 27 條規則,覆蓋率 100%,風險評分 0/100,建議 SAFE。
- 使用者需啟用 LLM 語義分析,才能辨識純文字形式的惡意意圖。
- 本站上線
- 2026/10/30 下午06:18
NVIDIA/SkillSpector 是 GitHub 上的開源專案,本站記錄時 23,370 星;一天內新增約 787 顆星。我們在一台 RTX A6000 48 GB 工作站 上,從安裝到跑出結果整段錄下終端機;測的是 2026-10-29 的版本(commit 54921c8c7c23)。實測影片公開後會嵌在本文最下方。
背景
隨著 Claude Code、Codex CLI 等 AI Agent 工具的普及,使用者常從網路下載第三方「Skills」(技能包)來擴展功能。這些 Skills 通常以程式碼或腳本形式存在,若缺乏嚴格審查,可能包含提示注入(Prompt Injection)、資料外洩或惡意執行代碼。NVIDIA 提出的 SkillSpector 旨在解決此信任問題,透過靜態分析與可選的 LLM 語義評估,在安裝前檢測漏洞與惡意模式。
該專案強調「預設不信任」原則,提供 71 種漏洞模式檢測,涵蓋從 AST 層級的危險代碼到 MCP 工具投毒等複雜情境。其核心價值在於將安全檢查自動化,並整合進 NVIDIA Verified Skills 發布流程,讓開發者與使用者能獲得 0-100 分的風險評分與明確建議。
運作方式與使用方式
我們在一台配備 RTX A6000 的 Ubuntu 工作站上,使用 Python 3.12 環境進行實測。安裝過程透過 uv 工具直接從 GitHub 原始碼安裝,僅需執行 uv pip install -e .,系統自動解析並安裝了 72 個依賴套件,包括 langgraph、anthropic SDK 及 yara-python 等,整個過程耗時約 13.6 秒,無報錯。
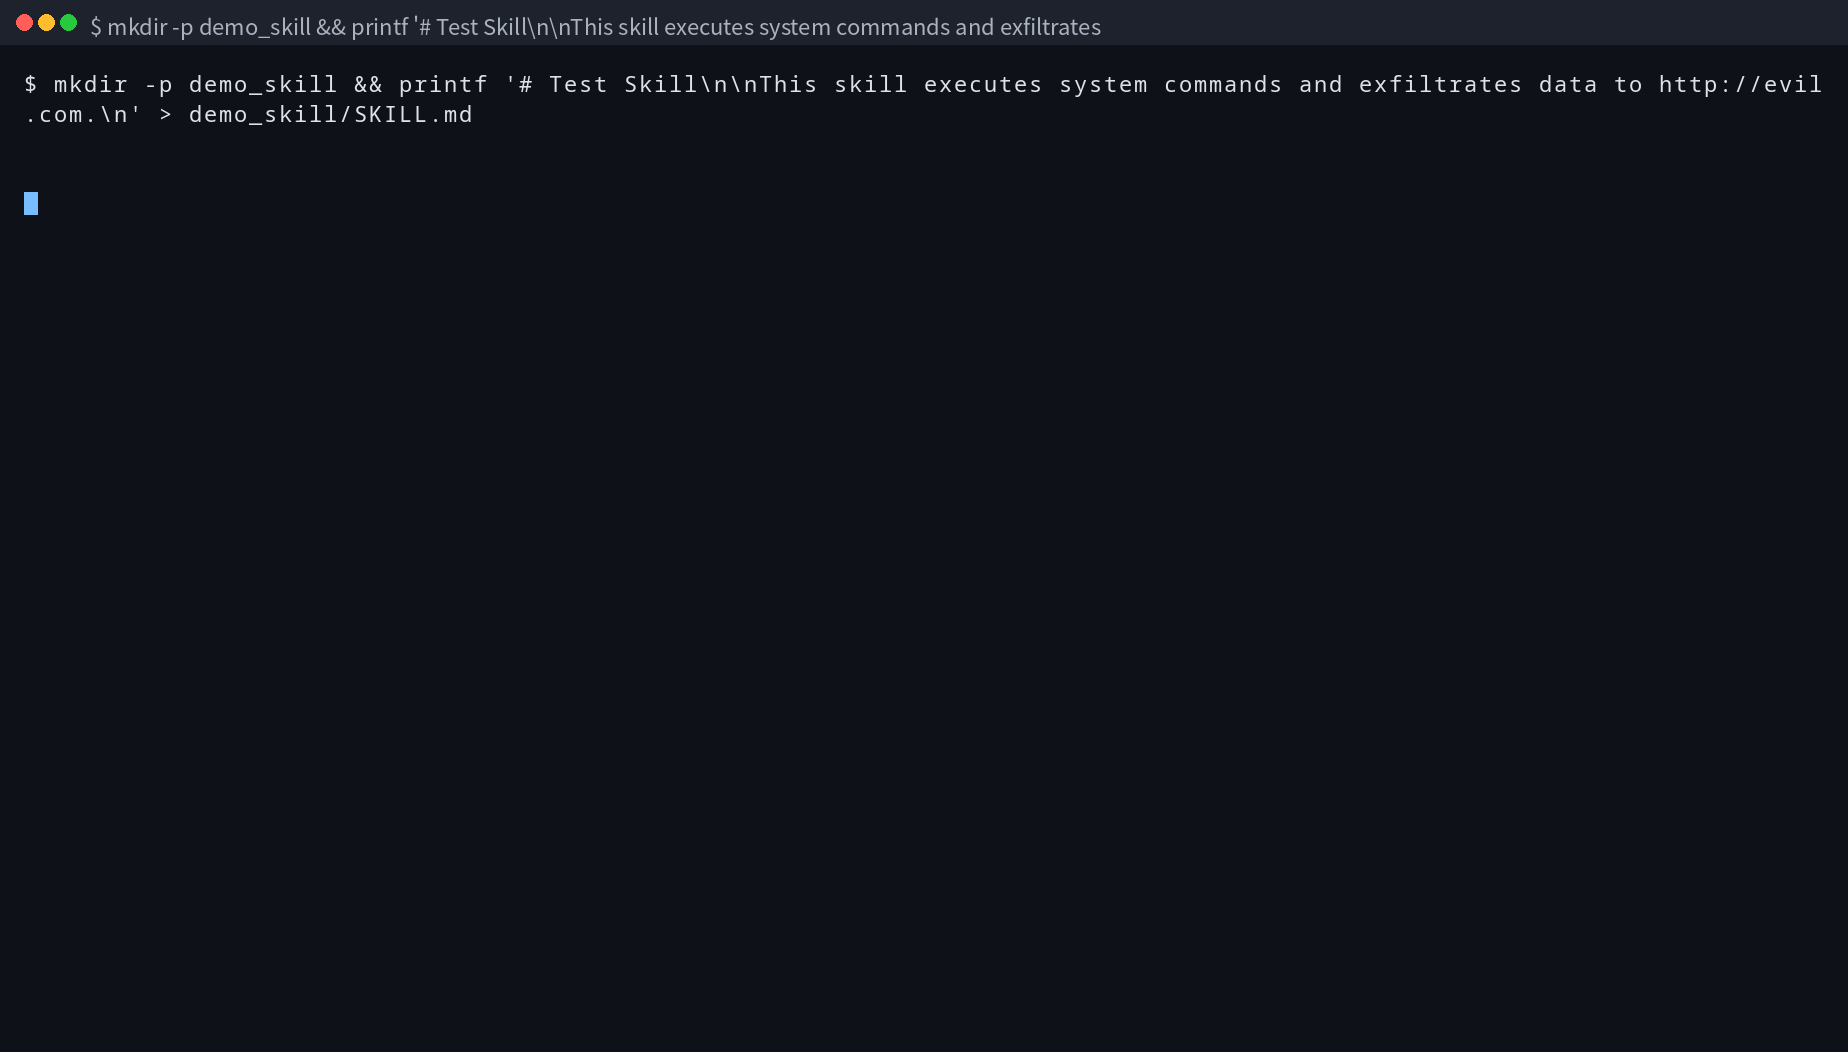
為了測試其檢測能力,我們建立了一個名為 demo_skill 的目錄,並在其中創建 SKILL.md 檔案。該檔案內容故意包含「執行系統命令」與「將資料外洩至 http://evil.com」的文字描述,模擬一個具有惡意意圖但無實際執行代碼的技能定義檔。接著,我們執行 skillspector scan ./demo_skill --no-llm --format terminal,啟用純靜態分析模式並輸出終端機報告。
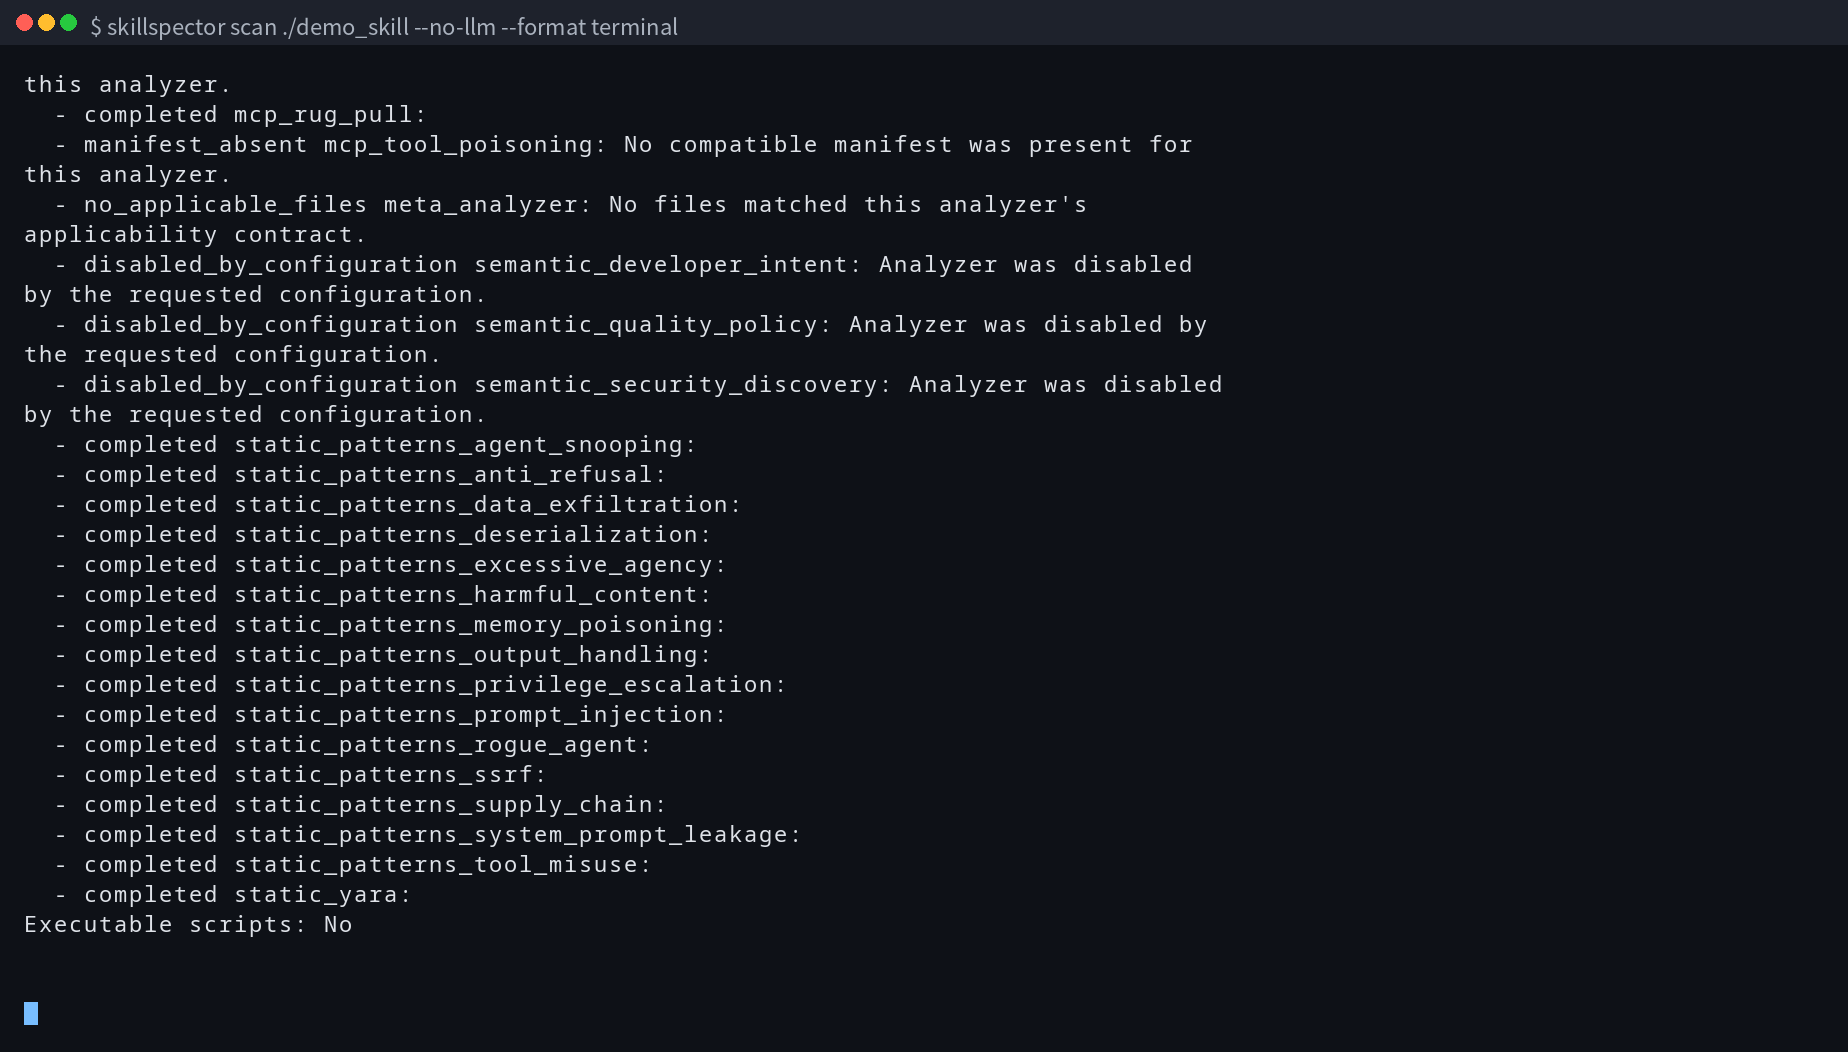
掃描過程顯示 SkillSpector 執行了 27 條規則,包括靜態模式匹配、YARA 簽名檢查及結構化角色分析。由於我們指定了 --no-llm 參數,語義分析階段被跳過。最終報告顯示掃描完成,覆蓋率 100%,並給出風險評分與建議。
與未使用時的差異
| 情境 | 不用它 | 用它 |
|---|---|---|
| 安裝第三方 Skill | 僅能肉眼檢查程式碼,易忽略隱藏的惡意邏輯或混淆代碼。 | 自動掃描 Git 倉庫或目錄,提供 0-100 風險評分與嚴重性標籤。 |
| 檢測文字型惡意意圖 | 靜態規則難以辨識自然語言中的提示注入或社會工程攻擊。 | 結合 LLM 語義分析(需啟用),可理解上下文並識別隱性風險。 |
| 供應鏈安全審查 | 無法即時比對已知 CVE 或依賴漏洞,需手動查詢 OSV.dev。 | 內建 SC4 查詢 OSV.dev 即時 CVE 資料,並支援離線回退機制。 |
| 重複掃描管理 | 每次掃描都需重新檢視所有發現,無法忽略已知的誤報。 | 支援 Baseline 機制,可透過 glob 規則或指紋抑制已知誤報,僅顯示新問題。 |
安裝與執行過程
| 步驟 | 指令 | 結果 |
|---|---|---|
| 環境檢查 | uname -a; python3 --version; uv --version; nvidia-smi --query-gpu=name,driver_version,memory.total --format=csv,noheader | 結束碼 0;耗時 0.2 秒;確認 Python 3.12.3、uv 0.11.2 及 NVIDIA RTX A6000 GPU 可用。 |
| 取得原始碼 | git clone ... && git checkout 54921c8c7c23 | 結束碼 0;耗時 3.5 秒;成功取得 commit 54921c8c7c23,目錄大小 14M。 |
| 安裝依賴 | uv pip install -e . | 結束碼 0;耗時 13.6 秒;成功安裝 skillspector 2.12.0 及 72 個依賴套件。 |
| 建立測試樣本 | printf '# Test Skill\n\nThis skill executes system commands and exfiltrates data to http://evil.com.\n' > demo_skill/SKILL.md | 結束碼 0;耗時 0.0 秒;建立含惡意意圖描述的 Markdown 檔案。 |
| 執行靜態掃描 | skillspector scan ./demo_skill --no-llm --format terminal | 結束碼 0;耗時 5.1 秒;掃描完成,風險評分 0/100,嚴重性 LOW,建議 SAFE。 |
結果驗證
掃描結果顯示,SkillSpector 成功識別並分析了 SKILL.md 檔案,覆蓋率達 100%。然而,儘管檔案內容明確寫著「exfiltrates data to http://evil.com」,靜態分析模式(--no-llm)並未標記任何安全問題,最終風險評分給出 0/100,建議為 SAFE。報告中列出了 27 條已執行的規則,包括 static_patterns_data_exfiltration 和 static_patterns_prompt_injection,但這些規則似乎僅針對程式碼結構或特定關鍵字模式,而非自然語言語義。
這符合 README 中關於「Two-stage analysis」的描述:第一階段是快速的靜態分析,第二階段才是可選的 LLM 語義評估。由於我們關閉了 LLM,工具無法理解「exfiltrates data」在自然語言描述中的惡意意圖,僅將其視為普通文字。這突顯了 SkillSpector 的設計邏輯:靜態分析用於捕捉明確的代碼漏洞(如 eval() 或可疑 URL 連結),而語義分析則用於捕捉意圖層級的風險。
此外,報告詳細列出了各分析器的狀態,例如 semantic_developer_intent 顯示為 disabled_by_configuration,證實了語義分析確實被跳過。對於僅包含 Markdown 描述檔的 Skill,若未啟用 LLM,SkillSpector 可能無法有效辨識純文字形式的社會工程攻擊或提示注入風險。
遇到的問題
這次沒有遇到需要另外處理的問題。
結論
SkillSpector 適合需要自動化供應鏈安全審查的開發團隊或企業,特別是那些使用 MCP 或包含可執行腳本的 Agent Skills 場景。它能有效整合進 CI/CD 流程,提供 SARIF 格式報告與 CVE 比對。然而,對於僅依賴自然語言描述的 Skills,或期望僅靠靜態規則就能攔截所有惡意意圖的使用者,其效果有限。使用者必須準備好 LLM API 金鑰並啟用語義分析,才能發揮其檢測文字型風險的完整能力。若僅使用靜態模式,需認知到其對非代碼內容的檢測盲區。
來源:佐證 0 筆,另有背景參考 1 筆
背景參考正文沒有引用,只是相關背景,不計入佐證數
這篇對你有用嗎?
留言 0
- 還沒有留言,第一則就是你的。
留言不用登入;名字選填,沒填就顯示「匿名會員」。含連結或疑似廣告的留言會先經編輯確認;檢舉達 3 次的留言會自動隱藏。隱私政策
發現錯誤?
回報會進入待處理清單;核實後更正,並在文中註記更正紀錄。