資料不是多就有用:皮膚癌實測續篇,訓練影像與題目同來源才是準確率關鍵
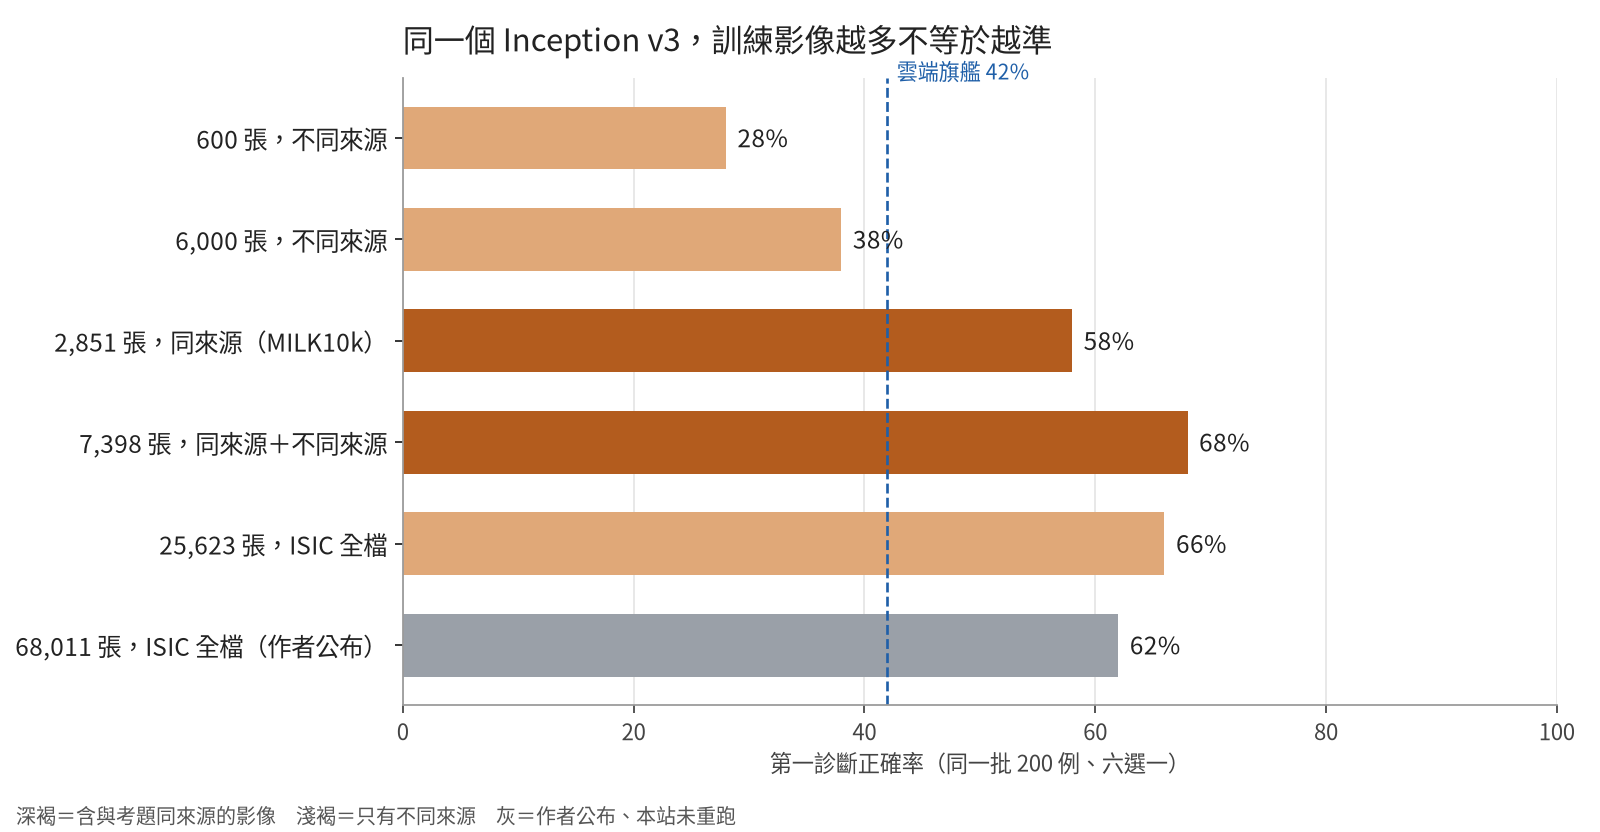
範例圖從 2 張加到 100 張,Gemma 4 31B 最高只到 40%;同一批資料拿去微調,十年前的 Inception v3 用與考題同來源的 2,851 張影像得 58%,加上不同來源 6,000 張得 68%,超過作者 68,011 張的 62%,再倒進 ISIC 全檔 25,623 張反而退步。決定準確率的不是張數,是訓練影像和題目是不是同一個分布。
本文重點
- 資料要和題目同一個分布:同來源 2,851 張(58%)勝過不同來源 6,000 張(38%),7,398 張(68%)勝過 25,623 張(66%),也勝過作者的 68,011 張(62%)。
- 小模型加對的資料勝過大模型加提示:A6000 跑 11 分鐘的 Inception v3 得 68%;Gemma 4 31B 給 100 張範例圖每題 41 秒只到 38%,Qwen3-VL-4B 微調最好 56%、訓練時間是 CNN 的 10 倍。
- 通用模型的位置是分流與說明,不是判讀:封閉的六選一分類,視覺語言模型提示或微調都追不上 CNN;合理架構是 CNN 判讀、LLM 解釋與補位。
- 本站上線
- 2026/10/29 下午11:56
上一篇〈定義題目即決定結果〉用 Magnus Lynch 公開的皮膚癌 200 例題庫,測出六個地端視覺語言模型最好只有 34%,五種提示方法沒有一種加到 10 分,結論是準確率靠資料而不是架構。這一篇把「資料」這件事拆開來做:範例圖從每類 2 張加到 100 張,看提示能不能靠數量追上;再用同一張 RTX A6000 48 GB 把十年前的 Inception v3、2022 年的 ConvNeXt-Tiny 和 Qwen3-VL-4B 分別微調,訓練資料從 600 張一路加到 25,623 張,而且刻意分成「與考題同來源」和「不同來源」兩種。結果是:同來源 2,851 張微調的 CNN 拿到 58%,不同來源 6,000 張只有 36%;兩者合起來 7,398 張得 68%,超過作者用 68,011 張得到的 62%。決定準確率的不是張數,是訓練資料和題目是不是同一個分布。
這個實驗在測什麼
題目與上一篇相同:作者從 MILK10k(ISIC 2025 年公開的資料集)隨機抽 200 例,全部有病理確診,六類比例是黑色素瘤 30、基底細胞癌 25、鱗狀細胞癌 25、光化性角化 20、痣 50、脂漏性角化 50。每例給臨床照片與皮膚鏡影像各一張,模型選一個第一診斷。作者的參考數字:GPT-6 Astra 84(42%)、Claude Fable 5.1 85(42%)、Inception v3 CNN 以 68,011 張影像微調後 125(62%)。
這一篇要回答三個問題:
1. 不訓練、只在提示裡塞更多標好答案的範例圖,視覺語言模型能追到多高?
2. 用同樣的資料去微調,CNN 和視覺語言模型誰學得快、學得準?
3. 訓練資料的「數量」和「來源」哪一個更決定結果?
本站的做法
- 範例圖學習曲線:從 ISIC Archive 另抓六類各 100 張皮膚鏡影像(病理確診優先,排除測試 200 例及同病灶的所有影像),每類取 10、50、100 張標好答案放進提示,Gemma 4 31B 三級都跑,MedGemma 27B 只跑 10 張那級。範例順序固定,讓 Ollama 的提示快取生效;MedGemma 的快取不穩(平均每題重讀圖 23 秒),50 張以上沒有跑。
- 微調的三種模型:Inception v3(2015 年,timm 的 ImageNet 權重,全層微調)、ConvNeXt-Tiny(2022 年,ImageNet-22k 預訓練,全層微調)、Qwen3-VL-4B-Instruct(LoRA r=16,預設只訓語言層,另跑一組連視覺編碼器一起訓)。CNN 訓練 12 到 30 輪、取驗證集最好的一輪;LoRA 1 到 3 輪。
- 訓練資料分四級,全部排除測試 200 例與同病灶影像:
- 600 張:與範例圖同一批(ISIC 各類 100 張)。
- 約 6,000 張:ISIC 各類 1,000 張(鱗狀細胞癌只有 757 張)。ISIC 的搜尋 API 依建檔時間排序,這批多半是 2016 年前後的舊集子,與 MILK10k 不同來源。
- 2,851 張:只取 MILK10k 本身(ISIC collection 425),與考題同一套相機與標註流程。各類:基底細胞癌 1,000、痣 586、鱗狀細胞癌 466、黑色素瘤 406、脂漏性角化 290、光化性角化 103。
- 25,623 張:ISIC 全檔這六類全拿(痣與基底細胞癌各上限 8,000 張、不限確診方式),含上述三批。
- 評分程式與上一篇同一套,比第一診斷正確數,同時看黑色素瘤 30 例抓到幾例。
- 全部在一張 RTX A6000 上跑;每一級的訓練時間都列在下面,因為「要花多少算力」是選工具的一部分。
一、把範例圖加到 100 張,提示追不上
| 模型 | 每類範例圖 | 提示長度 | 每題耗時 | 正確 | 黑色素瘤抓到(30) |
|---|---|---|---|---|---|
| Gemma 4 31B | 0(基線) | 約 600 token | 4 秒 | 67(34%) | 11 |
| Gemma 4 31B | 2 | 2,302 token | 3 秒 | 65(32%) | 2 |
| Gemma 4 31B | 10 | 3,200 token | 4 秒 | 80(40%) | 15 |
| Gemma 4 31B | 50 | 6,230 token | 11 秒 | 71(36%) | 10 |
| Gemma 4 31B | 100 | 9,344 token | 41 秒 | 76(38%) | 5 |
| MedGemma 27B | 0(基線) | 約 700 token | 5 秒 | 59(30%) | 13 |
| MedGemma 27B | 10 | 18,920 token | 7 到 23 秒 | 67(34%) | 2 |
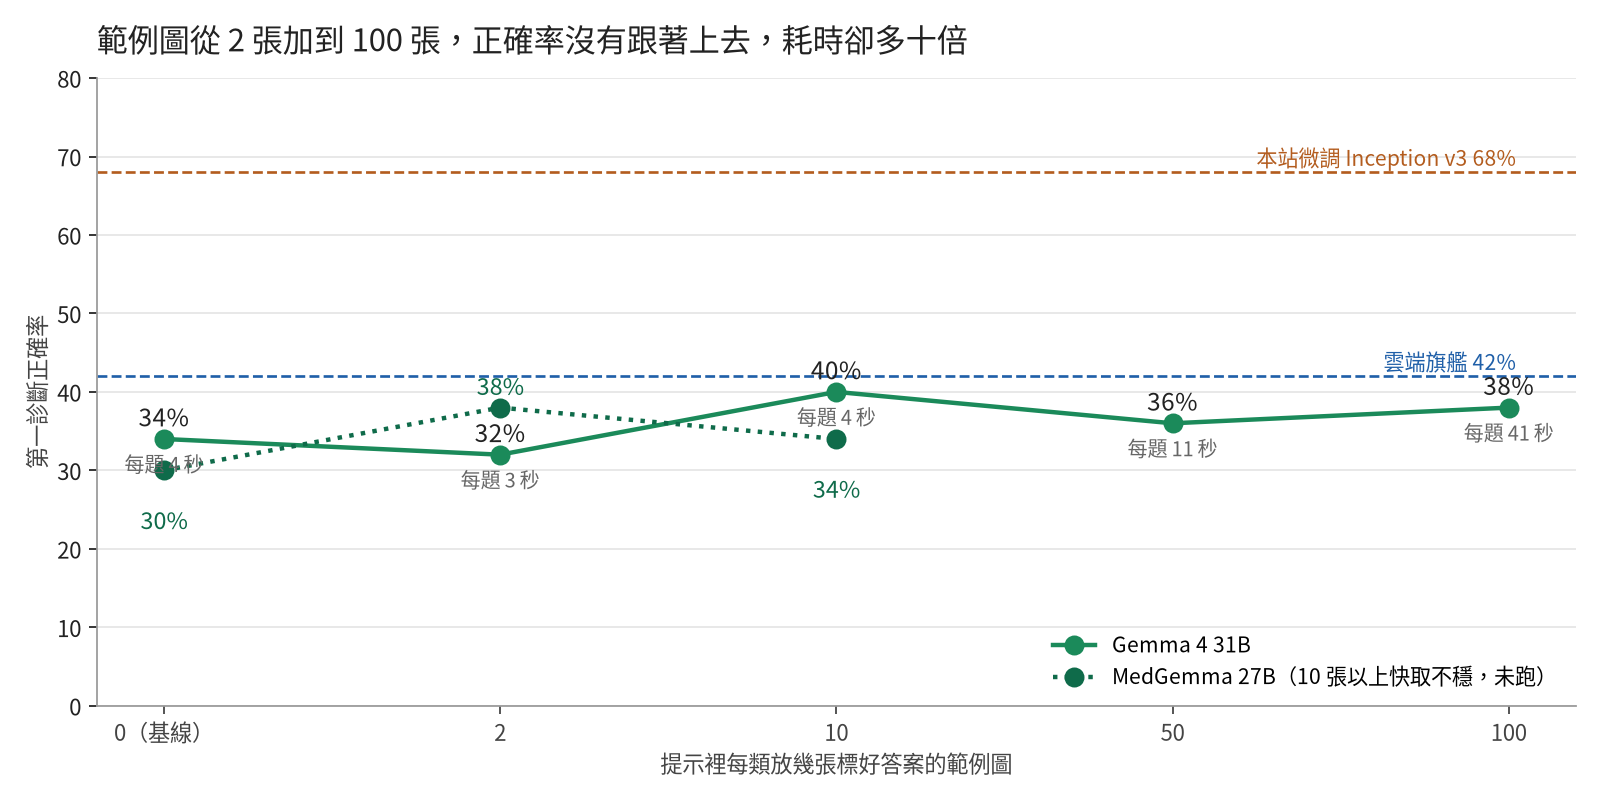
每類 10 張是最好的一級,Gemma 4 31B 從 34% 到 40%,剛好追上雲端兩個旗艦的 42% 附近;再加到 50 張、100 張反而掉回 36% 到 38%,每題耗時卻從 4 秒變 41 秒。100 張那級黑色素瘤只抓到 5 例。原因看每類被判的次數就清楚:範例越多,模型越傾向把答案押在範例裡最像的那幾張,而不是從影像本身學到類別的紋理。提示裡的範例圖是「給它看」,不是「教它學」,看得再多也沒有把權重改掉。
二、同樣的資料拿去微調,CNN 學得快得多
| 模型 | 訓練資料 | 訓練時間 | 正確 | 黑色素瘤抓到(30) |
|---|---|---|---|---|
| Inception v3 | 600 張(舊集) | 32 秒 | 57(28%) | 4 |
| Inception v3 | 6,000 張(舊集) | 3 分鐘 | 71(36%) | 19 |
| Inception v3 | 6,000 張(舊集)、30 輪 | 8 分鐘 | 75(38%) | 20 |
| ConvNeXt-Tiny | 6,000 張(舊集) | 5 分鐘 | 92(46%) | 20 |
| Qwen3-VL-4B LoRA | 600 張(舊集) | 13 分鐘 | 80(40%) | 5 |
| Qwen3-VL-4B LoRA | 6,000 張(舊集) | 94 分鐘 | 64(32%) | 19 |
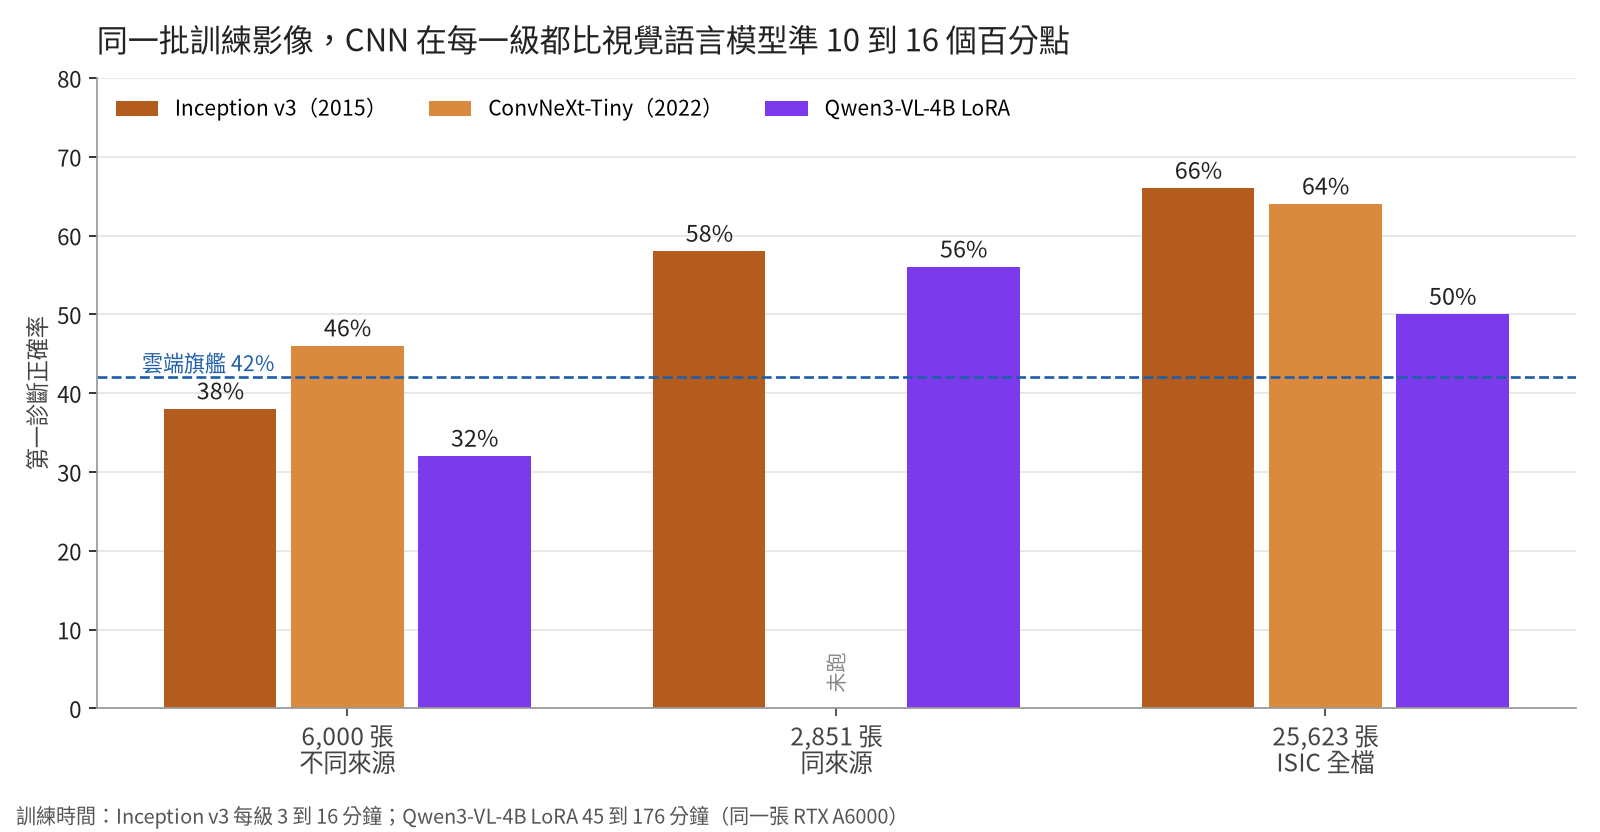
同樣 6,000 張不同來源的影像:Inception v3 三分鐘學到 36%,ConvNeXt-Tiny 五分鐘學到 46%,已經超過雲端旗艦;Qwen3-VL-4B 的 LoRA 跑了 94 分鐘反而從 600 張的 40% 退到 32%,而且幾乎不再判痣,把 100 例可出院的病人留下了 98 例。視覺語言模型的分類能力藏在語言層後面,LoRA 只改動 0.9% 的參數,資料一多就被帶偏;CNN 的最後一層就是這六類的機率,每一張影像都直接改到它。
三、資料來源比數量更決定結果
| 模型 | 訓練資料 | 訓練時間 | 正確 | 黑色素瘤抓到(30) |
|---|---|---|---|---|
| Inception v3 | 6,000 張,不同來源 | 8 分鐘 | 75(38%) | 20 |
| Inception v3 | 2,851 張,同來源(MILK10k) | 4 分鐘 | 115(58%) | 12 |
| Inception v3 只訓最後一層 | 2,851 張,同來源 | 2 分鐘 | 85(42%) | 10 |
| Inception v3 | 6,000 張不同來源+2,851 張同來源 | 11 分鐘 | 137(68%) | 14 |
| Inception v3 | 25,623 張,ISIC 全檔 | 16 分鐘 | 131(66%) | 14 |
| ConvNeXt-Tiny | 25,623 張,ISIC 全檔 | 16 分鐘 | 128(64%) | 7 |
| Qwen3-VL-4B LoRA | 2,851 張,同來源 | 45 分鐘 | 105(52%) | 12 |
| Qwen3-VL-4B LoRA 連視覺編碼器 | 2,851 張,同來源 | 51 分鐘 | 113(56%) | 13 |
| Qwen3-VL-4B LoRA | 25,623 張,ISIC 全檔 | 176 分鐘 | 101(50%) | 9 |
| 作者 Inception v3 | 68,011 張,ISIC 全檔 | 20 分鐘(H100) | 125(62%) | 13 |
這張圖是整篇的重點。
- 同一個 Inception v3,2,851 張同來源的影像得 58%,6,000 張不同來源只有 38%。張數少一半,分數高 20 個百分點。
- 兩批合起來 7,398 張得 68%,是全部實驗的最高分,超過作者 68,011 張的 62%。再把 ISIC 全檔 25,623 張全部倒進去,反而降到 66%;張數多三倍多,沒有換到任何進步,因為多出來的影像是別的醫院、別的相機、別的年代,對這 200 題來說是噪音。
- 視覺語言模型同樣的走勢:同來源 2,851 張 52%(連視覺編碼器一起訓 56%),加到 25,623 張掉到 50%。它和 CNN 的差距在每一級都是 10 到 16 個百分點,而且訓練時間是 CNN 的 10 倍。
- 只訓最後一層的 Inception v3 得 42%,和全層微調差 16 個百分點:對皮膚鏡影像來說,ImageNet 學到的特徵不夠用,要把底層卷積一起重訓。
這裡要先說一個限制:本站 68% 的那組,訓練影像和考題同樣來自 MILK10k。雖然測試病例與同病灶的所有影像都排除在訓練外,它仍然享有「同一家醫院、同一套器材」的優勢,換另一家醫院的影像一定會掉。作者的 62% 是用 ISIC 全檔訓練的,跨來源的能力應該比本站的 68% 好。這兩個數字要放在一起讀,不能單獨拿 68% 當成可用的產品數字。
遇到的問題
1. ISIC 的搜尋 API 預設依建檔時間排序,第一次抓的「6,000 張」幾乎全是 2016 年前後的集子,和 2025 年的 MILK10k 差很多。這個意外反而成了本篇最有用的對照組,但抓資料時一定要看來源分布,不能只看張數。
2. 痣的舊資料多數沒有病理確診(臨床判定即收錄),本站抓同來源那級時改用病理確診優先的查詢;ISIC 全檔那級為了湊數不限確診方式,這也是它表現不如 7,398 張那組的原因之一。
3. MedGemma 27B 的多範例提示快取不穩定,Ollama 每題都重讀 60 張圖,平均 23 秒;50 張以上的級距沒有跑。Gemma 4 31B 的 100 張那級在本站的 2 小時逾時前只跑完 195 例,剩下 5 例用同樣設定補跑。
結論
1. 資料要和題目同一個分布,數量其次。 同來源 2,851 張勝過不同來源 6,000 張,7,398 張勝過 25,623 張,也勝過作者的 68,011 張。上一篇說「定義題目即決定結果」,這篇補上後半句:定義題目包括定義資料來源,訓練影像的相機、標註流程和年代與考題不一致,多幾倍的資料也只是噪音。
2. 小模型加對的資料,勝過大模型加很多提示。 一張 A6000 跑 11 分鐘的 Inception v3 得 68%;Gemma 4 31B 給 100 張範例圖花 41 秒一題只到 38%,雲端旗艦 42%,視覺語言模型微調最好 56%。同樣的資料,放進專門的分類器比放進通用模型有效得多,也便宜得多。
3. 通用模型的位置是分流與說明,不是判讀。 六選一這種封閉分類,視覺語言模型不管是提示還是微調都追不上 CNN;它的強項是讀病歷、解釋結果、處理沒見過的情況。合理的架構是 CNN 判讀、LLM 解釋與補位,而不是二選一。
上一篇:定義題目即決定結果:本站重現皮膚癌 200 例實測說明準確率靠資料量而非架構 用同一批 200 例測六個地端模型與五種提示方法,本篇的基線與評分方式都承接自該篇。
本文不是醫療建議,也不代表任何模型可用於臨床。作者的 CNN 與雲端模型數字引自作者公布,本站未重跑。訓練影像取自 ISIC Archive,授權為 CC-0、CC-BY 與 CC-BY-NC 混合;MILK10k 影像為 CC-BY-NC,著作權屬 MILK study team,本站僅用於非商業的研究重現,影像本身未重製於本文。
來源:佐證 0 筆,另有背景參考 2 筆
背景參考正文沒有引用,只是相關背景,不計入佐證數
- lynchlab.net · A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis(Magnus Lynch,公開測試)
- aiview.tw · 本站上一篇:定義題目即決定結果
這篇對你有用嗎?
留言 0
- 還沒有留言,第一則就是你的。
留言不用登入;名字選填,沒填就顯示「匿名會員」。含連結或疑似廣告的留言會先經編輯確認;檢舉達 3 次的留言會自動隱藏。隱私政策
發現錯誤?
回報會進入待處理清單;核實後更正,並在文中註記更正紀錄。