結論先講
- Handy 與 Hex 是同一類工具:按住快捷鍵說話、放開後文字直接貼進游標所在的欄位,全程在自己電腦上跑,不上雲端。兩者的辨識引擎同源(Hex 用的 transcribe.cpp 就是 Handy 作者寫的),模型檔也從同一個 Hugging Face 帳號下載,所以差別不在「哪個聽得準」,而在模型選單、繁體處理與桌面整合。
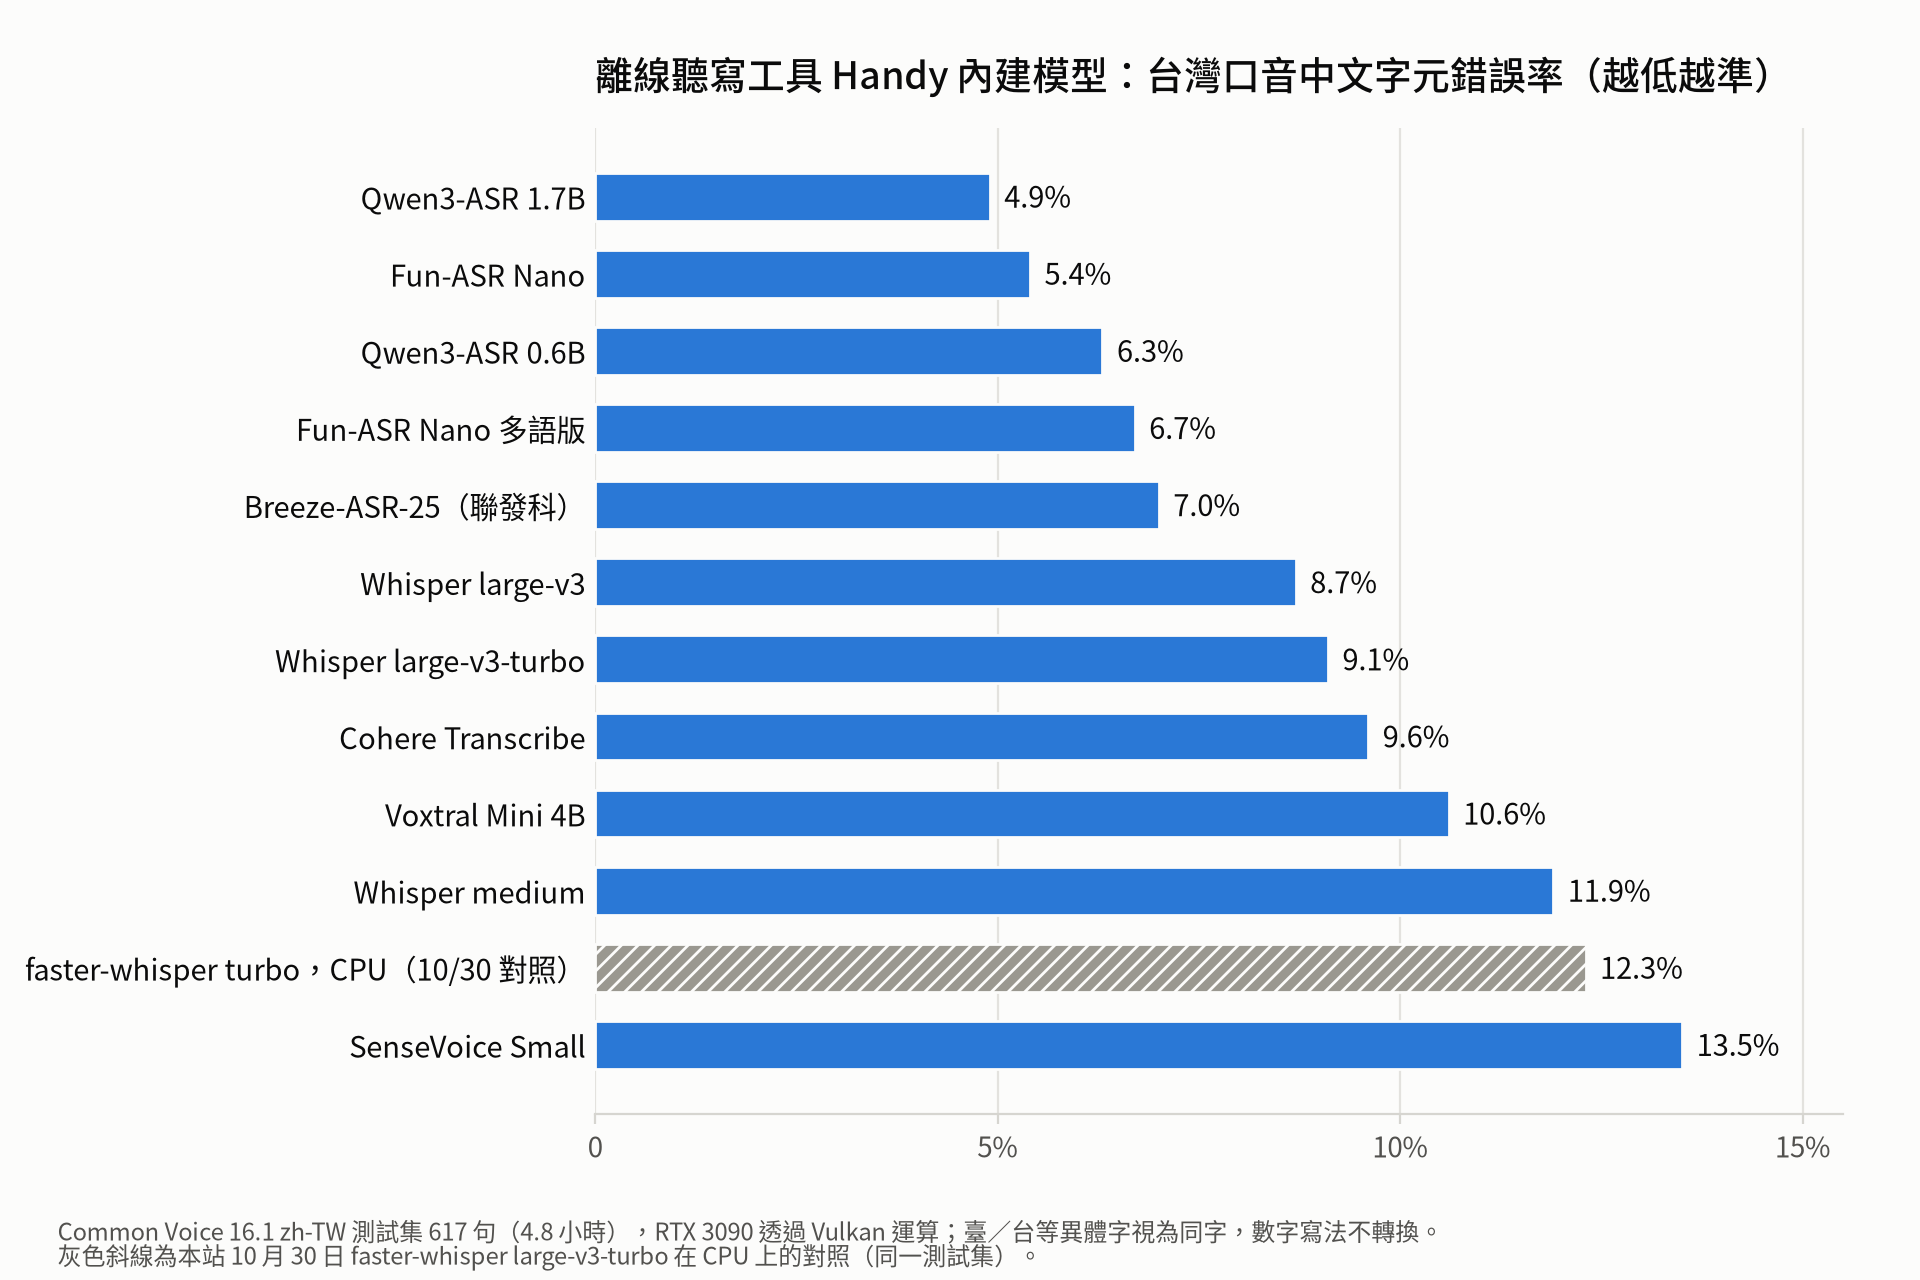
- 同樣 617 句台灣口音中文,兩個工具裡能選的中文模型差距很大:Qwen3-ASR 1.7B 字元錯誤率 4.9%、Fun-ASR Nano 5.4%、Qwen3-ASR 0.6B 6.3%、聯發科 Breeze-ASR-25 7.0%,Whisper large-v3-turbo 9.1%,SenseVoice Small 13.5%。預設清單排最前面的幾個模型沒有一個支援中文。
- 長段落另有陷阱:Fun-ASR 與 Cohere Transcribe 在 248 秒的連續旁白上整段崩掉(重複同一個字或同一句),Qwen3-ASR 也掉到 15% 到 23%;Whisper 系列、Breeze、Voxtral 則維持 10% 上下。想一口氣唸一整段,模型要另外挑。
- Handy 內建簡繁轉換,預設就輸出台灣繁體;Hex 沒有這一層,Whisper 與 Qwen 在 Hex 裡吐出來的是簡體。對台灣使用者,這一點比錯誤率差 1 個百分點更關鍵。
這兩個工具解決什麼問題
想用講的代替打字,現成的選擇多半是把聲音送到雲端(作業系統內建聽寫、各家輸入法的語音功能),或是開一個獨立視窗辨識完再複製貼上。Handy 和 Hex 做的是第三條路:常駐在背景,任何應用程式裡按一組快捷鍵就開始錄音,放開(或再按一次)後文字直接出現在游標處,錄音與辨識都在本機完成。
兩個專案都是 Rust 寫的桌面程式,MIT 授權,支援 Windows、macOS、Linux。Handy(cjpais)2025 年 2 月開始,本站記錄時 36,022 顆星;Hex(anomalyco,也就是 OpenCode 的開發團隊)2026 年 11 月 1 日單日新增 1,329 顆星,累計 3,251 顆,Linux 版還標示 beta。
兩者的辨識核心是同一套:Handy 作者寫的 transcribe.cpp(在 whisper.cpp/ggml 之上支援多種語音模型架構),模型都是量化後的 GGUF 檔,下載來源都是 Hugging Face 上的 handy-computer 帳號。Hex 的程式碼裡直接引用這個函式庫,模型檔名與雜湊值也一致。所以本文把兩個工具放在同一篇:模型層的數字兩邊共用,工具層再分開看。
測試方法
- 測試集:Common Voice 16.1 zh-TW 測試切分(Hugging Face 上 JiHungLin 整理的版本,Apache-2.0),617 段、共 4.8 小時,每段約 27 秒,由多句台灣人朗讀的句子接成,附正確文字。另加本站一段 248 秒的影片旁白(台灣口音 TTS,有逐字稿),看長音訊表現。與 10 月 30 日 Nemotron 對比 Whisper 那篇完全相同。
- 機器:RTX 3090 24 GB 桌機(Ryzen 5 3600、Ubuntu 24.04),兩個工具都透過 Vulkan 用顯示卡運算。
- Handy 0.9.8(2026 年 10 月 3 日的正式版):用它的無頭指令列(
handy -f 檔案.wav --model 模型 --json)逐句餵 16 kHz 單聲道 wav,走的是與桌面版相同的批次辨識路徑,只少了麥克風與靜音裁切。語言設定選中文、簡繁轉換維持預設的台灣繁體、其餘設定全部預設;另跑一組語言維持預設「自動」的對照。模型用 Handy 選單裡的預設量化版本(小模型 Q8_0,較大的模型 Handy 自動選 Q5_K_M)。 - Hex 3.2.0 Linux 版:用它的本機指令(
hex model transcribe --model 模型 --language zh 檔案.wav)跑同一批 wav。Hex 的中文選項只有四個:Whisper large-v3-turbo、Qwen3-ASR 0.6B、SenseVoice Small、Cohere Transcribe。 - 指標:字元錯誤率(CER),去掉標點與空白後計算。參考文字與輸出都先把「臺/台」「著/着」「瞭/了」視為同字,再把兩邊逐字轉成繁體算第二欄,分開「字型差異」與「聽錯」。數字寫法不做轉換:參考文字一律是中文數字(二段一百二十三之四號),輸出寫成 123 就算錯,這對會寫阿拉伯數字的模型不利,下文會標出來。
- 速度:Handy 的 JSON 會分開回報「載入模型」與「辨識」時間,表中「每句辨識秒」是後者;桌面使用時模型常駐在記憶體,使用者感受到的延遲接近這個數字。
- 兩個工具在長時間連續呼叫時都遇到同一種問題:617 句裡會有幾句程序卡住不回應(Handy 跑 Qwen3-ASR 1.7B 時卡在第 380 句超過 10 分鐘,Hex 跑 Whisper 時卡在第 180 句左右),以及程序收尾時 Vulkan 報
vkDestroyFence: Invalid device後當掉但結果已經印出。測試腳本加了逾時與重跑,表中數字都是 617 句全數有結果的版本。
617 句的結果(Handy,模型層)
| 模型(Handy 預設量化) | 參數 | 檔案 | 原樣 CER | 轉繁後 CER | 中位數 | P90 | 幻聽尾句 | 每句辨識秒 | 旁白 248 秒 CER |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-ASR 1.7B(Q5_K_M) | 2.0B | 1.5 GB | 5.0% | 4.9% | 3.6% | 11.4% | 1 | 0.38 | 14.9% |
| Fun-ASR Nano(Q8_0) | 830M | 0.9 GB | 5.5% | 5.4% | 4.2% | 11.9% | 1 | 0.27 | 99%(整段重複同一個字) |
| Qwen3-ASR 0.6B(Q8_0) | 782M | 0.9 GB | 6.4% | 6.3% | 5.0% | 14.0% | 1 | 0.27 | 23.2% |
| Fun-ASR Nano 多語版(Q8_0) | 830M | 0.9 GB | 6.8% | 6.7% | 4.0% | 13.8% | 1 | 0.28 | 99%(同上) |
| Breeze-ASR-25(Q5_K_M) | 1.5B | 1.2 GB | 7.1% | 7.0% | 5.7% | 15.7% | 1 | 0.47 | 10.3% |
| Whisper large-v3(Q5_K_M) | 1.5B | 1.2 GB | 8.8% | 8.7% | 6.5% | 17.2% | 47 | 0.49 | 9.8% |
| Whisper large-v3-turbo(Q8_0) | 809M | 0.9 GB | 9.2% | 9.1% | 6.6% | 18.8% | 8 | 0.24 | 10.9% |
| Whisper large-v3-turbo,語言維持「自動」 | 809M | 0.9 GB | 9.7% | 9.5% | 6.6% | 18.4% | 8 | 0.25 | 10.9% |
| 模型(Handy 預設量化) | 參數 | 檔案 | 原樣 CER | 轉繁後 CER | 中位數 | P90 | 幻聽尾句 | 每句辨識秒 | 旁白 248 秒 CER |
| Cohere Transcribe(Q5_K_M) | 2.0B | 1.8 GB | 9.7% | 9.6% | 7.8% | 19.6% | 1 | 0.29 | 96%(反覆同一句) |
| Voxtral Mini 4B Realtime(Q5_K_M) | 4.4B | 3.3 GB | 10.7% | 10.6% | 6.7% | 23.4% | 1 | 1.63 | 10.4% |
| Whisper medium(Q8_0) | 764M | 0.8 GB | 12.0% | 11.9% | 6.8% | 20.7% | 1 | 0.43 | 11.7% |
| SenseVoice Small(Q8_0) | 234M | 0.25 GB | 13.5% | 13.5% | 8.0% | 30.2% | 1 | 0.21 | 59.0% |
| 對照:faster-whisper turbo,CPU,本站門檻設定(10/30) | 809M | — | 12.6% | 12.3% | 9.4% | 25.9% | 155 | 5.2 | 37.3%(中途轉簡體) |
「幻聽尾句」是輸出結尾多出「請不吝點贊 訂閱」「字幕志願者」這類影片字幕用語的句數,是 Whisper 系列的老毛病。
可以直接讀出來的幾件事:
1. 中文專用或以中文為主要語言訓練的模型,整體贏過通用多語模型一截。前四名(Qwen3-ASR 兩個尺寸、Fun-ASR 兩個版本)都來自阿里系團隊,錯誤率 4.9% 到 6.7%;聯發科 Breeze-ASR-25 7.0%;Whisper 家族最好的 large-v3 是 8.7%。
2. Whisper 在這裡的表現比本站 10 月 30 日用 faster-whisper 跑的 12.3% 好了 3 個百分點,幻聽尾句從 155 句降到 8 句。Handy 餵給模型前會先用 Silero VAD 裁掉靜音,加上 whisper.cpp 與 faster-whisper 的解碼設定不同,看起來比有沒有繁體提示詞更有影響。語言設「自動」而不是中文,錯誤率只差 0.4 個百分點,但有 3 句寫成簡體、2 句整句變成外文。
3. Breeze-ASR-25 的 7.0% 有一部分是數字寫法造成的:它在 122 句裡把數字寫成阿拉伯數字(「二段 123 至 4 號」),參考文字是中文數字,每個數字都算錯;它也完全不加標點。地名是它的強項,「台中市海線中山路、高鐵橋下雲林段道路、南迴鐵路」這一句它與 Fun-ASR 幾乎全對,其他模型把雲林聽成「與寧」「與林」。
4. Qwen3-ASR 1.7B 是唯一每句都加完整標點的模型,中位數 3.6% 表示一半以上的句子幾乎全對;代價是它偶爾會切換到粵語用字,「常常拿著這份文件」被寫成「成日拎住你臺蠻緊」。
5. Whisper 有一種其他模型沒有的錯法:一段 27 秒的音訊只輸出第一個分句就停了(「你那句話什麼意思?」後面六個分句全部消失),617 句裡 P90 比中位數高出 12 個百分點主要來自這類句子。
6. 模型檔大小與準確度沒有對應:3.3 GB 的 Voxtral Mini 4B 是 10.6%,0.9 GB 的 Fun-ASR Nano 是 5.4%;SenseVoice Small 0.25 GB 最小也最差,但辨識一句只要 0.21 秒。
長段落:248 秒旁白與長度門檻
上表最後一欄是整段 248 秒旁白一次餵進去的結果。Handy 說明文件寫長音訊會「在停頓處切段」,但這段 TTS 旁白幾乎沒有長停頓,等於把整段交給模型:
- Fun-ASR 兩個版本輸出變成同一個字重複三百次,Cohere Transcribe 反覆同一個片語,等於整段作廢。
- Qwen3-ASR 0.6B 前半正確、後半漏掉,錯誤率 23%;1.7B 版 15%。
- Whisper 三個版本、Breeze、Voxtral 都在 10% 到 12%,與短句差不多。
為了找出「一次最多能講多久」,把同一段旁白切成 30、60、90、120、180 秒再各跑一次:
| 模型 | 30 秒 | 60 秒 | 90 秒 | 120 秒 | 180 秒 | 248 秒整段 |
|---|---|---|---|---|---|---|
| Breeze-ASR-25 | 完整 | 完整 | 完整 | 完整 | 完整 | CER 10.3% |
| Qwen3-ASR 1.7B | 完整 | 完整 | 完整 | 完整 | 完整 | CER 14.9% |
| Qwen3-ASR 0.6B | 完整 | 完整 | 完整 | 完整 | 完整 | CER 23.2%(後段漏字) |
| SenseVoice Small | 完整 | 完整 | 完整 | 完整(90%) | 只剩 69% | CER 59.0% |
| Fun-ASR Nano | 完整 | 完整 | 85% | 只剩 69% | 崩(同一個字重複 670 次) | CER 99% |
| Cohere Transcribe | 完整 | 崩(只剩 55%) | 崩 | 崩 | 崩 | CER 96% |
「完整」指輸出字數達到該長度預期字數的九成以上且沒有重複迴圈。換句話說:Cohere 一次只能講 30 秒以內;Fun-ASR 60 秒內沒問題,超過 90 秒開始掉字、三分鐘就崩;SenseVoice 撐到兩分鐘;Qwen3-ASR 與 Breeze 四分鐘都還完整,但 Qwen3-ASR 0.6B 到最後一段會漏字。日常聽寫一句話幾秒到幾十秒,六個模型都沒問題;要唸完整段備忘錄才需要挑。
Hex:同樣的模型,不同的結果
Hex 的 Linux 版能選的中文模型只有四個,用同一批 617 句跑,右邊放 Handy 跑同一個模型的數字對照(第四個 Cohere Transcribe 在 Hex 裡每句要重新載入 2.4 GB 模型,跑完後補上):
| 模型 | Hex 原樣 CER | Hex 轉繁後 CER | Hex 寫成簡體 | Handy 轉繁後 CER | Hex 旁白 248 秒(轉繁) | Handy 旁白 |
|---|---|---|---|---|---|---|
| Whisper large-v3-turbo | 23.3% | 9.1% | 310 句 | 9.1% | 11.8% | 10.9% |
| Qwen3-ASR 0.6B | 20.3% | 6.7% | 329 句 | 6.3% | 23.1% | 23.2% |
| SenseVoice Small | 40.5% | 14.0% | 610 句 | 13.5% | 15.3% | 59.0% |
三件事:
1. 把字型差異排除後,Hex 與 Handy 的數字幾乎一樣(9.1% 對 9.1%、6.7% 對 6.3%、14.0% 對 13.5%),證實兩個工具用的是同一個引擎與同樣的模型檔;差的那零點幾個百分點來自 Hex 沒有 Handy 的靜音裁切與後處理。
2. 「原樣」那一欄才是台灣使用者會看到的:Hex 沒有簡繁轉換,Whisper 與 Qwen 一半的句子、SenseVoice 幾乎每一句都寫成簡體,貼進文件要自己再轉一次。Hex 的設定裡找不到任何與中文字型相關的選項。
3. 長音訊的切段兩邊不同:同樣 248 秒旁白,SenseVoice 在 Handy 裡只剩不到一半內容(59%),在 Hex 裡是 15%,Hex 的切段對這類只能吃短音訊的模型比較友善;Whisper 與 Qwen 兩邊接近。
Hex 的每一句都是重新開程序、重新載入模型,所以表中沒有單獨的辨識時間;Whisper 一句約 1 秒、Qwen3-ASR 約 3 秒、SenseVoice 約 2.8 秒,含載入。桌面使用時模型常駐,不會有這段等待。
兩邊各自的錯法
- Whisper(兩個工具都一樣):幻聽尾句、提早停止、把台灣地名寫成同音字。在 Hex 裡還多了一層:沒有簡繁轉換,輸出直接是簡體。
- Qwen3-ASR:少數句子切到粵語;把「AI」聽成「I」(旁白裡「這八成也是 AI 寫的」變成「這八成也是 I 寫的」,0.6B 與 1.7B 都如此)。
- Fun-ASR Nano:短句最穩的之一,但長音訊會崩;不加標點、不寫阿拉伯數字,拿來聽寫要自己補標點。
- Breeze-ASR-25:地名與台灣用語最準,阿拉伯數字、無標點。
- SenseVoice Small:速度最快,但長句會大段漏字,248 秒旁白只剩下不到一半的內容。
- Cohere Transcribe、Voxtral:多語模型,中文不是強項;Voxtral 一句要 1.6 秒,是其他模型的四到六倍。
怎麼用
- 安裝:Handy 從 GitHub Releases 下載對應平台的安裝檔(macOS 也能用 Homebrew、Windows 可用 winget,但這兩個套件不是作者維護)。Hex 從官網下載,Linux 另有一行安裝指令。
- 選模型:兩個工具第一次啟動都會請你挑模型。Handy 的推薦清單前四個(Parakeet、Nemotron Streaming、Canary、Cohere)只有 Cohere 支援中文;要往下捲到 Qwen3-ASR、Fun-ASR、Breeze、Whisper 才是本文測到的那些。Hex 的中文選項只有 Whisper turbo、Qwen3-ASR 0.6B、SenseVoice、Cohere 四個。
- 語言:Handy 的語言預設「自動」,改成中文可以避免偶發的簡體與外文輸出;簡繁轉換在設定裡預設就是台灣繁體(系統語言是繁體中文時)。Hex 用
--language zh或在模型設定裡選語言,但沒有簡繁轉換,要繁體只能選本來就輸出繁體的模型(Breeze 不在它的清單裡)。 - 短句聽寫選 Qwen3-ASR 1.7B 或 Fun-ASR Nano;要一次唸長段落選 Breeze-ASR-25 或 Whisper large-v3-turbo。
- Linux:Handy 在 Wayland 上要另外裝輸入模擬工具(wtype 或 ydotool),Ubuntu 26.04 預設 Wayland 要照專案說明設定;Hex 的 Linux 版目前以 i3/X11 與 wlroots 系列為主,GNOME、KDE 走桌面入口協定貼上。
- 批次用法:Handy 的
-f指令可以在沒有桌面的機器上跑,但它啟動時會向使用者的 D-Bus 發呼叫,沒有桌面會等 25 秒逾時;把環境變數DBUS_SESSION_BUS_ADDRESS設成disabled:就只剩 0.3 秒。Hex 的hex model transcribe沒有這個問題。
用與不用的差別
- 與作業系統內建聽寫比:聲音不出電腦,模型自己挑,台灣口音的錯誤率可以壓到 5% 上下,接近每 20 個字錯 1 個。
- 與打開瀏覽器或獨立程式辨識再貼上比:省掉複製貼上的動作,按鍵、說話、放開,文字就在原本的欄位裡。
- 代價:要有顯示卡或夠快的 CPU(本文每句 27 秒音訊在 RTX 3090 上辨識 0.2 到 0.5 秒),模型檔 0.25 到 3.3 GB;長段落要挑對模型;Linux 桌面環境的相容性仍在補。
限制
- 測試集是朗讀句子接成的 27 秒片段,不是日常口語;真實聽寫有語助詞、停頓與自我修正,各模型的排名可能不同。
- 只測了 Handy 與 Hex 各自預設的量化版本;同一個模型換成 Q8_0 或 F16 可能有差。
- 兩個工具都只在 Linux 上用指令列測,沒有比較 Windows/macOS 的桌面整合與快捷鍵體驗。
- 「每句辨識秒」是 RTX 3090 透過 Vulkan 的數字,內建顯示卡或純 CPU 會慢很多;Voxtral 之外的模型在 CPU 上是否能即時,本文沒有測。
- 數字寫法不做正規化,對 Breeze 與 SenseVoice 不利;標點不計入錯誤。
資料來源
- cjpais/Handy(GitHub)、anomalyco/hex(GitHub)、cjpais/transcribe.cpp(GitHub)
- Hugging Face handy-computer 帳號的 GGUF 模型檔;各模型授權依模型卡:Qwen3-ASR、Breeze-ASR-25、Whisper、Cohere Transcribe、Voxtral 為 Apache-2.0,Fun-ASR 與 SenseVoice 為各自的模型授權
- Common Voice 16.1 zh-TW 測試切分(JiHungLin/common_voice_16_1_zh_TW_pseudo_labelled,Apache-2.0)
- 本站 10 月 30 日〈Nemotron 3.5 Transcribe 對比 Whisper〉的 faster-whisper 基準數據
- 測試腳本與每一句的輸出保存在本站 ops/lab/asr-compare(handy_run.py、hex_run.py、compare_dict.py)