先說清楚這是什麼、不是什麼
10 月 30 日晚上,高雄市長候選人柯志恩與賴瑞隆在民視、中天、公視台語台聯合主辦的電視辯論會交鋒,約一個半小時。這是本站「AI 評時事」的第二場辯論評分,這場其實比隔天(10 月 31 日)的台北場更早舉行,只是我們先做了台北場;方法完全一樣,所以兩場可以對照。
做法:同一份逐字稿、同一張評分表,交給三家公司的模型各打三次分——Anthropic 的 Claude Sonnet 5.5、OpenAI 的 GPT-5.5、Google 的 Gemini 4 Argon。評分表用的是一般辯論比賽的面向,不是政治立場;兩位候選人在送進模型前匿名為「甲」「乙」,而且每次隨機對調,模型不知道誰是誰,也拿不到他們的黨籍、民調或過往形象。所有的提示詞、評分表、九次原始回覆全部公開。
這不是民調,不是支持度,不預測選舉結果。它回答的只有一個問題:單看這一個半小時的辯論內容,依照辯論比賽通用的標準,誰講得比較好。
結果:三家一致的地方,和不一致的地方
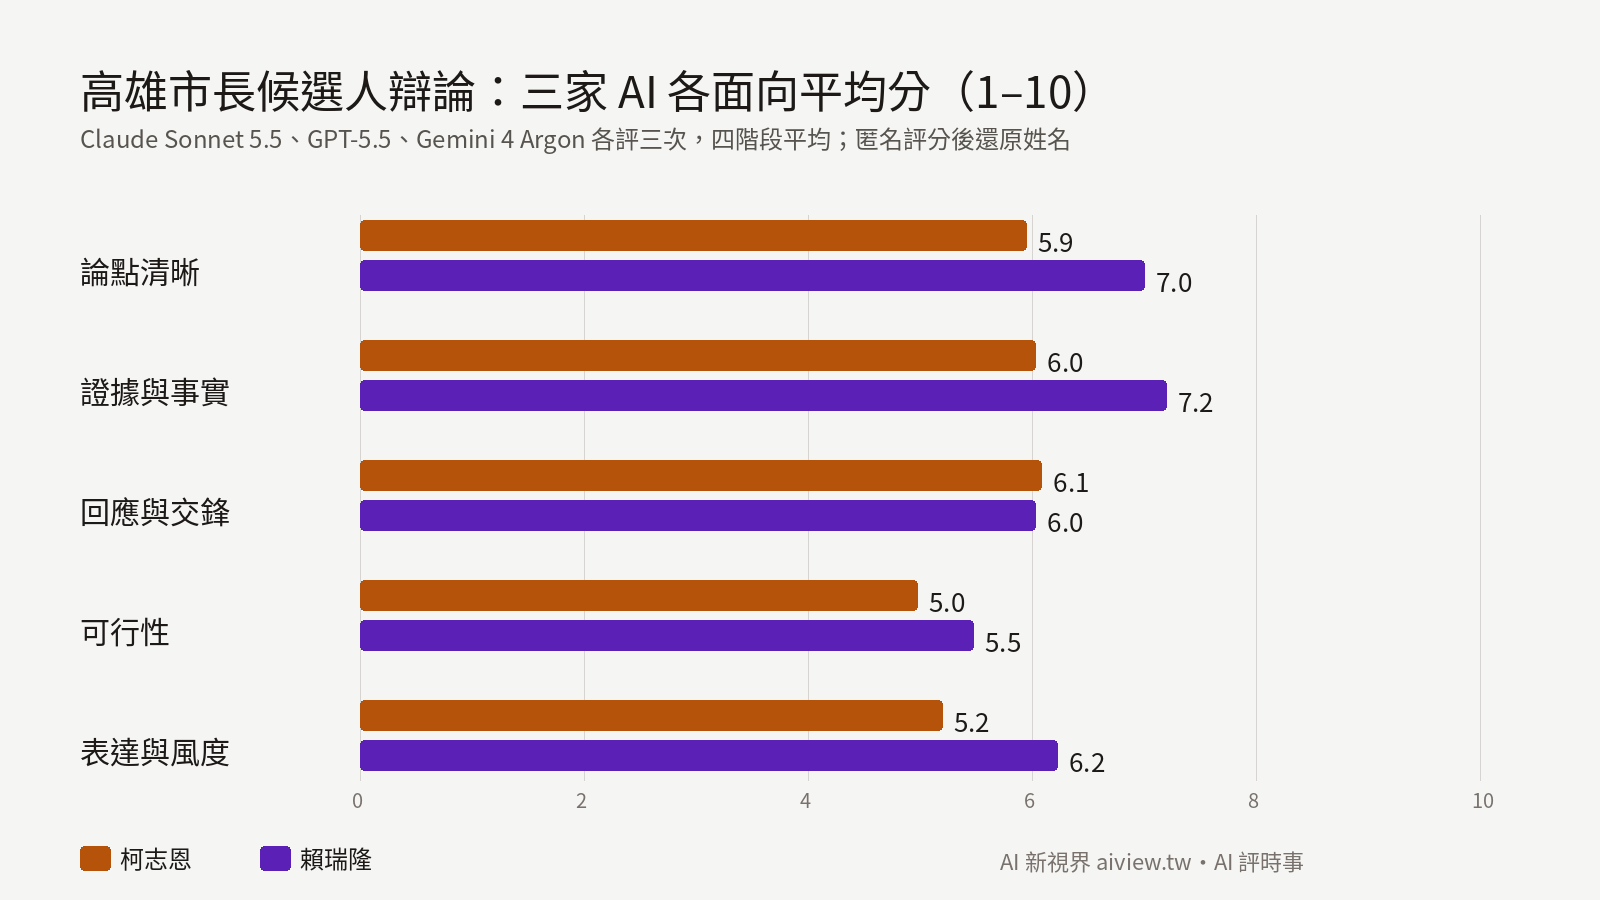
五個面向的分數(四個階段、每家三次的平均;1 到 10 分):
三家雲端平均(四階段、九次)
| 面向 | 柯志恩 | 賴瑞隆 | 領先 |
|---|---|---|---|
| 論點清晰 | 柯 5.9 | 賴 7.0 | 賴 +1.1 |
| 證據與事實 | 柯 6.0 | 賴 7.2 | 賴 +1.2 |
| 回應與交鋒 | 柯 6.1 | 賴 6.0 | 柯 +0.1 |
| 可行性 | 柯 5.0 | 賴 5.5 | 賴 +0.5 |
| 表達與風度 | 柯 5.2 | 賴 6.2 | 賴 +1.0 |
Anthropic/claude-sonnet-5-5
| 面向 | 柯志恩 | 賴瑞隆 | 領先 |
|---|---|---|---|
| 論點清晰 | 柯 5.2 | 賴 6.7 | 賴 +1.4 |
| 證據與事實 | 柯 5.8 | 賴 7.1 | 賴 +1.3 |
| 回應與交鋒 | 柯 5.5 | 賴 6.1 | 賴 +0.6 |
| 可行性 | 柯 4.7 | 賴 5.0 | 賴 +0.3 |
| 表達與風度 | 柯 4.9 | 賴 5.8 | 賴 +0.9 |
OpenAI/gpt-5.5
| 面向 | 柯志恩 | 賴瑞隆 | 領先 |
|---|---|---|---|
| 論點清晰 | 柯 5.5 | 賴 7.0 | 賴 +1.5 |
| 證據與事實 | 柯 5.6 | 賴 7.2 | 賴 +1.7 |
| 回應與交鋒 | 柯 5.5 | 賴 6.1 | 賴 +0.6 |
| 可行性 | 柯 4.4 | 賴 5.1 | 賴 +0.7 |
| 表達與風度 | 柯 4.2 | 賴 5.6 | 賴 +1.4 |
Google/gemini-4-argon
| 面向 | 柯志恩 | 賴瑞隆 | 領先 |
|---|---|---|---|
| 論點清晰 | 柯 7.1 | 賴 7.3 | 賴 +0.2 |
| 證據與事實 | 柯 6.8 | 賴 7.2 | 賴 +0.5 |
| 回應與交鋒 | 柯 7.2 | 賴 5.9 | 柯 +1.3 |
| 可行性 | 柯 5.8 | 賴 6.3 | 賴 +0.5 |
| 表達與風度 | 柯 6.5 | 賴 7.2 | 賴 +0.8 |
Alibaba(地端 Ollama)/qwen3.8:27b-32k(地端參考)
| 面向 | 柯志恩 | 賴瑞隆 | 領先 |
|---|---|---|---|
| 論點清晰 | 柯 5.4 | 賴 7.0 | 賴 +1.6 |
| 證據與事實 | 柯 5.4 | 賴 7.2 | 賴 +1.8 |
| 回應與交鋒 | 柯 5.6 | 賴 6.6 | 賴 +1.0 |
| 可行性 | 柯 4.3 | 賴 5.9 | 賴 +1.6 |
| 表達與風度 | 柯 5.0 | 賴 6.6 | 賴 +1.6 |
Alibaba(地端 llama.cpp)/Qwen3.8-Flash-Next-180B(地端參考)
| 面向 | 柯志恩 | 賴瑞隆 | 領先 |
|---|---|---|---|
| 論點清晰 | 柯 5.4 | 賴 7.4 | 賴 +2.0 |
| 證據與事實 | 柯 5.1 | 賴 7.1 | 賴 +2.0 |
| 回應與交鋒 | 柯 5.0 | 賴 6.5 | 賴 +1.5 |
| 可行性 | 柯 3.9 | 賴 5.6 | 賴 +1.8 |
| 表達與風度 | 柯 4.1 | 賴 6.8 | 賴 +2.6 |
三家模型在方向上大致一致,但一致的程度不如台北場:
- 論點清晰與證據與事實是賴瑞隆分數高出最多的兩項(各 +1.1、+1.2)。三家都提到賴瑞隆全場以財劃法為主軸、數字密集而且反覆:計畫型補助款「從去年的 498 億降到 334 億、明年只剩 210 億」、高雄與台北分配款差距「從 194 億擴大到 390 億、明年 431 億」,以及賴瑞隆列出的建設經費(大林蒲遷村 800 億、紅線南延 533 億增至 800 億、小港機場新航廈 880 億)。三家選的「最有力的一段」有六次是這些數字。
- 表達與風度賴瑞隆高出 1.0 分。三家選出的柯志恩「最弱的一段」集中在兩句:「你就是一個新潮流的寶寶」(GPT-5.5 兩次)和結論裡「新潮流就是完全看不起我們高雄,派個二軍」(Gemini 三次),另外是交叉詰問開頭「你收了詐騙集團的錢又收了光電業者三百萬」(Claude、GPT-5.5 各一次)。賴瑞隆的最弱段落也集中:「不要再用這種抹黑攻擊的手段,這個很像國民黨慣用的一些手法」被 Claude 三次、Gemini 一次選中,三家都提到賴瑞隆「造謠抹黑」「重北輕南」重複太多次。
- 回應與交鋒是唯一柯志恩分數較高的面向,但只高 0.1,而且三家意見相反:Gemini 給柯志恩高 1.3 分,理由是「正面回應提問、攻防反應敏捷、能拆解對手數字」;Claude 和 GPT-5.5 反而各給賴瑞隆高 0.6 分,理由是柯志恩「常答非所問」「對財劃法首都 3% 的核心質疑只重複否認」。同一份逐字稿,三家對「有沒有回答問題」的判斷不同。
- 可行性兩人都低(5.0 對 5.5),是全場最低的面向。三家對柯志恩的評語都是「新設機構與大型建設缺乏財源與權責」「結構鬆散、可行性不足」,對賴瑞隆則是「政策預算與時程不足」「多以延續現任市府帶過」。
總分與判定:
| 評審(公司/模型) | 柯志恩 總分 | 賴瑞隆 總分 | 判定 |
|---|---|---|---|
| Anthropic/claude-sonnet-5-5 | 柯 5.0(±0.0,3 次) | 賴 6.3(±0.5,3 次) | 賴瑞隆 3 次 |
| OpenAI/gpt-5.5 | 柯 5.0(±0.0,3 次) | 賴 6.7(±0.5,3 次) | 賴瑞隆 3 次 |
| Google/gemini-4-argon | 柯 7.1(±0.2,3 次) | 賴 7.1(±0.1,3 次) | 柯志恩 1 次、平手 2 次 |
| Alibaba(地端 Ollama)/qwen3.8:27b-32k(地端參考,不計入平均) | 柯 5.3(±0.5,3 次) | 賴 6.7(±0.5,3 次) | 賴瑞隆 2 次、平手 1 次 |
| Alibaba(地端 llama.cpp)/Qwen3.8-Flash-Next-180B(地端參考,不計入平均) | 柯 4.5(±0.5,2 次) | 賴 7.0(±0.0,2 次) | 賴瑞隆 2 次 |
| 三家雲端平均 | 柯 5.7(±1.0,9 次) | 賴 6.7(±0.5,9 次) |
三家的判定不像台北場那樣一致。Claude Sonnet 5.5 和 GPT-5.5 三次都判賴瑞隆勝,而且給柯志恩的總分三次都是 5 分,是兩場辯論四位候選人裡最低的;Gemini 4 Argon 給兩人都是 7 分上下,兩次平手、一次柯志恩以 7.4 對 7.2 小勝。平均下來是賴瑞隆 6.7 對柯志恩 5.7,但柯志恩的標準差 1.0 比賴瑞隆的 0.5 大一倍,意思是三家對柯志恩的看法分歧比對賴瑞隆大。
各階段:
申論
| 面向 | 柯志恩 | 賴瑞隆 | 領先 |
|---|---|---|---|
| 論點清晰 | 柯 6.4 | 賴 7.7 | 賴 +1.2 |
| 證據與事實 | 柯 6.3 | 賴 8.0 | 賴 +1.7 |
| 回應與交鋒 | 柯 5.4 | 賴 6.7 | 賴 +1.2 |
| 可行性 | 柯 5.4 | 賴 6.3 | 賴 +0.9 |
| 表達與風度 | 柯 6.3 | 賴 6.9 | 賴 +0.6 |
媒體提問
| 面向 | 柯志恩 | 賴瑞隆 | 領先 |
|---|---|---|---|
| 論點清晰 | 柯 6.0 | 賴 6.4 | 賴 +0.4 |
| 證據與事實 | 柯 6.1 | 賴 6.3 | 賴 +0.2 |
| 回應與交鋒 | 柯 6.3 | 賴 5.3 | 柯 +1.0 |
| 可行性 | 柯 5.3 | 賴 5.3 | 持平 |
| 表達與風度 | 柯 5.4 | 賴 6.3 | 賴 +0.9 |
交叉詰問
| 面向 | 柯志恩 | 賴瑞隆 | 領先 |
|---|---|---|---|
| 論點清晰 | 柯 5.7 | 賴 6.3 | 賴 +0.7 |
| 證據與事實 | 柯 5.7 | 賴 6.7 | 賴 +1.0 |
| 回應與交鋒 | 柯 5.8 | 賴 5.6 | 柯 +0.2 |
| 可行性 | 柯 4.6 | 賴 4.6 | 持平 |
| 表達與風度 | 柯 4.3 | 賴 5.1 | 賴 +0.8 |
結論
| 面向 | 柯志恩 | 賴瑞隆 | 領先 |
|---|---|---|---|
| 論點清晰 | 柯 5.7 | 賴 7.6 | 賴 +1.9 |
| 證據與事實 | 柯 6.0 | 賴 7.8 | 賴 +1.8 |
| 回應與交鋒 | 柯 6.8 | 賴 6.6 | 柯 +0.2 |
| 可行性 | 柯 4.6 | 賴 5.7 | 賴 +1.1 |
| 表達與風度 | 柯 4.7 | 賴 6.6 | 賴 +1.9 |
階段的樣子很清楚:申論與結論是賴瑞隆的場子,五個面向全部高出,結論階段的論點清晰與表達與風度各高出 1.9 分、證據高出 1.8 分——三家都提到賴瑞隆結辯「結構完整、數字密集、感性收尾」,而柯志恩放掉講稿改為回應對手,被三家評為「鬆散」「標籤化」。媒體提問是柯志恩唯一在回應與交鋒上明顯較高的階段(6.3 對 5.3),三家都提到賴瑞隆在這一階段「多次迴避核心問題」「重複既有稿件」。交叉詰問兩人都掉到最低:可行性同為 4.6,柯志恩的表達與風度 4.3 是全場最低的一格,賴瑞隆的回應與交鋒 5.6 也是賴瑞隆的最低——這個階段兩人都在攻擊而不是回答。
評審的話(匿名評分後還原姓名,節錄):
- Claude:「願景與換黨輪替主軸明確,機場、基金、辦公室等構想有提出,也有統籌款增加的數字回應。但常答非所問,對財劃法、首都 3% 的核心質疑只重複否認,詰問時指控缺乏聚焦,表達鬆散。」/「全程以財劃法三不公為主軸,數字具體,政見分三項易複述,也持續追打對方立場。缺點是過度重複『造謠抹黑』『重北輕南』,對派系與政治獻金質疑多以辯解帶過,政策預算與時程不足。」
- GPT-5.5:「攻防積極且有部分在地議題,但結構鬆散、可行性不足,人身與派系攻擊過多。」/「政策與數字較完整,結構清楚;但多次貼標籤、部分問題未正面回答。」
- Gemini:「正面回應提問,攻防反應敏捷,能具體點出市政痛點與對手矛盾;惟部分新設機構與大型建設缺乏具體財源與權責規劃,偶有情緒化標籤。」/「政策架構完整,引用大量具體預算數據展現市政熟稔度,結辯感性有力;但在提問與詰問階段多次迴避核心問題,重複陷入單一法案攻防。」
費用:
| 評審 | 次數 | 輸入 token | 輸出 token | 秒數合計 | 費用(美元) |
|---|---|---|---|---|---|
| Anthropic/claude-sonnet-5-5 | 3 | 77,637 | 2,290 | 19 | 0.267 |
| OpenAI/gpt-5.5 | 3 | 61,650 | 4,188 | 80 | 0.434 |
| Google/gemini-4-argon | 3 | 44,330 | 1,401 | 26 | 0.103 |
| Alibaba(地端 Ollama)/qwen3.8:27b-32k | 3 | 40,551 | 14,977 | 399 | 0.000 |
| Alibaba(地端 llama.cpp)/Qwen3.8-Flash-Next-180B | 2 | 27,110 | 11,352 | 459 | 0.000 |
| 切段標記/claude-sonnet-5-5 | 1 | 53,260 | 3,867 | — | 0.218 |
| 合計 | 1.022 |
地端參考組:兩個開源 Qwen 的看法
三家雲端之外,我們也讓本站自己機器上的兩個開源模型用同一套提示評分,當作「如果不花錢、不把逐字稿送出去,會得到什麼」的參考,不計入三家的平均:
- Qwen3.8-Flash-Next-180B(阿里巴巴開源,本站 GB10 主機上以 llama.cpp 執行,也是本站產線的撰稿模型):三次裡兩次成功、一次兩回都輸出壞掉的 JSON;兩次都判賴瑞隆勝,總分 7 對 4 與 7 對 5。評語:「論點有情感與部分數據,但政策細節不足,交鋒多情緒攻擊,結論散亂」/「結構清楚、數據與案例較具體,政策方向明確且交鋒較能反駁,惟部分指控與延續性仍待細化」。
- Qwen3.8 27B(同系列小模型,本站 RTX A6000 上以 Ollama 執行):兩次判賴瑞隆勝(7 對 5)、一次平手(6 對 6)。平手那次的評語和 Gemini 很像:「個人敘事與情感連結較強,天坑與派系追問有鋒芒,但政策細節與預算時程較空泛」/「政策框架與數據引用較扎實,但語氣過於攻擊性,『造謠抹黑』重複八次以上,部分回答迴避提問核心」。
兩個地端模型的方向和 Claude、GPT-5.5 一致,不像 Gemini;給柯志恩的分數也落在 Claude 與 GPT-5.5 那一側。穩定度和上一場相同——180B 三次有一次格式失敗,27B 每次要兩分多鐘,三家雲端一次 6 到 36 秒。地端模型的費用是 0,三家雲端加切段合計 1.02 美元,比台北場的 1.20 美元少,因為這一場的逐字稿短了四成。
從選舉的角度看這些分數
分數本身不會決定選舉,但它把兩個人在這一個半小時裡端出來的東西拆開了,拆開之後能看到幾件和選戰有關的事。
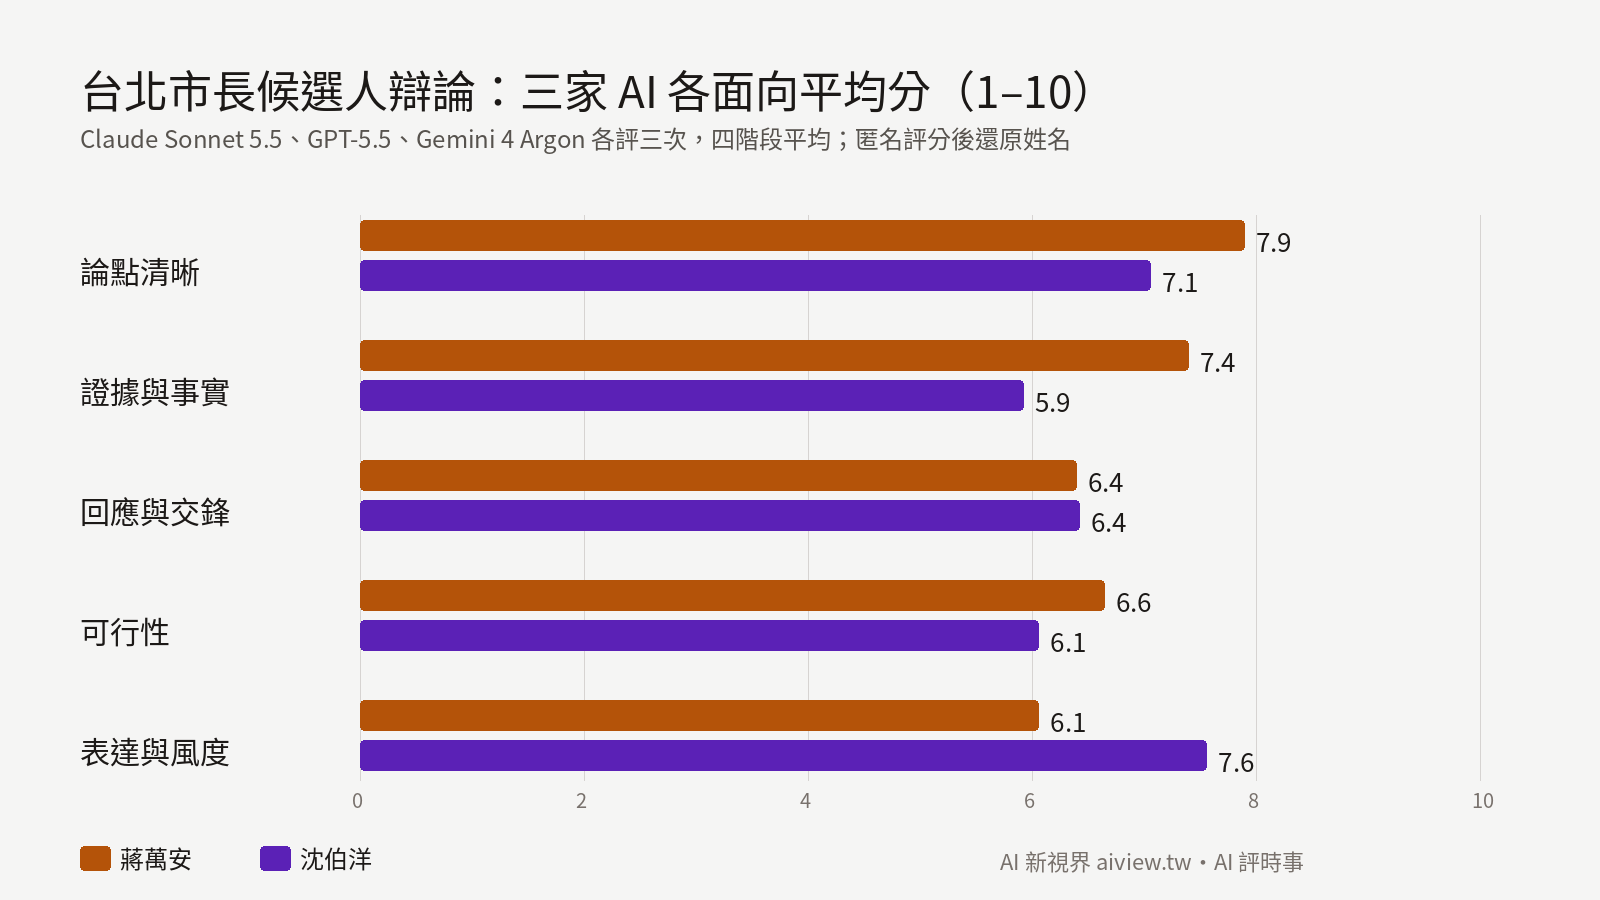
賴瑞隆打的是「延續+財劃法」牌,三家模型在證據項都買單。 賴瑞隆的策略很單一:把財劃法的分配數字講到每個人都記得,再把過去四任市長的建設排成接力棒,自稱「關鍵第四棒」。三家選賴瑞隆「最有力的一段」幾乎全是財劃法的數字,證據與事實在申論 8.0、結論 7.8,和台北場蔣萬安申論的 8.0 並列兩場最高。對一個執政黨的接棒者,這是最自然的訴求:政績是現成的,對手在立法院的表決紀錄也是現成的。這一塊的目標選民是對現任市府滿意、擔心換人換掉建設的人,辯論替賴瑞隆鞏固了這群人。
但單一主軸的代價也是三家一致的。 三家都用了「重複」這個詞:「造謠抹黑」「重北輕南」「心中只有黨意」反覆出現,交叉詰問被問到政治獻金、用人、派系時以「抹黑」帶過而不是正面回答,媒體提問「重複既有稿件」。回應與交鋒 6.0 是賴瑞隆五個面向裡最低的,媒體提問階段只有 5.3。對賴瑞隆來說,下一場的題目是:財劃法可以講,但被問到自己的事情時要先回答再反擊,否則在中間選民眼裡「迴避」會抵銷「數字多」的好處。
柯志恩打的是「換黨輪替+監督」牌,三家都看見了這套攻擊的力道,但只有 Gemini 給分。 柯志恩交叉詰問的選題——政治獻金、後援會人選、天坑、6000 億重複計算——Gemini 評為「能具體點出市政痛點與對手矛盾」,Claude 也承認柯志恩「善於抓住對手的弱點」。問題在於同一批段落被三家列為「最弱」:「新潮流的寶寶」「派個二軍」「收了詐騙集團的錢」。對基本盤這些話有感,對柯志恩這場明顯要爭取的「對市府不滿但不一定投國民黨」的選民是風險——柯志恩的政策牌(反霸凌辦公室、演唱會經濟落地、AI 算力與市政專區)三家都提到了,但也都說「缺乏財源、權責、時程」,可行性 5.0 是柯志恩最低的面向。
柯志恩放掉講稿的結論是整場最大的分歧點。 柯志恩結辯開頭說「我決定放掉我所有準備的講稿,好好來回應賴瑞隆」,三家對這個決定的評價一致是負面的:結論階段柯志恩的論點清晰 5.7、表達與風度 4.7,賴瑞隆是 7.6 和 6.6。即興回應在交鋒項有一點分數(6.8 對 6.6),但失去的是結構和收尾。對選戰的意義是:結辯是觀眾記憶最深的十分鐘,柯志恩把它用在攻擊而不是總結自己要做什麼。
三家的分歧比台北場大,這本身是訊息。 Claude 和 GPT-5.5 給柯志恩的總分是 5,判賴瑞隆三次全勝;Gemini 給兩人都是 7、判平手兩次。把三家放在一起看,這是一場「一方用數字和結構穩穩守住、另一方靠攻擊製造了交鋒但沒有把攻擊轉成自己的政策」的辯論。對選情的意義是:對已經有立場的人,這場辯論各自強化;對還在看「換人會不會更好」的人,柯志恩提供了換的理由,但沒有提供換了之後的具體圖像,而這正是柯志恩下一場要補的。
這些是從分數和評語推出來的觀察,不是預測。選舉還有四週,兩位都還有場合可以補短板;本站會用同一套方法評下一場。
和台北場對照
兩場的主辦單位、提問人、題目都不同,不能拿四位候選人互比;能比的是「同一套評分表看到的樣子」:
- 分數整體比台北場低。 台北場三家平均 7.4 對 6.7,高雄場 6.7 對 5.7;台北場的最低面向是沈伯洋的證據 5.9,高雄場兩人的可行性都在 5.5 以下。三家的評語差別也在這裡:台北場的評語多是「具體數字」「有步驟」,高雄場多是「重複」「鬆散」「缺乏財源」。
- 三家的一致性比台北場低。 台北場三家都判蔣萬安勝或平手、沒有相反結論;高雄場 Claude 與 GPT-5.5 判賴瑞隆三勝,Gemini 判平手兩次、柯志恩一次,而且在回應與交鋒這一項方向相反。
- Claude 的尺還是最嚴,Gemini 最寬。 兩場都是 Claude 給分最低、Gemini 最高;高雄場 Gemini 給兩人都是 7 分上下,和另外兩家差到 2 分。讀這類分數時,看三家的方向比看絕對值可靠。
- 交叉詰問都是分數最低的階段。 兩場的交叉詰問都出現全場最低的表達與風度格(台北蔣萬安 5.1、高雄柯志恩 4.3);兩場都是提問的一方把時間用在貼標籤而不是追問,被三家扣分。
- 結論階段的走向相反。 台北場結論兩人的證據與可行性都掉到 5 分以下;高雄場賴瑞隆的結論反而是賴瑞隆全場最高的階段(證據 7.8),柯志恩的結論則是柯志恩自己最低的。
完整提示詞
評分用的系統提示(三家一字不差,和台北場相同,只有階段順序依這一場改為「申論、媒體提問、交叉詰問、結論」):
你是辯論比賽的評審。下面是一場市長候選人電視辯論的逐字稿(語音辨識,可能有錯字),兩位候選人已匿名為「甲」「乙」。
請只根據逐字稿內容評分,不要猜測他們是誰,也不要使用你對任何政治人物的既有印象或立場。評分面向(每項 1 到 10 分,10 最好):
- clarity 論點清晰:主張是否明確、有結構、聽眾能複述。
- evidence 證據與事實:有沒有具體數字、來源、案例;引用是否具體(不要求你查證真偽,但空泛口號要扣分)。
- engagement 回應與交鋒:有沒有正面回答對方與提問人的問題,還是問 A 答 B;反駁是否針對對方論點。
- feasibility 可行性:政策有沒有說怎麼做、預算、時程、權責;只喊目標不講方法要扣分。
- delivery 表達與風度:語言是否清楚,有無人身攻擊、貼標籤、搶話或違規。
每個階段(申論、媒體提問、交叉詰問、結論)分開打,再給整場總分(1–10,不是平均,是你的整體判斷)與 80 字內的理由,並各給一句「最有力的一段」與「最弱的一段」(引用逐字稿原句)。
輸出 JSON:
{"phases":{"申論":{"甲":{"clarity":n,"evidence":n,"engagement":n,"feasibility":n,"delivery":n},"乙":{...}}, ...},
 "overall":{"甲":{"score":n,"reason":"...","best":"...","worst":"..."},"乙":{...}},
 "winner":"甲"|"乙"|"平手"}
只輸出 JSON。
使用者訊息只有一行開頭「逐字稿(兩位候選人匿名為甲、乙):」,後面接整份切好段的逐字稿,格式是:
## 階段:申論
主持人:……
甲:……
乙:……
## 階段:媒體提問
……
送進模型前,以下字串一律替換成「甲」或「乙」(含語音辨識的錯字變體,稱謂「委員」「老師」保留):
柯志恩:柯[志智治哲真正][恩仁]|柯智仁|柯政委|柯(?=委員|候選人|先生|市長|老師|教授)
賴瑞隆:賴[瑞日睿][隆龍容榮園文]|賴(?=委員|候選人|先生|市長)
切段用的系統提示(只給 Claude,切完三家共用):
你拿到的是一場高雄市長候選人電視辯論的語音辨識逐字稿,每行開頭是秒數。請標出「發言人或階段改變」的時間點。
階段只有四種:申論、媒體提問、交叉詰問、結論。發言人只有:主持人、提問人、柯志恩、賴瑞隆。
判斷依據是主持人的口令(例如「請○○候選人進行申論」「接下來交叉詰問」「請媒體提問」「最後結論」)、計時鈴聲前後的轉換,以及上下文(候選人互相稱呼對方、自稱等)。這一場的順序是申論、媒體提問(兩位提問人各兩題)、交叉詰問(四題,詰問一分鐘、回答三分鐘)、結論。語音辨識常把「申論」寫成「聲論」、「交叉詰問」寫成「交互結問」或「交叉結問」、「柯志恩」寫成「柯智恩」、「賴瑞隆」寫成「賴日龍/賴日容」。辯論正式開始前(主持人宣布「辯論會正式開始」之前)的候選人聯訪、流程說明,以及結束後的記者會都不是辯論內容,phase 寫「其他」。
不要重抄逐字稿。只輸出每一次換人或換階段的那一行的秒數,以及從那一刻起的 phase 與 speaker。
輸出 JSON:{"marks":[{"start": 秒數(整數), "phase": "...", "speaker": "..."}, ...]},依時間排序,第一筆從 0 秒開始(開場是主持人、階段寫「申論」前的開場也算「申論」;辯論前後的聯訪、廣告不是辯論內容,phase 寫「其他」)。只輸出 JSON。
API 參數:Claude max_tokens 8000、其餘預設;GPT-5.5 預設;Gemini temperature 0.3、要求 JSON 輸出;沒有開啟搜尋或任何工具。每家各跑三次,第一與第三次「甲」是柯志恩,第二次對調。
怎麼做的
逐字稿。 來源是主辦單位民視在 YouTube 上的官方直播存檔(1 小時 57 分鐘,含辯論前後的聯訪),本站用 Whisper large-v3-turbo 轉成文字,再由模型依主持人的口令切成四個階段、標上發言人;辯論前後的聯訪不送評。語音辨識有錯字,我們不修,三家模型拿到的是同一份。
匿名與對調。 送進模型前,「柯志恩」一律換成「甲」或「乙」,「賴瑞隆」換成另一個,連候選人互相稱呼對方的名字也換掉;每一次評分隨機決定誰是甲,三次裡至少對調一次,用來抵銷模型對「甲」或「乙」這個位置本身可能有的偏好。
評分表。 四個階段(申論、媒體提問、交叉詰問、結論)各自打分,每階段五個面向,各 1 到 10 分:
| 面向 | 看什麼 |
|---|---|
| 論點清晰 | 主張明確、有結構、聽眾能複述 |
| 證據與事實 | 有具體數字、來源、案例;空泛口號扣分(不要求模型查證真偽) |
| 回應與交鋒 | 正面回答對方與提問人,還是問 A 答 B;反駁有沒有針對對方論點 |
| 可行性 | 政策有沒有說怎麼做、預算、時程、權責;只喊目標不講方法扣分 |
| 表達與風度 | 語言清楚,有無人身攻擊、貼標籤、搶話或違規 |
最後再給整場總分(1 到 10,是整體判斷、不是平均)、80 字理由、各引一句「最有力的一段」與「最弱的一段」,以及勝負判定。
模型與次數。 三家各跑三次,共九次;表格給平均與標準差,標準差大代表同一個模型自己也不太確定。模型版本:claude-sonnet-5-5、gpt-5.5、gemini-4-argon,都用各家 API 的預設設定,沒有開搜尋、沒有給任何背景資料。
公開什麼。 評分程式、提示詞、逐字稿切段結果、九次原始 JSON 回覆都放在本站程式庫 ops/lab/debate;文章裡的每個數字都能回溯到那裡。
限制
- 語音辨識的錯字會影響「證據與事實」那一項:數字聽錯了,模型就會以為候選人講錯。這一場的語音辨識錯字比台北場多(人名、地名、法案名都有),我們抽查過幾段,整體可讀,但這是系統性的誤差來源。本文引用的段落已依多家報導把人名與用語校正回原話(「大林浦千春」→大林蒲遷村、「紅線南岩」→紅線南延、「林大華」→林岱樺、「鄭立文、傅崑奇」→鄭麗文、傅崐萁、「縱北侵南」→重北輕南、「黨議」→黨意、「避重九卿」→避重就輕、「205 冰工廠」→205 兵工廠、「燕朝的勒斯山」→燕巢垃圾山),送給模型評分的逐字稿則維持辨識原樣,沒有改。
- 模型只看文字,看不到表情、語氣、停頓;「表達與風度」只能從用字判斷。
- 匿名擋得住名字,擋不住內容:候選人談到自己的立委任內成績、所屬政黨或對方的黨時,模型可能猜得出誰是誰。我們沒有辦法完全排除這一層。
- 三家模型都是美國公司的產品,訓練資料裡對台灣政治的理解深淺不一;它們一致的地方比較可信,分歧的地方就是分歧。
- 兩場辯論的主辦單位、提問人、題目都不同,分數只能在同一場內比較兩位候選人;跨場比較只看「模型打分的樣子」,不比較四位候選人的高低。