全球動態1 個來源10/29 上午12:23

圖片來源:原出版方的分享預覽圖,著作權屬原出版方
NVIDIA 發布 Nemotron 3.5 Transcribe 與 Granary v2 多語轉錄工具
NVIDIA 推出開源權重模型 Nemotron 3.5 Transcribe,整合轉錄、說話者標註與翻譯,並發布 Granary v2 資料管線以支援領域適配。
程式自動生成(Qwen3.8-Flash-Next-180B),未經人工審閱。每段附來源,門檻檢查通過後自動上線。
圖片來源:原出版方的分享預覽圖,著作權屬原出版方
NVIDIA 推出開源權重模型 Nemotron 3.5 Transcribe,整合轉錄、說話者標註與翻譯,並發布 Granary v2 資料管線以支援領域適配。
程式自動生成(Qwen3.8-Flash-Next-180B),未經人工審閱。每段附來源,門檻檢查通過後自動上線。

NVIDIA 發布開源 Kubernetes 運算子 gpu-fractioning,搭配 CUDA 13.4 的新記憶體強制功能,讓多個工作負載能安全共享單一 GPU 並嚴格限制記憶體使用量。
Meta 計畫發行股票籌資,支應資料中心與 AI 相關基礎設施支出,另規劃最高 600 億美元的後續發行。

NVIDIA 針對 Inclusion AI 的 Ling-3.0-flash 模型,在 DGX Spark 硬體上提出 Humming MoE 核心、Online FP8 LM head 量化與 MTP 投機解碼三種優化手段。實測顯示,三者結合可將解碼吞吐量提升 42.5%,平均延遲降低 24.5%,且準確率幾乎無損。
雙方將深化 Muse 系列模型的推理與訓練最佳化,Meta 計畫擴大部署 Vera Rubin 與 Vera CPU,NVIDIA 同時投資 Meta 30 億美元。
NVIDIA 於 GTC Berlin 宣布,T-Mobile 完成商用網路 AI-RAN 通話,BT、Deutsche Telekom、Elisa 展開試點,並推出 MGX 2U 與 MGX 4U 兩款 ARC 配置。

NVIDIA 發布 Minerva 平台,透過整合全堆疊遙測資料與 AI 代理,解決 AI 工廠中難以偵測的灰色故障,將跨團隊排障時間從數小時縮短至數分鐘。
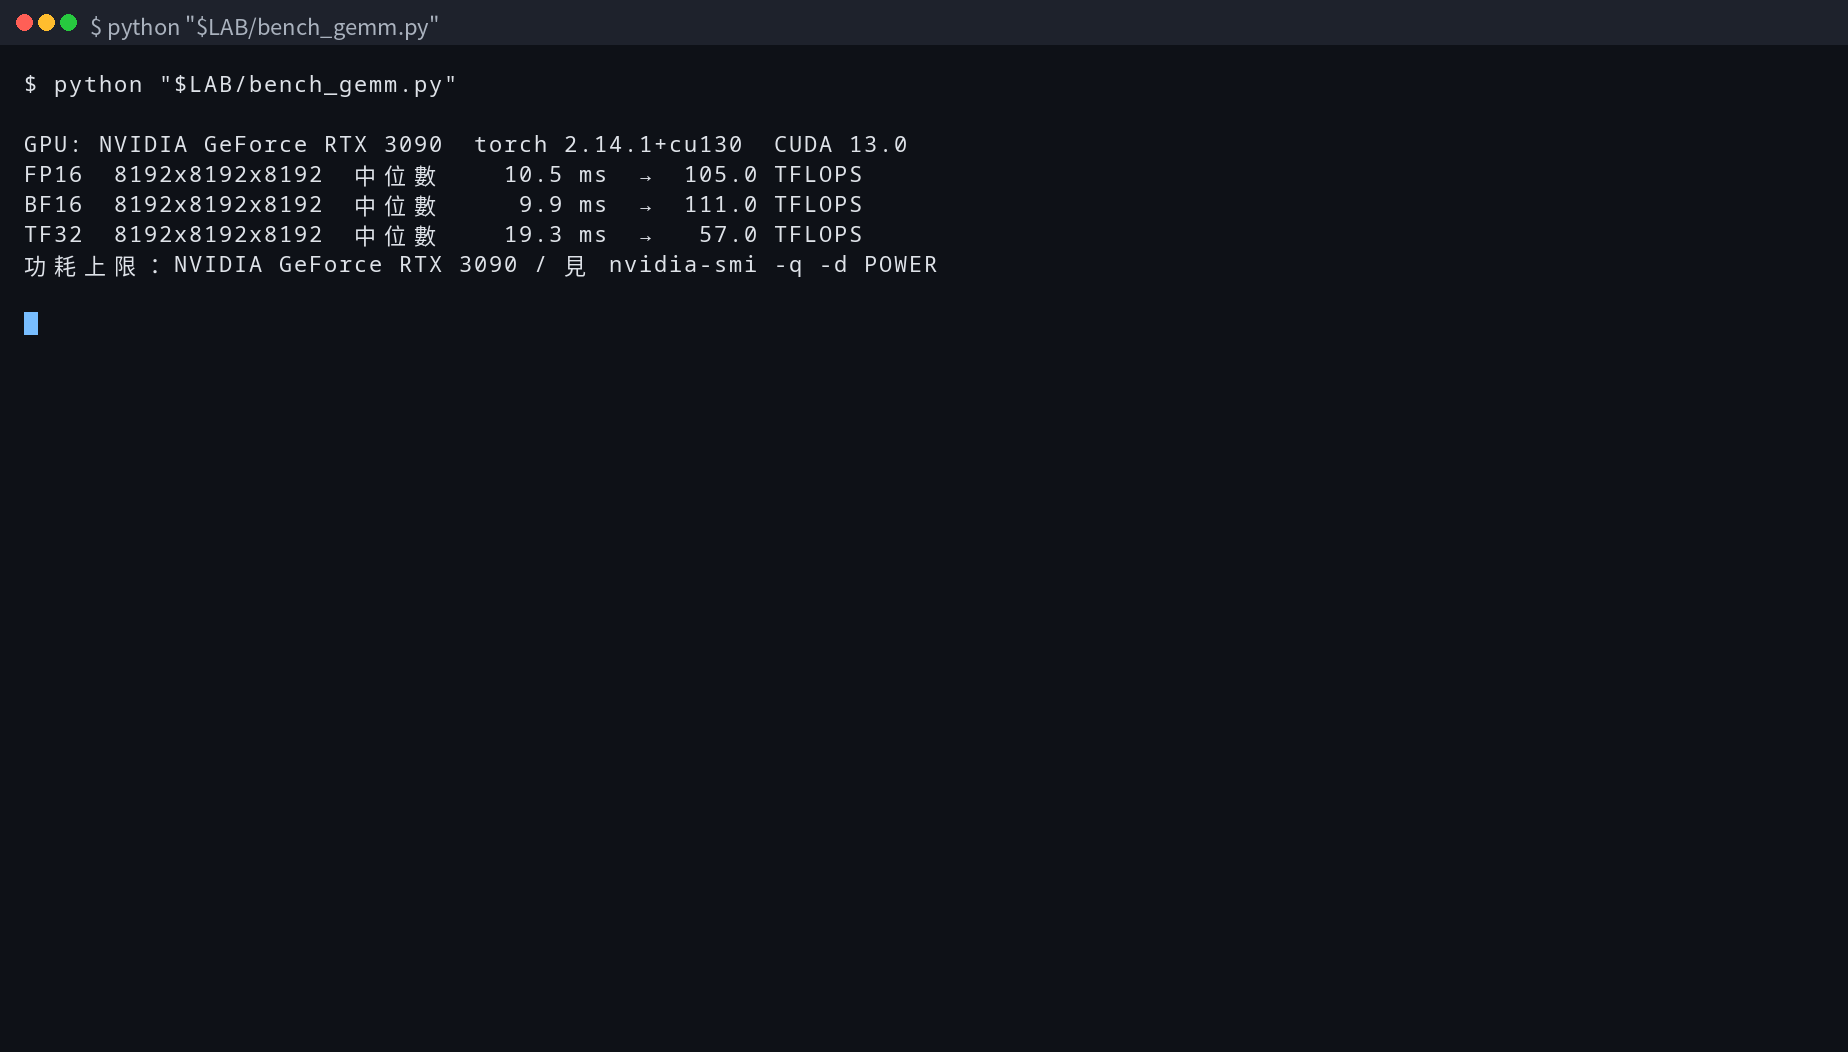
gpu-unlock 讓 RTX 3090 的 BF16 運算速度從 56.1 提升至 111.0 TFLOPS,但 Ubuntu 24.04 預設載入順序會導致失敗,需手動設定 softdep 才能生效。
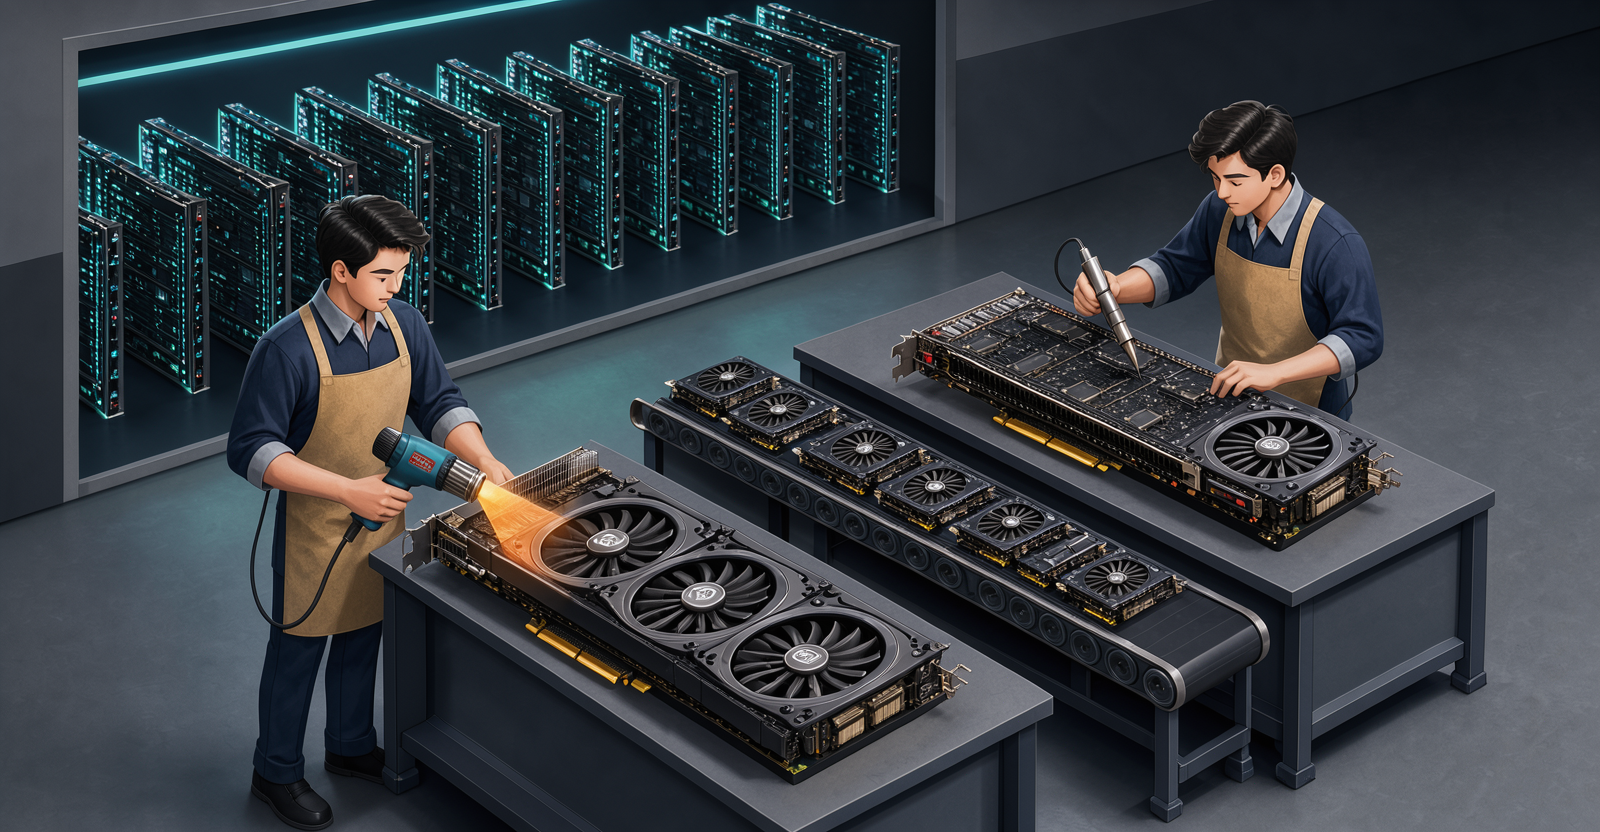
港媒 HKEPC 轉貼的改裝工廠內部影片,顯示全新 RTX 5090 被拆解改裝;工廠所在地與業者身分尚未獨立證實。
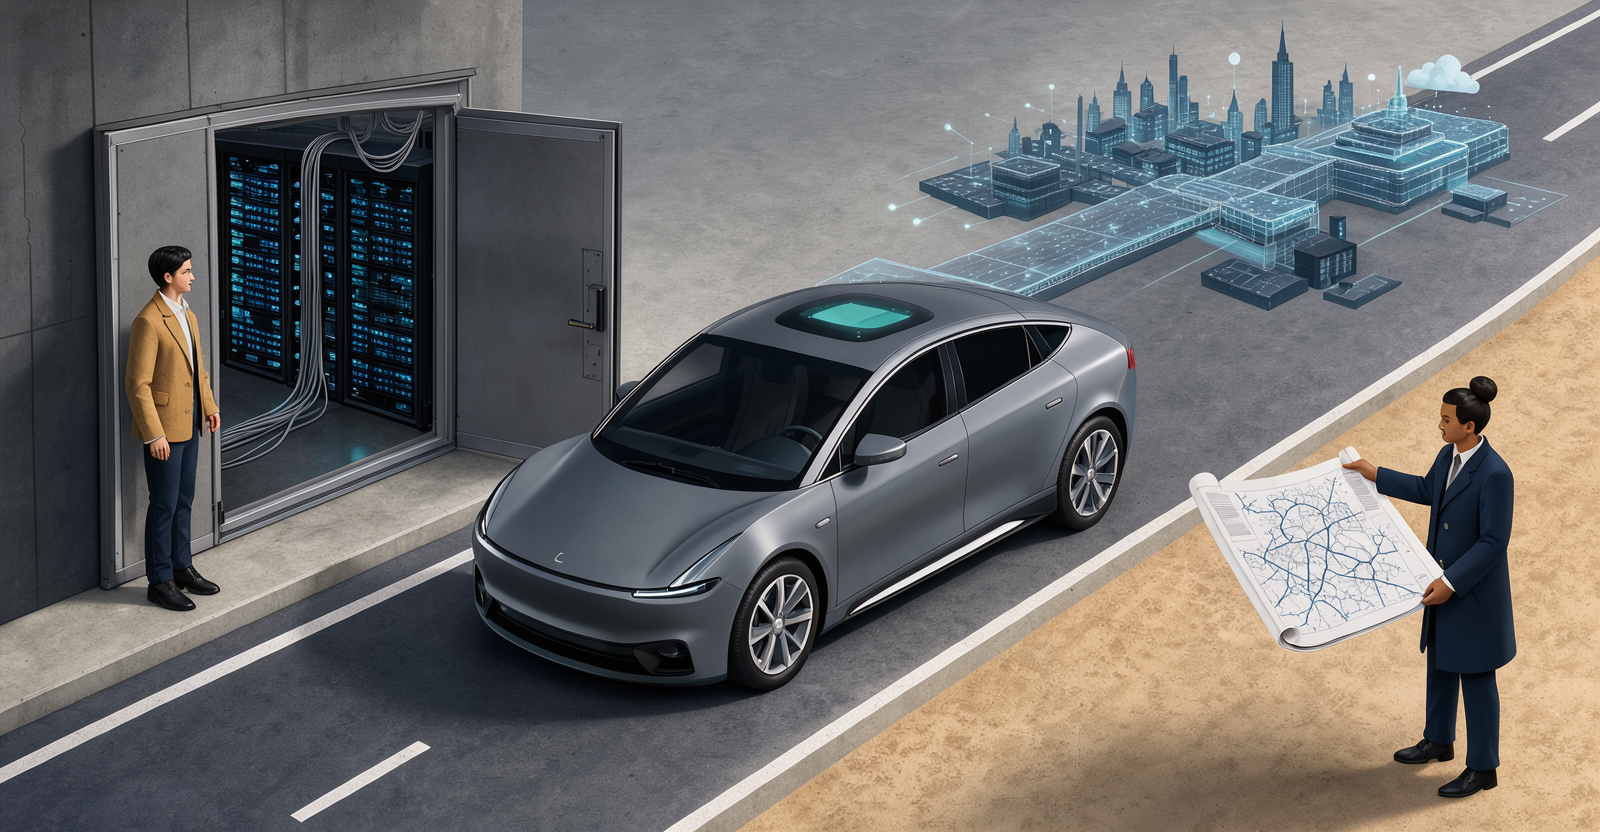
NVIDIA 在 GTC Berlin 宣布,Bolt 選用 Alpamayo Stack,首先搭配 Lucid 未來車款,並計畫 2027 年在馬德里蒐集道路資料。

NVIDIA 展示使用 Hermes、Nemotron 與 Astra 等 AI 代理,結合 Isaac Lab 與 Newton,在模擬環境中訓練 Microduck 機器人通過障礙課程的流程。
Reuters 引述匿名消息人士報導,輝達 RTX PRO 5500 的中國訂單遠高於原先規劃的產量,部分合作夥伴可能只拿到訂購量的 5% 至 10%。
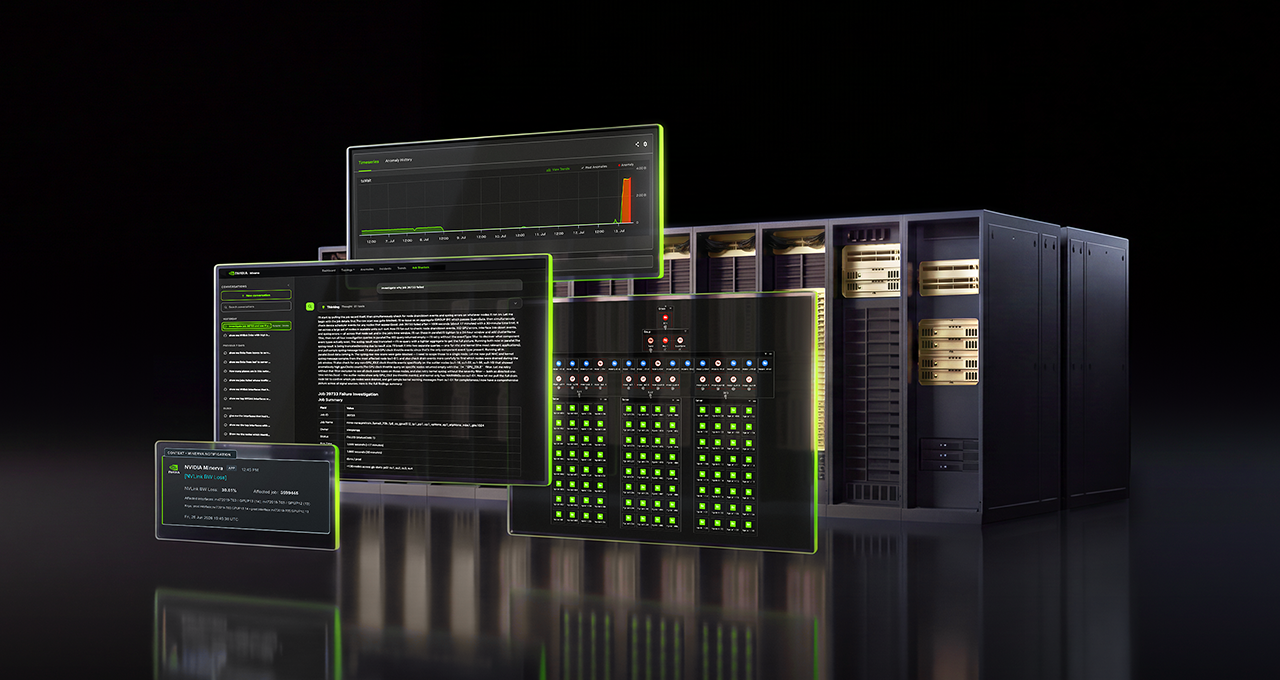
NVIDIA 發布 AIOps 平台 Minerva,透過整合基礎設施與工作負載遙測資料,協助團隊提前發現問題並提升 GPU 利用率。
The Verge 報導,CoreWeave 債券依常見定義已進入不良區間,股價自週二收盤以來下跌超過 20%,並提到 Oracle 股價在同一時間範圍內下跌近 10%。
黃仁勳在彭博專訪中表示,若客戶開發不安全的 AI,輝達會停止供應晶片,但會先與對方談;動區動趨另報導,輝達宣布未來五年捐出價值 2.5 億美元的算力。

Nvidia 利用 Model Optimizer 對 Alibaba 的 Qwen3.8-Flash-Next 進行量化,推出適用於本地硬體的小型化版本。
NVIDIA 推出開放權重的多模態代理模型 Nemotron 3.5 Super VL,並已在 Hugging Face 上架。
NVIDIA 在 OCP Global Summit 透過開放的 MGX 架構,把 Vera Rubin 機架與運算托盤設計貢獻給 OCP,並公布 MGX 1.2 規格與多項網路、供電合作。