全球動態2 個來源10/30 上午01:16
圖:本站依事件資料排版,不是新聞照片
vectorize-io/hindsight 一天新增約 2,349 顆星,主打會學習的代理記憶體
GitHub 專案 vectorize-io/hindsight 截至本站記錄時累計 55,896 顆星,專案說明表示它要讓代理不只記住對話,還能從中學習。
程式自動生成(claude-sonnet-5-5),未經人工審閱。每段附來源,門檻檢查通過後自動上線。
圖:本站依事件資料排版,不是新聞照片
GitHub 專案 vectorize-io/hindsight 截至本站記錄時累計 55,896 顆星,專案說明表示它要讓代理不只記住對話,還能從中學習。
程式自動生成(claude-sonnet-5-5),未經人工審閱。每段附來源,門檻檢查通過後自動上線。
這個 GitHub 開源求職應用依個人檔案為每個職缺撰寫客製化履歷與自傳,截至本站記錄時累計 2,053 顆星。
Ollama 推出 v0.40.12 版本,整合 Liquid AI 的 LFM3 小型模型家族與 d1 決策模型,並針對 Apple 矽晶片上的 Gemma 4 等模型提升提示處理速度。

本站在 RTX A6000 工作站部署開源 AI 編碼代理 opencode,搭配本地 Qwen3.8 模型,成功於 35.4 秒內完成程式碼分析與重構。
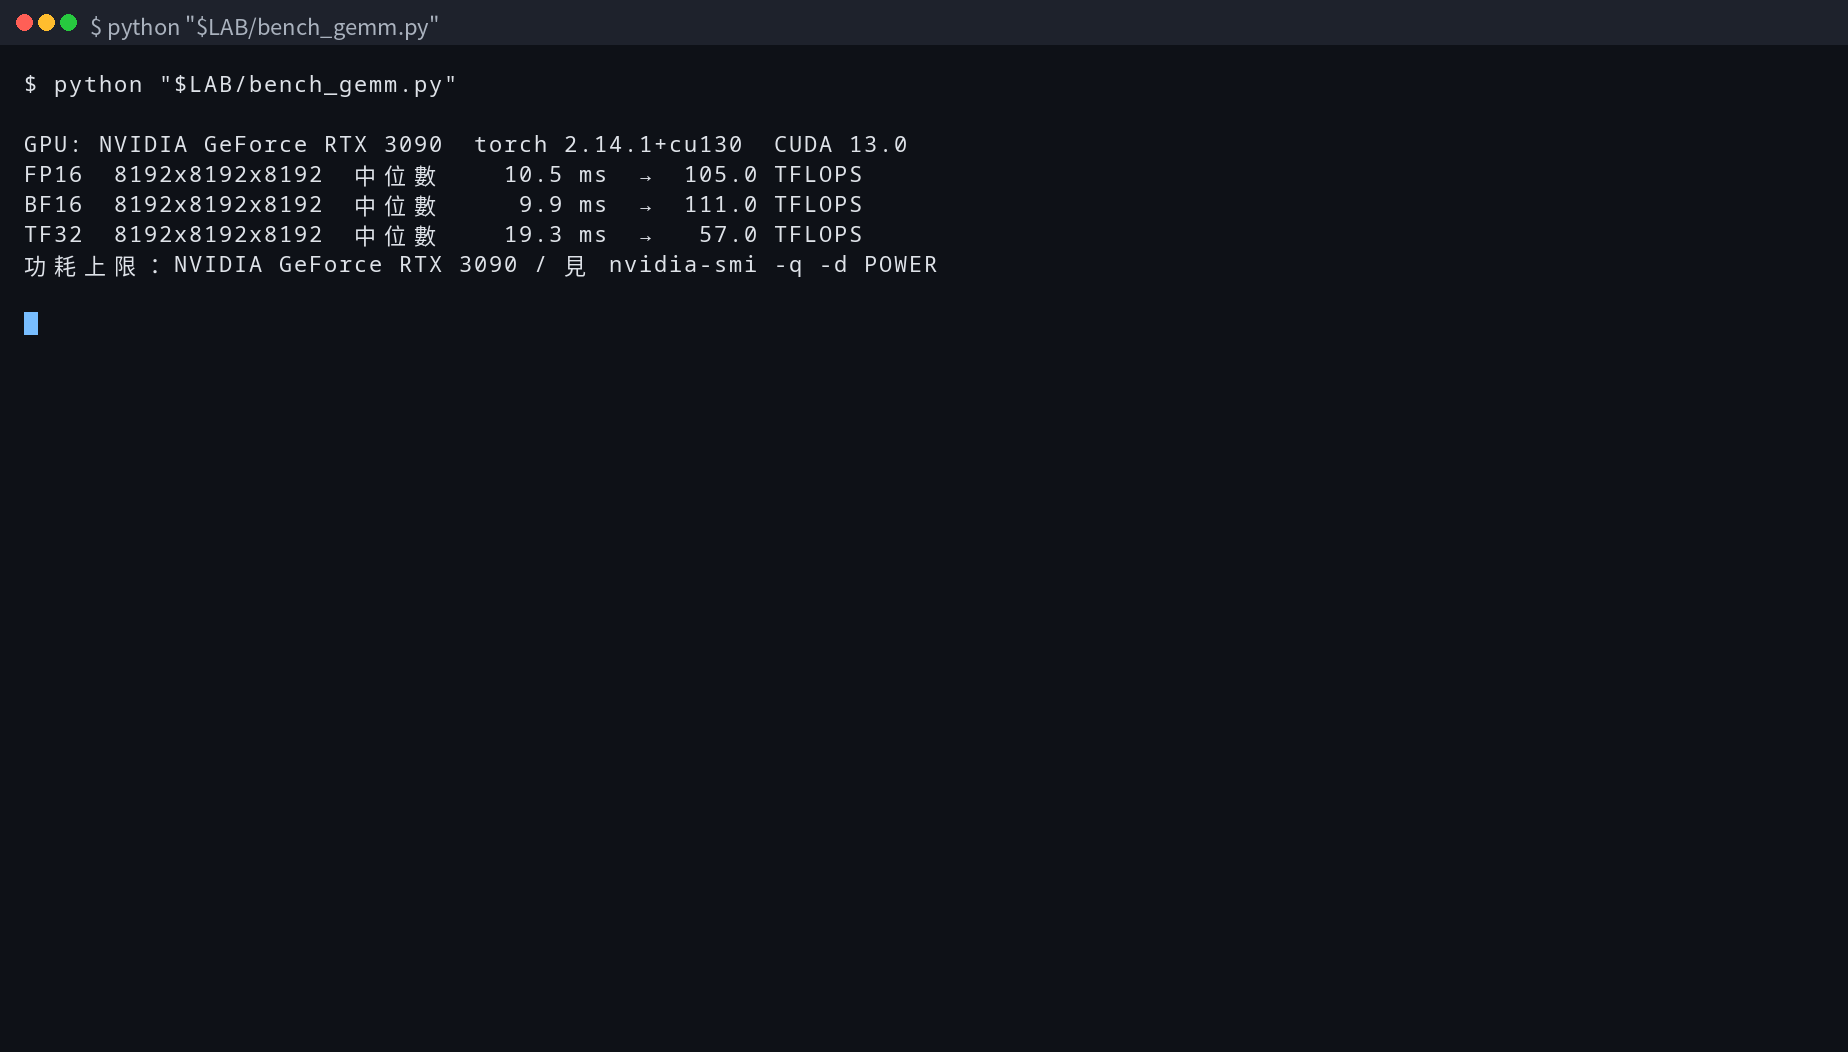
gpu-unlock 讓 RTX 3090 的 BF16 運算速度從 56.1 提升至 111.0 TFLOPS,但 Ubuntu 24.04 預設載入順序會導致失敗,需手動設定 softdep 才能生效。
同一個 27B Q4_K_M 模型,本站實測二手 3090 在 32768 深度內生成都比 A6000 快,代價是 24 GB 上限、溫度與無保固。
約 NT$90,000 的組合跑 qwen3.8:27b Q4_K_M,生成速度高於 GB10、低於 RTX A6000,但連線與並行都有限制。
Ollama v0.40.2 會在背景升級舊版下載的模型,並暫時保留原始檔作為備份,另修正 ollama list 重複顯示的問題。
本站實測在 llama.cpp 上測量 Qwen3.8 Flash Next 的生成速度、提示詞處理、首字延遲與並行表現,並對照不同推論引擎上的全參數啟用模型,看 MoE 架構在單機上的實際差距。
同一模型、同樣用 Ollama 預設設定,從短提示一路測到 32,768 深度與 8 路並行,看兩台機器在地端推論的實際差距。
Ollama v0.40.3 調整了 launch 指令的 claude 與 codex 警告訊息,並暫停背景模型升級。